
感知机详解
1958 年,纽约州布法罗的一家实验室里,一位心理学家展示了一台会学习的机器。没有人告诉它区分两类图像的规则:人们给它看例子,每答错一次,它就把自己的旋钮稍微转动一点。这台机器就是感知机,它是一个人工神经元,配有一条只有几行的学习规则。它并不能学会一切,而它学不会什么的故事,和它能学会什么的故事一样富有启发。

一台会学习的机器
康奈尔航空实验室的心理学家弗兰克·罗森布拉特于 1958 年提出了感知机。他的基础是沃伦·麦卡洛克和沃尔特·皮茨在 1943 年提出的人工神经元:一个把输入相加、总和超过阈值时就发放信号的单元。麦卡洛克和皮茨必须手工设定权重。罗森布拉特的新想法是一条从例子中确定权重的规则。媒体为之兴奋:1958 年 7 月,《纽约时报》报道说,海军期望这台机器有一天能够行走、说话、看东西,并意识到自己的存在。

Mark I 感知机
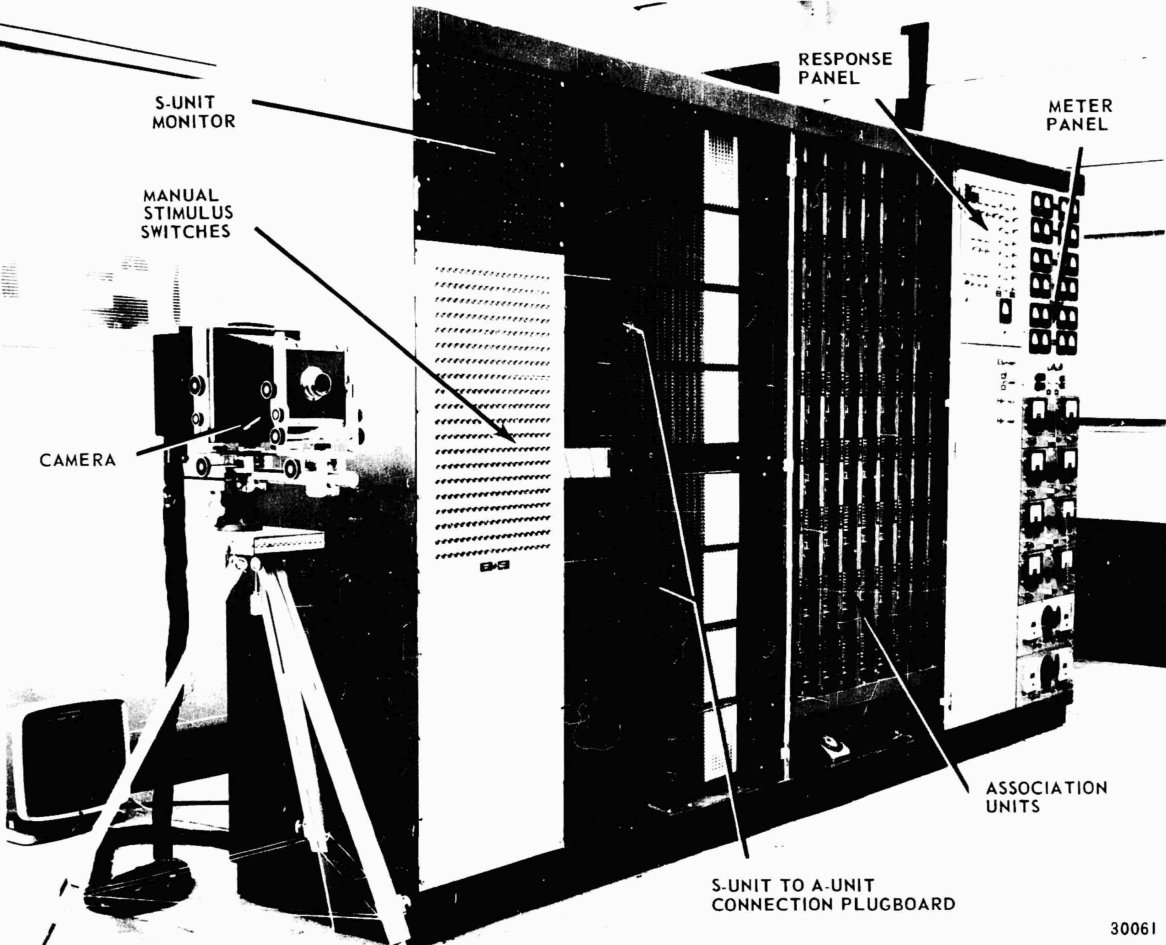
第一个感知机是在 IBM 704 上运行的程序,但罗森布拉特很快就让人把它造成了一台独立的机器。约 1960 年完成的 Mark I 感知机通过一台由 400 个光传感器组成、排成 20 × 20 网格的摄像机观察世界,这些传感器随机地连接到一层联想单元。它的权重是电位器,每次出错时由小电动机转动。它学会了区分简单的形状和字母。这台机器如今收藏在史密森学会的美国国家历史博物馆。
一个神经元,一条直线
有两个输入 x 和 y 的感知机计算 w₁x + w₂y + b,和为正时回答 +1,为负时回答 −1。这个和恰好在直线 w₁x + w₂y + b = 0 上为零,所以神经元把平面分成两个半平面,每种回答各占一个。权重向量 (w₁, w₂) 垂直于这条直线并指向 +1 一侧,偏置 b 让直线离开原点:没有它,每条边界都会经过 (0, 0)。输入更多时,直线变成平面或超平面,但思路不变。把偏置写成一个恒为 1 的额外输入的权重 w₀,这个技巧让同一条规则就能学习所有权重。
学习规则
训练逐个地遍历样本。对每个真实类别为 y 的样本 x,神经元给出回答 ŷ。如果 ŷ 等于 y,什么也不发生。否则,每个权重改变 η·(y − ŷ) 乘以它的输入:w ← w + η·(y − ŷ)·x。对于被答成 −1 的 +1 类点,w 加上 x 的若干倍,这使 w·x 增加 x 长度平方的若干倍,把这个点推向正确的一侧;对于 −1 类点则正好相反。学习率 η 决定步长。对所有样本过一遍就是一个轮次,训练在一轮没有错误之后结束。
收敛定理
如果存在一条直线能分开两个类别,感知机就一定能找到一条。阿尔伯特·诺维科夫在 1962 年证明:如果每个输入的长度至多为 R,而最佳直线以间隔 γ 分开两类,那么无论样本以什么顺序出现,经典规则至多犯 (R/γ)² 次错误。证明比较了两个量:每次错误都让 w 与理想方向多对齐至少 γ,而 w 的长度只按错误次数的平方根增长,所以错误终究会用完。找到的直线只是能分开这些点的众多直线之一,不一定是留出最宽空隙的那条。
明斯基、佩珀特与 XOR
当没有直线能分开两类时,这条规则永远不会稳定下来:每条直线都会分错某个点,而这个点又把直线拉走。最简单的例子是 XOR,即两个输入中恰有一个为真时才为真的函数。在 1969 年出版的《感知机》(Perceptrons)一书中,马文·明斯基和西摩·佩珀特证明了单层感知机既不能计算 XOR,也不能判断一个图形是否连通,并精确分析了它们能计算什么。人们常把 20 世纪 70 年代神经网络研究经费的下降归咎于这本书,尽管两位作者知道多层网络能做得更多。
从感知机到神经网络
对于两层网络,XOR 很容易:一个神经元计算 OR,另一个计算 NAND,第三个用 AND 把它们组合起来。难点在于训练隐藏神经元,因为硬阈值不会提示该把权重往哪个方向转。用 S 型函数(sigmoid)这样的平滑函数代替阶跃函数,使误差变得可微;而由戴维·鲁梅尔哈特、杰弗里·辛顿和罗纳德·威廉姆斯在 1986 年推广的反向传播,能算出每一层的每个权重对误差的贡献。这样的多层感知机变得又深又宽,就是今天的神经网络。对于单层无法分开的数据,斯蒂芬·加兰特 1990 年的口袋算法至少会保留训练中出现过的最好的直线。

亲自探索
打开感知机可视化,用逻辑门 AND、OR 和 NAND,用带有你所选间隔的随机点,或用你自己放置的点来训练感知机。逐个样本地执行学习规则,读出每个权重在更新前后的值,观察直线和权重向量的旋转,并跟踪每轮的错误数。然后试试 XOR 和重叠的点云,看感知机无法收敛,再打开口袋算法。
常见问题
感知机和逻辑回归是一回事吗?
两者都是只有一条直线边界的单个神经元,但学习方式不同。感知机只回答是或否,并且只在出错后才改变权重。逻辑回归把和送进 S 型函数得到一个概率,并在每个样本之后调整权重,让正确答案的可能性更大;因此即使所有点都已在正确一侧,它仍会继续改进,而且在没有直线能分开的数据上也会稳定下来。
感知机为什么需要偏置?
没有偏置时,w₁x + w₂y 在原点处为零,所以每条边界都会经过 (0, 0)。输入为 0 和 1 的 AND 门和 OR 门需要一条不经过原点的直线:例如对于 AND,4x + 2y − 5 = 0 就把 (1, 1) 与其余三个角分开。偏置和其他权重一样被学习,它是一个恒为 1 的输入的权重。
感知机会找到哪条直线?
任意一条能分开这些点的直线,取决于初始权重和样本的顺序。它一旦没有错误就停止,所以这条直线常常贴近某些点。支持向量机则寻找间隔最宽的直线,而约阿夫·弗罗因德和罗伯特·夏皮尔提出的投票感知机和平均感知机,会把训练中出现过的直线组合起来,以获得更好的泛化能力。
什么是多层感知机?
一种把神经元分层排列的网络,每一层的输出就是下一层的输入。用平滑的激活函数代替硬阈值后,它可以用反向传播和梯度下降来训练。只要神经元足够多,单个隐藏层就能在有界区域上逼近任何连续函数,而两个隐藏神经元就已经能解决 XOR。
相关工具
感知机可视化
在浏览器中训练罗森布拉特的感知机:逐个样本地走过学习规则,观察决策边界和权重向量的移动,看看为什么 AND 和 OR 能学会,而 XOR 永远学不会。

神经网络沙盒
实时训练一个小型神经网络,看它把两类点分开。调整层数、神经元、激活函数、学习率和输入,看看每个神经元对什么有反应。
遗传算法演练场
看火箭如何进化,绕过墙壁飞向目标。调整种群规模、变异率、寿命和选择方式,画出你自己的障碍,并追踪每一代有多少火箭到达。

矩阵计算器
免费在线矩阵计算器:对最大 6x6 的矩阵进行加、减、乘、转置和求逆,并计算行列式、秩和幂,结果为精确分数。

函数绘图器
免费在线函数绘图器:在交互式坐标网格上绘制 x²、sin x、ln x、1/x 和你自己的公式。可平移、缩放、读取 x 和 y,并将图像保存为 PNG。
准备好尝试了吗?
在浏览器中打开 PictorX — 无需安装,无需信用卡即可启动。
打开感知机可视化