
Perceptronen förklarad
År 1958 visade en psykolog på ett laboratorium i Buffalo i delstaten New York upp en maskin som lärde sig. Ingen talade om för den regeln för att skilja två sorters bilder åt: den fick se exempel, och efter varje felaktigt svar vred den lite på sina egna rattar. Den maskinen, perceptronen, är en enda artificiell neuron med en inlärningsregel på några rader. Den kan inte lära sig allt, och historien om det den inte kan lära sig är lika lärorik som historien om det den kan.

En maskin som lär sig
Frank Rosenblatt, psykolog vid Cornell Aeronautical Laboratory, beskrev perceptronen 1958. Han byggde på den artificiella neuron som Warren McCulloch och Walter Pitts hade föreslagit 1943: en enhet som summerar sina indata och fyrar av när summan passerar en tröskel. McCulloch och Pitts var tvungna att ställa in vikterna för hand. Rosenblatts nya idé var en regel som bestämde dem utifrån exempel. Pressen var förtjust: i juli 1958 rapporterade New York Times att flottan väntade sig att maskinen en dag skulle kunna gå, tala, se och vara medveten om sin egen existens.

Mark I Perceptron
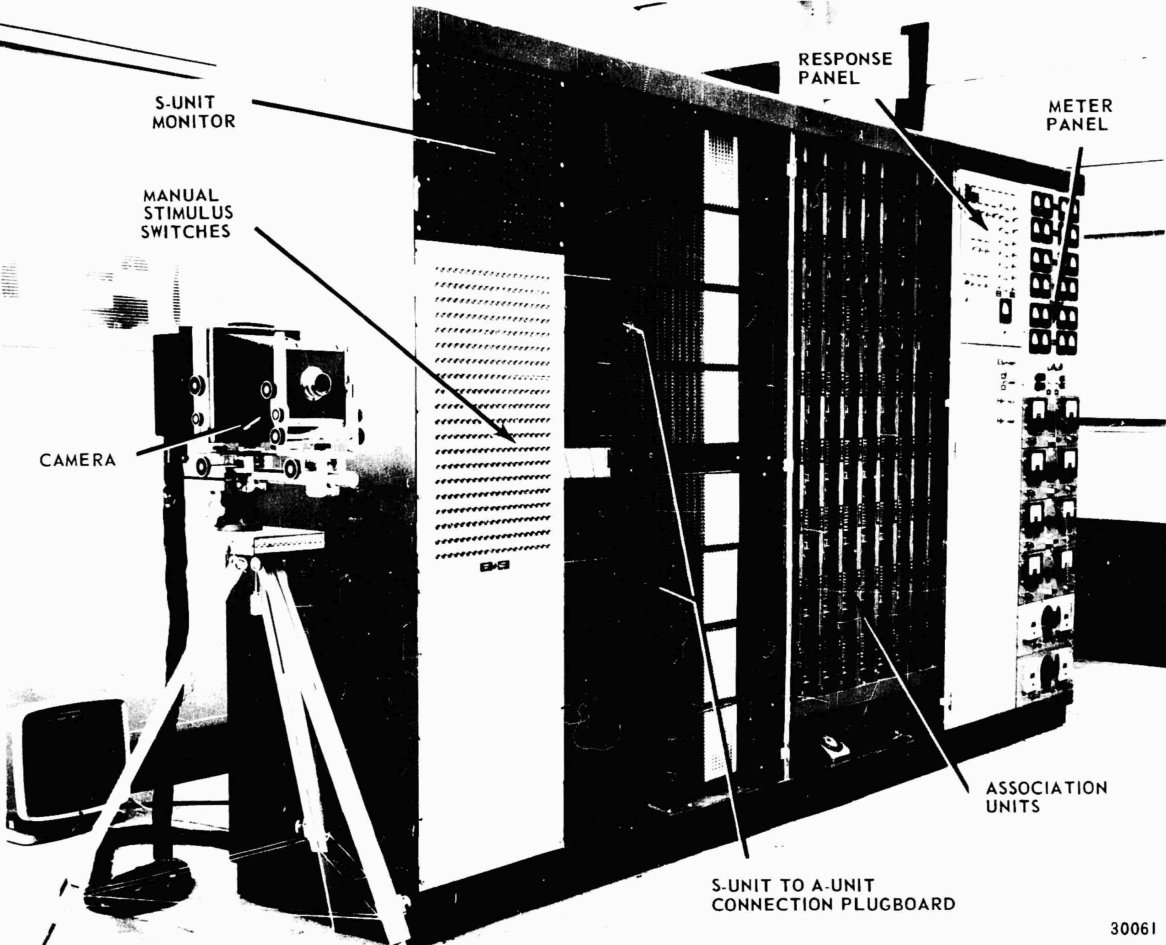
Den första perceptronen kördes som ett program på en IBM 704, men Rosenblatt lät snart bygga den som en egen maskin. Mark I Perceptron, färdig omkring 1960, såg världen genom en kamera med 400 ljussensorer i ett rutnät på 20 gånger 20, slumpmässigt kopplade till ett lager av associationsenheter. Dess vikter var potentiometrar som vreds av små elmotorer varje gång den gjorde fel. Den lärde sig skilja enkla former och bokstäver åt. Maskinen finns i dag på Smithsonians National Museum of American History.
En neuron, en rät linje
En perceptron med två indata x och y beräknar w₁x + w₂y + b och svarar +1 om summan är positiv och −1 om den är negativ. Summan är noll exakt på linjen w₁x + w₂y + b = 0, så neuronen delar planet i två halvplan, ett för varje svar. Viktvektorn (w₁, w₂) står vinkelrätt mot linjen och pekar in i +1-sidan, och biasen b flyttar linjen bort från origo: utan den skulle varje gräns gå genom (0, 0). Med fler indata blir linjen ett plan eller hyperplan, men idén är densamma. Tricket att skriva biasen som en vikt w₀ på en extra indata som alltid är 1 låter en enda regel lära sig alla vikter.
Inlärningsregeln
Träningen går igenom exemplen ett i taget. För varje exempel x med sann klass y ger neuronen sitt svar ŷ. Om ŷ är lika med y händer ingenting. Annars ändras varje vikt med η·(y − ŷ) gånger sin indata: w ← w + η·(y − ŷ)·x. För en +1-punkt som fick svaret −1 läggs en multipel av x till w, vilket höjer w·x med en multipel av x:s längd i kvadrat och knuffar punkten mot rätt sida; för en −1-punkt händer motsatsen. Inlärningshastigheten η bestämmer stegets storlek. Ett varv genom alla exempel är en epok, och träningen slutar efter ett varv utan fel.
Konvergenssatsen
Om någon rät linje skiljer de två klasserna åt hittar perceptronen garanterat en. Albert Novikoff bevisade 1962 att om varje indata har längd högst R och den bästa linjen skiljer klasserna åt med marginalen γ, så gör den klassiska regeln högst (R/γ)² fel, oavsett i vilken ordning exemplen kommer. Beviset jämför två storheter: varje fel riktar w lite mer mot den ideala riktningen, med minst γ, medan längden på w bara växer som kvadratroten ur antalet fel, så felen måste ta slut. Linjen den hittar är bara en av många som skiljer punkterna åt, inte nödvändigtvis den med bredast mellanrum.
Minsky, Papert och XOR
När ingen rät linje skiljer klasserna åt kommer regeln aldrig till ro: varje linje felklassificerar någon punkt, och den punkten drar linjen bort igen. Det enklaste exemplet är XOR, funktionen som är sann när exakt en av dess två indata är sann. I boken Perceptrons från 1969 bevisade Marvin Minsky och Seymour Papert att enlagersperceptroner varken kan beräkna XOR eller avgöra om en figur är sammanhängande, och de analyserade exakt vad de kan beräkna. Boken får ofta skulden för att anslagen till forskning om neurala nätverk minskade på 1970-talet, trots att författarna visste att nätverk med fler lager kunde mer.
Från perceptroner till neurala nätverk
För två lager är XOR enkelt: en neuron beräknar OR, en annan NAND, och en tredje kombinerar dem med AND. Problemet var att träna de dolda neuronerna, eftersom en skarp tröskel inte ger någon ledtråd om åt vilket håll en vikt ska vridas. När stegfunktionen ersattes av en mjuk funktion som sigmoiden blev felet deriverbart, och bakåtpropagering, populariserad 1986 av David Rumelhart, Geoffrey Hinton och Ronald Williams, beräknar hur mycket varje vikt i varje lager bidrar till felet. Sådana flerlagersperceptroner, numera djupa och breda, är dagens neurala nätverk. För data som ett lager inte kan skilja åt sparar Stephen Gallants fickalgoritm från 1990 åtminstone den bästa linje som dök upp under träningen.

Utforska själv
Öppna perceptronvisualiseringen för att träna en perceptron på de logiska grindarna AND, OR och NAND, på slumpmässiga punkter med valfri marginal eller på punkter du själv placerar. Gå igenom inlärningsregeln ett exempel i taget och läs av varje vikt före och efter uppdateringen, se linjen och viktvektorn vrida sig och följ felen per epok. Prova sedan XOR och de överlappande molnen, se perceptronen misslyckas med att konvergera och slå på fickalgoritmen.
Ofta ställda frågor
Är en perceptron samma sak som logistisk regression?
Båda är en enda neuron med en rak gräns, men de lär sig på olika sätt. Perceptronen svarar bara ja eller nej och ändrar bara sina vikter efter ett fel. Logistisk regression skickar summan genom en sigmoid för att få en sannolikhet och justerar sina vikter efter varje exempel för att göra de rätta svaren mer sannolika; den fortsätter därför att förbättras även när alla punkter redan ligger på rätt sida, och den kommer också till ro på data som ingen linje skiljer åt.
Varför behöver en perceptron en bias?
Utan bias är w₁x + w₂y noll i origo, så varje gräns skulle gå genom (0, 0). Grindarna AND och OR med indata 0 och 1 behöver en linje som går förbi origo: för AND skiljer till exempel 4x + 2y − 5 = 0 punkten (1, 1) från de tre andra hörnen. Biasen lärs in som vilken annan vikt som helst, som vikten för en indata som alltid är 1.
Vilken linje hittar perceptronen?
Vilken linje som helst som skiljer punkterna åt, beroende på startvikterna och exemplens ordning. Den stannar så fort det inte finns några fel kvar, så linjen går ofta nära vissa punkter. Stödvektormaskiner letar i stället efter linjen med bredast marginal, och Yoav Freunds och Robert Schapires voted och averaged perceptron kombinerar linjerna från träningen för att generalisera bättre.
Vad är en flerlagersperceptron?
Ett nätverk av neuroner i lager, där varje lagers utdata är nästa lagers indata. Med en mjuk aktiveringsfunktion i stället för en skarp tröskel kan det tränas med bakåtpropagering och gradientnedstigning. Ett enda dolt lager med tillräckligt många neuroner kan approximera varje kontinuerlig funktion på ett begränsat område, och två dolda neuroner löser redan XOR.
Relaterade verktyg
Perceptronvisualisering
Träna Rosenblatts perceptron i webbläsaren: gå igenom inlärningsregeln ett exempel i taget, se beslutsgränsen och viktvektorn röra sig och se varför AND och OR lärs in men XOR aldrig.

Sandlåda för neurala nätverk
Träna ett litet neuralt nätverk live och se det skilja två klasser av punkter åt. Ändra lager, neuroner, aktivering, inlärningshastighet och indata, och se vad varje neuron reagerar på.
Lekplats för genetiska algoritmer
Se raketer utvecklas för att nå ett mål runt väggar. Ändra population, mutationsgrad, livslängd och urval, rita egna hinder och följ hur många som kommer fram i varje generation.

Matrisräknare
Gratis matrisräknare online: addera, subtrahera, multiplicera, transponera och invertera matriser upp till 6x6, med determinant, rang, potenser och exakta bråk.

Funktionsritare
En gratis funktionsritare online: rita x², sin x, ln x, 1/x och egna formler i ett interaktivt koordinatsystem. Panorera, zooma, läs av x och y och spara grafen som PNG.
Redo att prova det?
Öppna PictorX i din webbläsare - ingen installation, inget kreditkort krävs för att starta.
Öppna perceptronvisualiseringen