
El perceptrón explicado
En 1958, un psicólogo presentó en un laboratorio de Buffalo, en el estado de Nueva York, una máquina que aprendía. Nadie le decía la regla para distinguir dos tipos de imágenes: se le mostraban ejemplos y, tras cada respuesta equivocada, giraba un poco sus propios mandos. Esa máquina, el perceptrón, es una sola neurona artificial con una regla de aprendizaje de pocas líneas. No puede aprenderlo todo, y la historia de lo que no puede aprender es tan instructiva como la de lo que sí puede.

Una máquina que aprende
Frank Rosenblatt, psicólogo del Cornell Aeronautical Laboratory, describió el perceptrón en 1958. Partía de la neurona artificial que Warren McCulloch y Walter Pitts habían propuesto en 1943: una unidad que suma sus entradas y se dispara cuando el total supera un umbral. McCulloch y Pitts tenían que fijar los pesos a mano. La idea nueva de Rosenblatt fue una regla que los ajustaba a partir de ejemplos. La prensa se entusiasmó: en julio de 1958, The New York Times informó de que la Marina esperaba que la máquina pudiera algún día andar, hablar, ver y ser consciente de su propia existencia.

El Mark I Perceptron
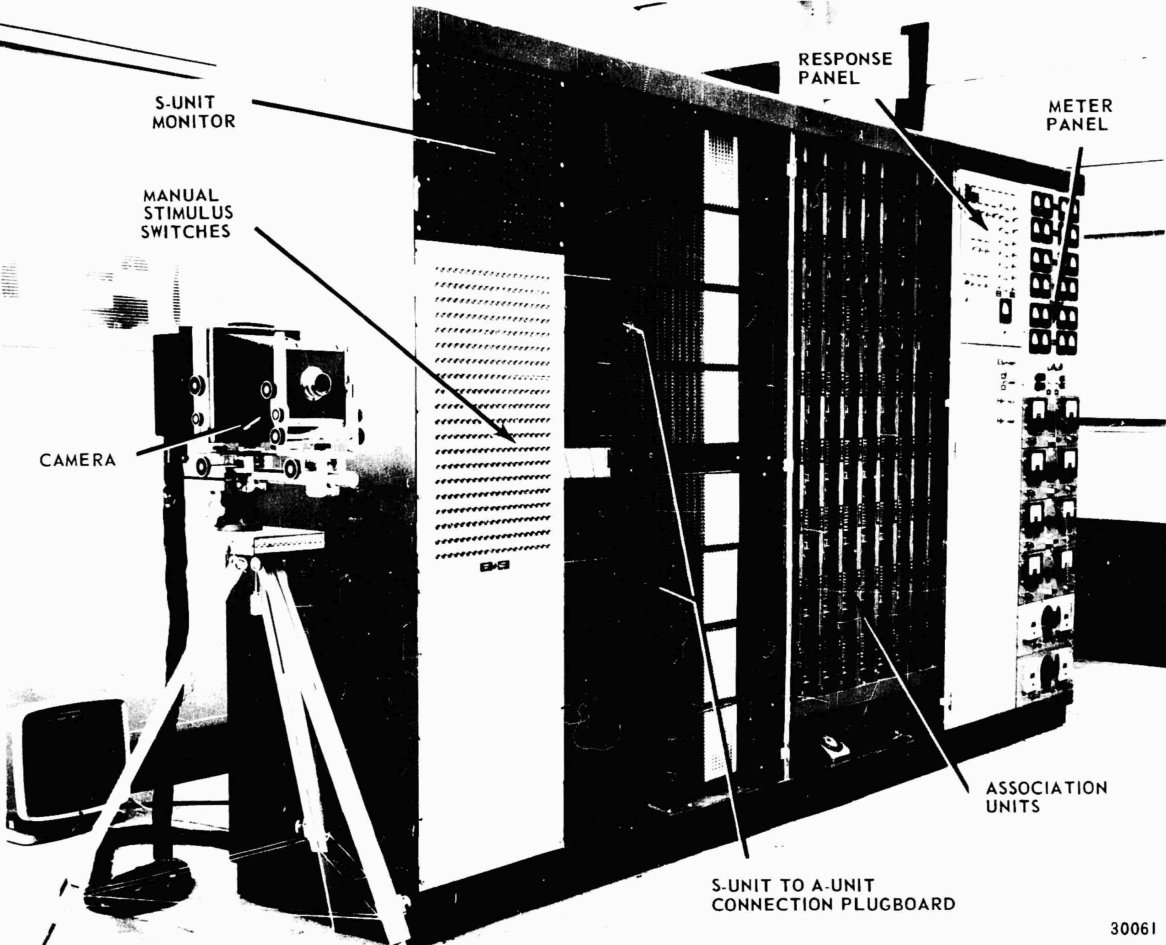
El primer perceptrón funcionaba como programa en un IBM 704, pero Rosenblatt pronto lo hizo construir como una máquina propia. El Mark I Perceptron, terminado hacia 1960, veía el mundo a través de una cámara de 400 sensores de luz en una cuadrícula de 20 por 20, conectados al azar a una capa de unidades de asociación. Sus pesos eran potenciómetros que unos pequeños motores eléctricos giraban cada vez que se equivocaba. Aprendió a distinguir formas y letras sencillas. Hoy la máquina se conserva en el National Museum of American History de la Smithsonian Institution.
Una neurona, una recta
Un perceptrón con dos entradas x e y calcula w₁x + w₂y + b y responde +1 si esa suma es positiva y −1 si es negativa. La suma vale cero justo sobre la recta w₁x + w₂y + b = 0, así que la neurona divide el plano en dos semiplanos, uno para cada respuesta. El vector de pesos (w₁, w₂) es perpendicular a la recta y apunta hacia el lado +1, y el sesgo b aleja la recta del origen: sin él, toda frontera pasaría por (0, 0). Con más entradas, la recta se convierte en un plano o un hiperplano, pero la idea es la misma. El truco de escribir el sesgo como un peso w₀ sobre una entrada extra que siempre vale 1 permite que una sola regla aprenda todos los pesos.
La regla de aprendizaje
El entrenamiento recorre los ejemplos uno a uno. Para cada ejemplo x de clase verdadera y, la neurona da su respuesta ŷ. Si ŷ es igual a y, no pasa nada. Si no, cada peso cambia en η·(y − ŷ) veces su entrada: w ← w + η·(y − ŷ)·x. Para un punto +1 al que se respondió −1, se suma a w un múltiplo de x, lo que aumenta w·x en un múltiplo del cuadrado de la longitud de x y empuja el punto hacia el lado correcto; para un punto −1 ocurre lo contrario. La tasa de aprendizaje η fija el tamaño del paso. Una pasada por todos los ejemplos es una época, y el entrenamiento termina tras una pasada sin errores.
El teorema de convergencia
Si alguna recta separa las dos clases, el perceptrón tiene garantizado encontrar una. Albert Novikoff demostró en 1962 que, si cada entrada tiene una longitud de como mucho R y la mejor recta separa las clases con un margen γ, la regla clásica comete como mucho (R/γ)² errores, sea cual sea el orden de los ejemplos. La demostración compara dos cantidades: cada error alinea un poco más w con la dirección ideal, al menos en γ, mientras que la longitud de w solo crece como la raíz cuadrada del número de errores, así que los errores tienen que acabarse. La recta que encuentra es solo una de las muchas que separan los puntos, no necesariamente la que deja el hueco más ancho.
Minsky, Papert y XOR
Cuando ninguna recta separa las clases, la regla nunca se estabiliza: cada recta clasifica mal algún punto, y ese punto vuelve a arrastrarla. El ejemplo más sencillo es XOR, la función que es verdadera cuando exactamente una de sus dos entradas lo es. En su libro Perceptrons, de 1969, Marvin Minsky y Seymour Papert demostraron que los perceptrones de una capa no pueden calcular XOR ni saber si una figura es conexa, y analizaron con precisión lo que sí pueden calcular. A menudo se culpa al libro de la caída de la financiación de la investigación en redes neuronales en los años setenta, aunque sus autores sabían que las redes con más capas podían hacer más.
De los perceptrones a las redes neuronales
Para dos capas, XOR es fácil: una neurona calcula OR, otra NAND, y una tercera las combina con AND. El problema era entrenar las neuronas ocultas, porque un umbral brusco no da ninguna pista de hacia dónde girar un peso. Sustituir el escalón por una función suave como la sigmoide hizo que el error fuera derivable, y la retropropagación, popularizada en 1986 por David Rumelhart, Geoffrey Hinton y Ronald Williams, calcula cuánto contribuye al error cada peso de cada capa. Esos perceptrones multicapa, ahora profundos y anchos, son las redes neuronales de hoy. Para datos que una sola capa no puede separar, el algoritmo del bolsillo de Stephen Gallant, de 1990, al menos guarda la mejor recta vista durante el entrenamiento.

Explóralo
Abre el visualizador del perceptrón para entrenar un perceptrón con las puertas lógicas AND, OR y NAND, con puntos aleatorios y el margen que quieras, o con puntos que pongas tú. Recorre la regla de aprendizaje ejemplo a ejemplo y lee cada peso antes y después de la actualización, mira cómo giran la recta y el vector de pesos y sigue los errores por época. Después prueba XOR y las nubes solapadas, mira cómo el perceptrón no logra converger y activa el algoritmo del bolsillo.
Preguntas frecuentes
¿Un perceptrón es lo mismo que una regresión logística?
Ambos son una sola neurona con una frontera recta, pero aprenden de forma distinta. El perceptrón solo responde sí o no y solo cambia sus pesos tras un error. La regresión logística pasa la suma por una sigmoide para obtener una probabilidad y ajusta sus pesos tras cada ejemplo para hacer más probables las respuestas correctas; así sigue mejorando aunque todos los puntos ya estén en el lado correcto, y también se estabiliza con datos que ninguna recta separa.
¿Por qué necesita un perceptrón un sesgo?
Sin sesgo, w₁x + w₂y vale cero en el origen, así que toda frontera pasaría por (0, 0). Las puertas AND y OR con las entradas 0 y 1 necesitan una recta que no pase por el origen: para AND, por ejemplo, 4x + 2y − 5 = 0 separa (1, 1) de las otras tres esquinas. El sesgo se aprende como cualquier otro peso, como el peso de una entrada que siempre vale 1.
¿Qué recta encuentra el perceptrón?
Cualquier recta que separe los puntos, según los pesos iniciales y el orden de los ejemplos. Se detiene en cuanto no hay errores, así que la recta suele pasar cerca de algunos puntos. Las máquinas de vectores de soporte buscan en cambio la recta con el margen más ancho, y los perceptrones votado y promediado de Yoav Freund y Robert Schapire combinan las rectas vistas durante el entrenamiento para generalizar mejor.
¿Qué es un perceptrón multicapa?
Una red de neuronas en capas, en la que las salidas de cada capa son las entradas de la siguiente. Con una función de activación suave en lugar de un umbral brusco, se puede entrenar con retropropagación y descenso del gradiente. Una sola capa oculta con suficientes neuronas puede aproximar cualquier función continua en una región acotada, y dos neuronas ocultas ya resuelven XOR.
Herramientas relacionadas
Visualizador del perceptrón
Entrena el perceptrón de Rosenblatt en tu navegador: recorre la regla de aprendizaje ejemplo a ejemplo, mira cómo se mueven la frontera de decisión y el vector de pesos, y descubre por qué AND y OR se aprenden pero XOR nunca.

Simulador de redes neuronales
Entrena en directo una pequeña red neuronal y observa cómo separa dos clases de puntos. Cambia las capas, las neuronas, la activación, la tasa de aprendizaje y las entradas, y mira a qué responde cada neurona.
Laboratorio de algoritmos genéticos
Observa cómo unos cohetes evolucionan hasta alcanzar un objetivo rodeando muros. Cambia la población, la tasa de mutación, la duración de vida y la selección, dibuja tus propios obstáculos y sigue cuántos llegan en cada generación.

Calculadora de matrices
Calculadora de matrices online gratuita: suma, resta, multiplica, traspone e invierte matrices de hasta 6x6, con determinante, rango, potencias y fracciones exactas.

Graficador de funciones
Un graficador de funciones en línea gratuito: dibuja x², sin x, ln x, 1/x y tus propias fórmulas en una cuadrícula interactiva. Desplaza, haz zoom, lee x e y y guarda la gráfica en PNG.
¿Listo para probarlo?
Abre PictorX en tu navegador: sin instalación ni tarjeta de crédito para empezar.
Abrir el visualizador del perceptrón