
Perceptronen forklaret
I 1958 viste en psykolog på et laboratorium i Buffalo i staten New York en maskine, der lærte. Ingen fortalte den reglen for at skelne mellem to slags billeder: Den fik vist eksempler, og efter hvert forkert svar drejede den lidt på sine egne knapper. Den maskine, perceptronen, er én kunstig neuron med en læringsregel på få linjer. Den kan ikke lære alt, og historien om det, den ikke kan lære, er lige så lærerig som historien om det, den kan.

En maskine, der lærer
Frank Rosenblatt, psykolog ved Cornell Aeronautical Laboratory, beskrev perceptronen i 1958. Han byggede på den kunstige neuron, som Warren McCulloch og Walter Pitts havde foreslået i 1943: en enhed, der lægger sine input sammen og fyrer, når summen overstiger en tærskel. McCulloch og Pitts måtte indstille vægtene i hånden. Rosenblatts nye idé var en regel, der fandt dem ud fra eksempler. Pressen var begejstret: I juli 1958 skrev New York Times, at flåden forventede, at maskinen en dag ville kunne gå, tale, se og være bevidst om sin egen eksistens.

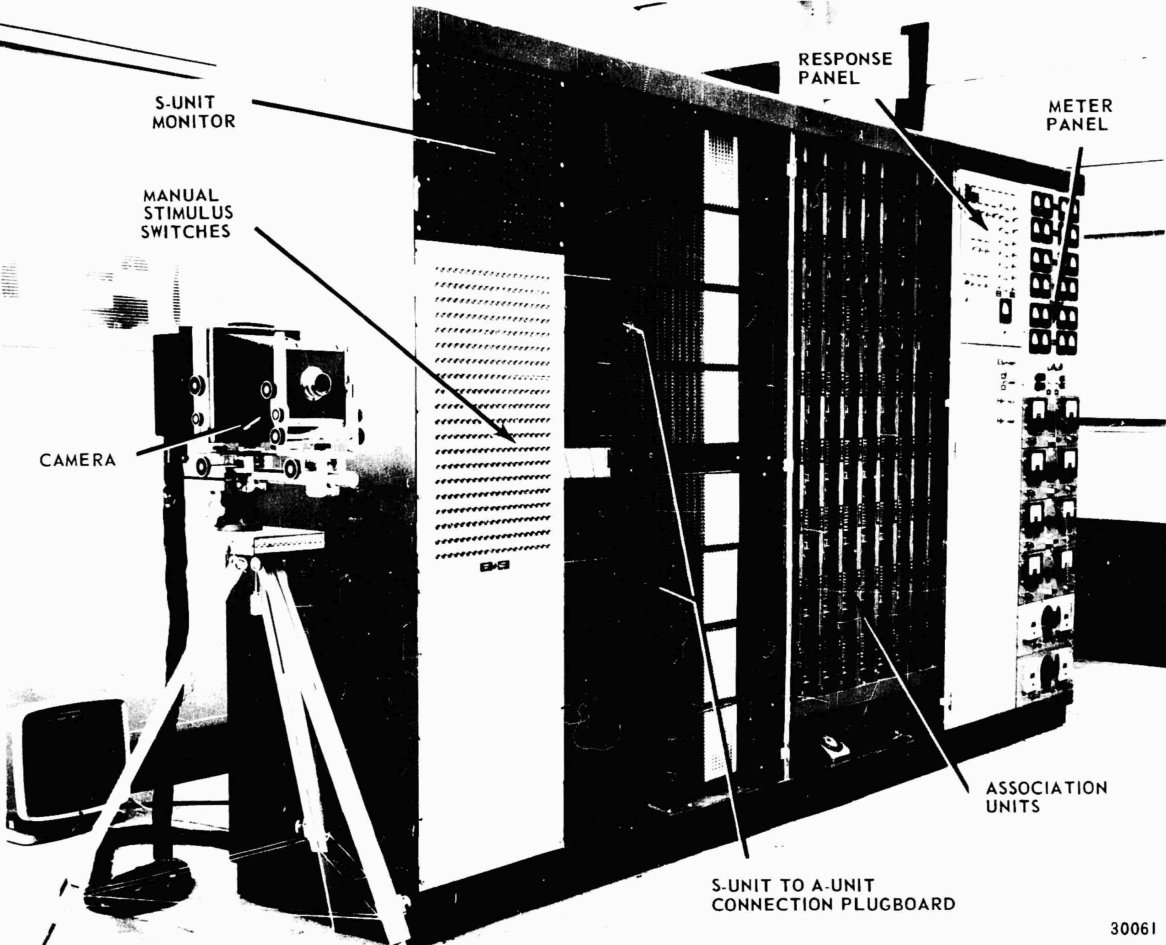
Mark I Perceptron
Den første perceptron kørte som et program på en IBM 704, men Rosenblatt fik den snart bygget som en selvstændig maskine. Mark I Perceptron, færdig omkring 1960, så verden gennem et kamera med 400 lyssensorer i et gitter på 20 gange 20, tilfældigt forbundet til et lag af associationsenheder. Dens vægte var potentiometre, som små elmotorer drejede, hver gang den lavede en fejl. Den lærte at skelne simple former og bogstaver fra hinanden. Maskinen opbevares i dag på Smithsonians National Museum of American History.
Én neuron, én ret linje
En perceptron med to input x og y beregner w₁x + w₂y + b og svarer +1, hvis summen er positiv, og −1, hvis den er negativ. Summen er nul præcis på linjen w₁x + w₂y + b = 0, så neuronen deler planen i to halvplaner, én for hvert svar. Vægtvektoren (w₁, w₂) står vinkelret på linjen og peger ind i +1-siden, og bias b flytter linjen væk fra origo: Uden den ville enhver grænse gå gennem (0, 0). Med flere input bliver linjen til en plan eller hyperplan, men idéen er den samme. Tricket med at skrive bias som en vægt w₀ på et ekstra input, der altid er 1, lader én regel lære alle vægtene.
Læringsreglen
Træningen går eksemplerne igennem ét ad gangen. For hvert eksempel x med den sande klasse y giver neuronen sit svar ŷ. Hvis ŷ er lig med y, sker der intet. Ellers ændres hver vægt med η·(y − ŷ) gange sit input: w ← w + η·(y − ŷ)·x. For et +1-punkt, der fik svaret −1, lægges et multiplum af x til w, hvilket hæver w·x med et multiplum af x's længde i anden og skubber punktet mod den rigtige side; for et −1-punkt sker det modsatte. Læringsraten η bestemmer skridtets størrelse. Én gennemgang af alle eksempler er en epoke, og træningen slutter efter en gennemgang uden fejl.
Konvergenssætningen
Hvis en ret linje adskiller de to klasser, finder perceptronen garanteret en. Albert Novikoff beviste i 1962, at hvis hvert input højst har længden R, og den bedste linje adskiller klasserne med en margin γ, laver den klassiske regel højst (R/γ)² fejl, uanset i hvilken rækkefølge eksemplerne kommer. Beviset sammenligner to størrelser: Hver fejl retter w lidt mere ind efter den ideelle retning, med mindst γ, mens længden af w kun vokser som kvadratroden af antallet af fejl, så fejlene må slippe op. Den fundne linje er bare én af mange, der adskiller punkterne, ikke nødvendigvis den med det bredeste mellemrum.
Minsky, Papert og XOR
Når ingen ret linje adskiller klasserne, falder reglen aldrig til ro: Enhver linje fejlklassificerer et eller andet punkt, og det punkt trækker linjen væk igen. Det enkleste eksempel er XOR, funktionen, der er sand, når præcis ét af dens to input er sandt. I deres bog Perceptrons fra 1969 beviste Marvin Minsky og Seymour Papert, at enkeltlags-perceptroner hverken kan beregne XOR eller afgøre, om en figur hænger sammen, og de analyserede præcist, hvad de kan beregne. Bogen får ofte skylden for faldet i bevillingerne til forskning i neurale netværk i 1970'erne, selv om forfatterne vidste, at netværk med flere lag kunne mere.
Fra perceptroner til neurale netværk
For to lag er XOR let: Én neuron beregner OR, en anden NAND, og en tredje kombinerer dem med AND. Problemet var at træne de skjulte neuroner, for en hård tærskel giver ingen antydning af, hvilken vej en vægt skal drejes. Da trinfunktionen blev erstattet af en glat funktion som sigmoid, blev fejlen differentiabel, og backpropagation, gjort kendt i 1986 af David Rumelhart, Geoffrey Hinton og Ronald Williams, beregner, hvor meget hver vægt i hvert lag bidrager til fejlen. Sådanne flerlags-perceptroner, nu dybe og brede, er nutidens neurale netværk. For data, som ét lag ikke kan adskille, gemmer Stephen Gallants lommealgoritme fra 1990 i det mindste den bedste linje, der dukkede op under træningen.

Prøv det selv
Åbn perceptron-visualiseringen for at træne en perceptron på de logiske gates AND, OR og NAND, på tilfældige punkter med en margin efter eget valg eller på punkter, du selv sætter. Gå læringsreglen igennem ét eksempel ad gangen, og aflæs hver vægt før og efter opdateringen, se linjen og vægtvektoren dreje, og følg fejlene pr. epoke. Prøv derefter XOR og de overlappende skyer, se perceptronen ikke nå at konvergere, og slå lommealgoritmen til.
Ofte stillede spørgsmål
Er en perceptron det samme som logistisk regression?
Begge er én neuron med en ret grænse, men de lærer forskelligt. Perceptronen svarer kun ja eller nej og ændrer kun sine vægte efter en fejl. Logistisk regression sender summen gennem en sigmoid for at få en sandsynlighed og justerer sine vægte efter hvert eksempel for at gøre de rigtige svar mere sandsynlige; den bliver derfor ved med at forbedre sig, også når alle punkter allerede ligger på den rigtige side, og den falder også til ro på data, som ingen linje adskiller.
Hvorfor har en perceptron brug for bias?
Uden bias er w₁x + w₂y nul i origo, så enhver grænse ville gå gennem (0, 0). Gatene AND og OR på input 0 og 1 kræver en linje, der går uden om origo: For AND adskiller for eksempel 4x + 2y − 5 = 0 punktet (1, 1) fra de tre andre hjørner. Bias læres som enhver anden vægt, som vægten for et input, der altid er 1.
Hvilken linje finder perceptronen?
En hvilken som helst linje, der adskiller punkterne, afhængigt af startvægtene og eksemplernes rækkefølge. Den stopper, så snart der ikke er flere fejl, så linjen går ofte tæt forbi nogle punkter. Support vector machines leder i stedet efter linjen med den bredeste margin, og Yoav Freunds og Robert Schapires voted og averaged perceptron kombinerer de linjer, der blev set under træningen, for at generalisere bedre.
Hvad er en flerlags-perceptron?
Et netværk af neuroner i lag, hvor hvert lags output er det næste lags input. Med en glat aktiveringsfunktion i stedet for en hård tærskel kan det trænes med backpropagation og gradientnedstigning. Ét skjult lag med nok neuroner kan tilnærme enhver kontinuert funktion på et begrænset område, og to skjulte neuroner løser allerede XOR.
Relaterede værktøjer
Perceptron-visualisering
Træn Rosenblatts perceptron i din browser: Gå læringsreglen igennem ét eksempel ad gangen, se beslutningsgrænsen og vægtvektoren flytte sig, og se, hvorfor AND og OR bliver lært, men XOR aldrig.

Sandkasse til neurale netværk
Træn et lille neuralt netværk live, og se det adskille to klasser af punkter. Skift lag, neuroner, aktivering, læringsrate og input, og se, hvad hver neuron reagerer på.
Legeplads for genetiske algoritmer
Se raketter udvikle sig, så de flyver uden om mure og når et mål. Skift population, mutationsrate, levetid og selektion, tegn dine egne forhindringer, og følg, hvor mange der når frem i hver generation.

Matrixberegner
Gratis online matrixberegner: læg sammen, træk fra, gang, transponér og invertér matricer op til 6x6, med determinant, rang, potenser og eksakte brøker.

Funktionsplotter
En gratis online funktionsplotter: tegn x², sin x, ln x, 1/x og dine egne formler i et interaktivt koordinatsystem. Panorér, zoom, aflæs x og y, og gem grafen som PNG.
Er du klar til at prøve?
Åbn PictorX i din browser – ingen installation og intet kreditkort for at komme i gang.
Åbn perceptron-visualiseringen