
O perceptrão explicado
Em 1958, um psicólogo apresentou, num laboratório em Buffalo, no estado de Nova Iorque, uma máquina que aprendia. Ninguém lhe dizia a regra para distinguir dois tipos de imagens: mostravam-lhe exemplos e, após cada resposta errada, ela rodava um pouco os seus próprios botões. Essa máquina, o perceptrão, é um único neurónio artificial com uma regra de aprendizagem de poucas linhas. Não consegue aprender tudo, e a história do que não consegue aprender é tão instrutiva como a do que consegue.

Uma máquina que aprende
Frank Rosenblatt, psicólogo do Cornell Aeronautical Laboratory, descreveu o perceptrão em 1958. Baseou-se no neurónio artificial que Warren McCulloch e Walter Pitts tinham proposto em 1943: uma unidade que soma as suas entradas e dispara quando o total ultrapassa um limiar. McCulloch e Pitts tinham de definir os pesos à mão. A ideia nova de Rosenblatt foi uma regra que os ajustava a partir de exemplos. A imprensa ficou entusiasmada: em julho de 1958, o New York Times noticiou que a Marinha esperava que a máquina viesse um dia a andar, falar, ver e ter consciência da sua própria existência.

O Mark I Perceptron
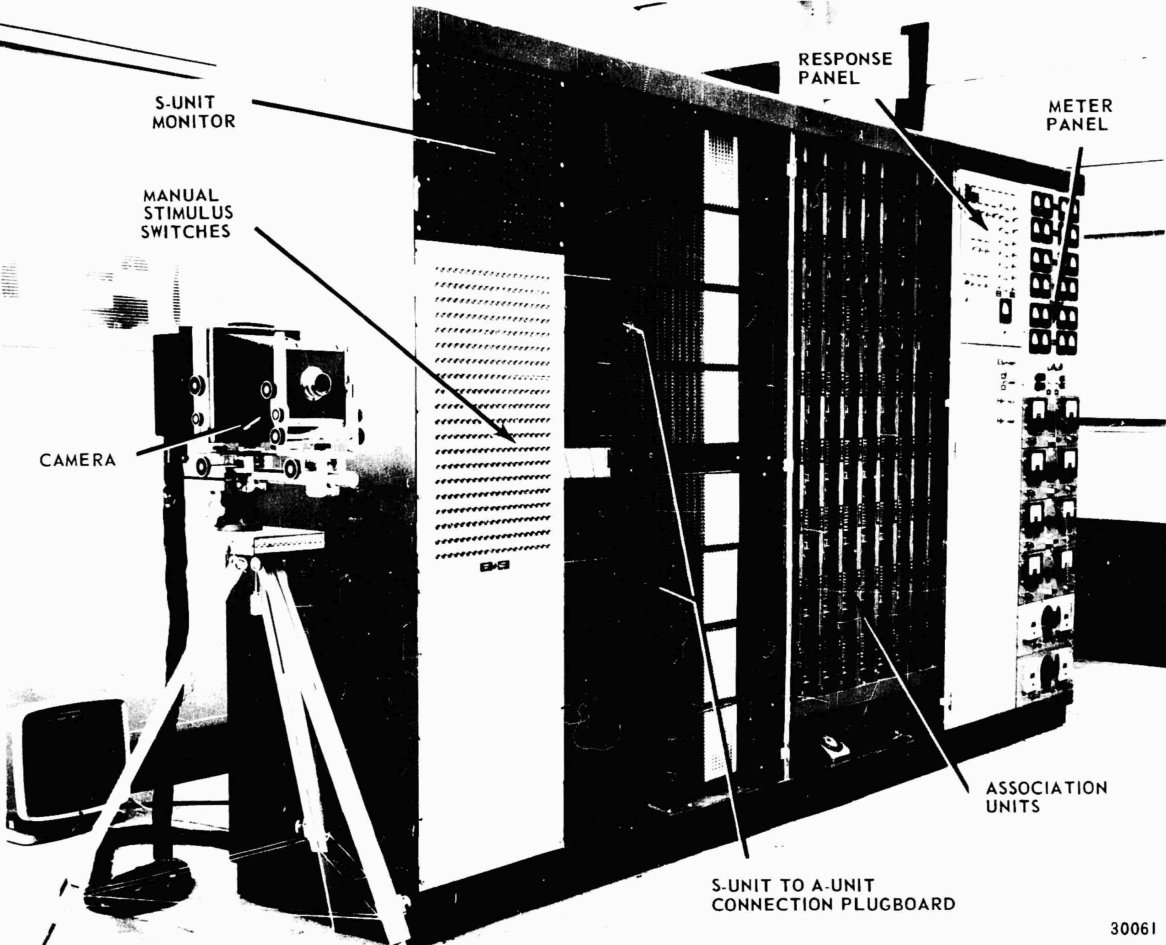
O primeiro perceptrão corria como programa num IBM 704, mas Rosenblatt depressa o mandou construir como máquina própria. O Mark I Perceptron, concluído por volta de 1960, via o mundo através de uma câmara de 400 sensores de luz numa grelha de 20 por 20, ligados ao acaso a uma camada de unidades de associação. Os seus pesos eram potenciómetros, rodados por pequenos motores elétricos sempre que errava. Aprendeu a distinguir formas e letras simples. A máquina está hoje guardada no National Museum of American History da Smithsonian Institution.
Um neurónio, uma reta
Um perceptrão com duas entradas x e y calcula w₁x + w₂y + b e responde +1 se essa soma for positiva e −1 se for negativa. A soma é zero exatamente sobre a reta w₁x + w₂y + b = 0, por isso o neurónio divide o plano em dois semiplanos, um para cada resposta. O vetor de pesos (w₁, w₂) é perpendicular à reta e aponta para o lado +1, e o viés b afasta a reta da origem: sem ele, todas as fronteiras passariam por (0, 0). Com mais entradas, a reta torna-se um plano ou um hiperplano, mas a ideia é a mesma. O truque de escrever o viés como um peso w₀ sobre uma entrada extra que vale sempre 1 permite que uma única regra aprenda todos os pesos.
A regra de aprendizagem
O treino percorre os exemplos um a um. Para cada exemplo x de classe verdadeira y, o neurónio dá a sua resposta ŷ. Se ŷ for igual a y, nada acontece. Caso contrário, cada peso varia η·(y − ŷ) vezes a sua entrada: w ← w + η·(y − ŷ)·x. Para um ponto +1 a que se respondeu −1, soma-se a w um múltiplo de x, o que aumenta w·x num múltiplo do quadrado do comprimento de x e empurra o ponto para o lado certo; para um ponto −1 acontece o contrário. A taxa de aprendizagem η define o tamanho do passo. Uma passagem por todos os exemplos é uma época, e o treino termina após uma passagem sem erros.
O teorema de convergência
Se alguma reta separar as duas classes, o perceptrão tem a garantia de encontrar uma. Albert Novikoff provou em 1962 que, se cada entrada tiver comprimento no máximo R e a melhor reta separar as classes com uma margem γ, a regra clássica comete no máximo (R/γ)² erros, seja qual for a ordem dos exemplos. A prova compara duas grandezas: cada erro alinha um pouco mais w com a direção ideal, pelo menos γ, enquanto o comprimento de w só cresce como a raiz quadrada do número de erros, por isso os erros têm de acabar. A reta encontrada é apenas uma das muitas que separam os pontos, não necessariamente a que deixa o intervalo mais largo.
Minsky, Papert e o XOR
Quando nenhuma reta separa as classes, a regra nunca estabiliza: cada reta classifica mal algum ponto, e esse ponto volta a arrastá-la. O exemplo mais simples é o XOR, a função que é verdadeira quando exatamente uma das suas duas entradas é verdadeira. No livro Perceptrons, de 1969, Marvin Minsky e Seymour Papert provaram que os perceptrões de uma camada não conseguem calcular o XOR nem dizer se uma figura é conexa, e analisaram com precisão o que conseguem calcular. O livro é muitas vezes culpado pela quebra do financiamento da investigação em redes neuronais nos anos 1970, embora os seus autores soubessem que redes com mais camadas podiam fazer mais.
Dos perceptrões às redes neuronais
Para duas camadas, o XOR é fácil: um neurónio calcula OR, outro NAND, e um terceiro combina-os com AND. A dificuldade era treinar os neurónios ocultos, porque um limiar abrupto não dá nenhuma pista sobre para que lado rodar um peso. Substituir o degrau por uma função suave como a sigmoide tornou o erro diferenciável, e a retropropagação, popularizada em 1986 por David Rumelhart, Geoffrey Hinton e Ronald Williams, calcula quanto cada peso de cada camada contribui para o erro. Esses perceptrões multicamada, agora profundos e largos, são as redes neuronais de hoje. Para dados que uma camada não consegue separar, o algoritmo do bolso de Stephen Gallant, de 1990, guarda pelo menos a melhor reta vista durante o treino.

Explore
Abra o visualizador do perceptrão para treinar um perceptrão com as portas lógicas AND, OR e NAND, com pontos aleatórios e a margem que quiser, ou com pontos que coloque. Percorra a regra de aprendizagem exemplo a exemplo e leia cada peso antes e depois da atualização, veja a reta e o vetor de pesos a rodar e acompanhe os erros por época. Depois experimente o XOR e as nuvens sobrepostas, veja o perceptrão não conseguir convergir e ative o algoritmo do bolso.
Perguntas frequentes
Um perceptrão é o mesmo que uma regressão logística?
Ambos são um único neurónio com uma fronteira reta, mas aprendem de forma diferente. O perceptrão responde apenas sim ou não e só muda os pesos depois de um erro. A regressão logística passa a soma por uma sigmoide para obter uma probabilidade e ajusta os pesos após cada exemplo para tornar as respostas certas mais prováveis; assim continua a melhorar mesmo quando todos os pontos já estão do lado certo, e também estabiliza com dados que nenhuma reta separa.
Porque é que um perceptrão precisa de um viés?
Sem viés, w₁x + w₂y vale zero na origem, por isso todas as fronteiras passariam por (0, 0). As portas AND e OR com as entradas 0 e 1 precisam de uma reta que não passe pela origem: para AND, por exemplo, 4x + 2y − 5 = 0 separa (1, 1) dos outros três cantos. O viés aprende-se como qualquer outro peso, como o peso de uma entrada que vale sempre 1.
Que reta encontra o perceptrão?
Qualquer reta que separe os pontos, consoante os pesos iniciais e a ordem dos exemplos. Para assim que deixa de haver erros, por isso a reta passa muitas vezes perto de alguns pontos. As máquinas de vetores de suporte procuram antes a reta com a margem mais larga, e os perceptrões votado e médio de Yoav Freund e Robert Schapire combinam as retas vistas durante o treino para generalizar melhor.
O que é um perceptrão multicamada?
Uma rede de neurónios em camadas, em que as saídas de cada camada são as entradas da seguinte. Com uma função de ativação suave em vez de um limiar abrupto, pode ser treinada por retropropagação e descida do gradiente. Uma única camada oculta com neurónios suficientes consegue aproximar qualquer função contínua numa região limitada, e dois neurónios ocultos já resolvem o XOR.
Ferramentas relacionadas
Visualizador do perceptrão
Treine o perceptrão de Rosenblatt no seu navegador: percorra a regra de aprendizagem exemplo a exemplo, veja a fronteira de decisão e o vetor de pesos a mover-se, e descubra porque AND e OR se aprendem mas XOR nunca.

Simulador de redes neuronais
Treine em direto uma pequena rede neuronal e veja-a separar duas classes de pontos. Altere as camadas, os neurónios, a ativação, a taxa de aprendizagem e as entradas, e veja a que reage cada neurónio.
Laboratório de algoritmos genéticos
Veja foguetões a evoluir até alcançarem um alvo contornando paredes. Altere a população, a taxa de mutação, o tempo de vida e a seleção, desenhe os seus próprios obstáculos e acompanhe quantos chegam em cada geração.

Calculadora de matrizes
Calculadora de matrizes online gratuita: some, subtraia, multiplique, transponha e inverta matrizes até 6x6, com determinante, característica, potências e frações exatas.

Traçador de funções
Um traçador de funções online gratuito: desenhe x², sin x, ln x, 1/x e as suas próprias fórmulas numa grelha interativa. Desloque, faça zoom, leia x e y e guarde o gráfico em PNG.
Pronto para experimentar?
Abra o PictorX no seu navegador – sem instalação, sem necessidade de cartão de crédito para começar.
Abrir o visualizador do perceptrão