
Perceptron wyjaśniony
W 1958 roku psycholog z laboratorium w Buffalo w stanie Nowy Jork pokazał maszynę, która się uczyła. Nikt nie podał jej reguły odróżniania dwóch rodzajów obrazów: pokazywano jej przykłady, a po każdej błędnej odpowiedzi sama lekko przekręcała swoje pokrętła. Ta maszyna, perceptron, to pojedynczy sztuczny neuron z regułą uczenia mieszczącą się w kilku linijkach. Nie potrafi nauczyć się wszystkiego, a historia tego, czego nie potrafi, jest równie pouczająca jak historia tego, co potrafi.

Maszyna, która się uczy
Frank Rosenblatt, psycholog z Cornell Aeronautical Laboratory, opisał perceptron w 1958 roku. Oparł się na sztucznym neuronie zaproponowanym w 1943 roku przez Warrena McCullocha i Waltera Pittsa: jednostce, która sumuje swoje wejścia i odpala, gdy suma przekroczy próg. McCulloch i Pitts musieli ustawiać wagi ręcznie. Nowym pomysłem Rosenblatta była reguła, która wyznaczała je na podstawie przykładów. Prasa była zachwycona: w lipcu 1958 roku „New York Times” donosił, że marynarka wojenna spodziewa się, iż maszyna pewnego dnia będzie chodzić, mówić, widzieć i będzie świadoma własnego istnienia.

Mark I Perceptron
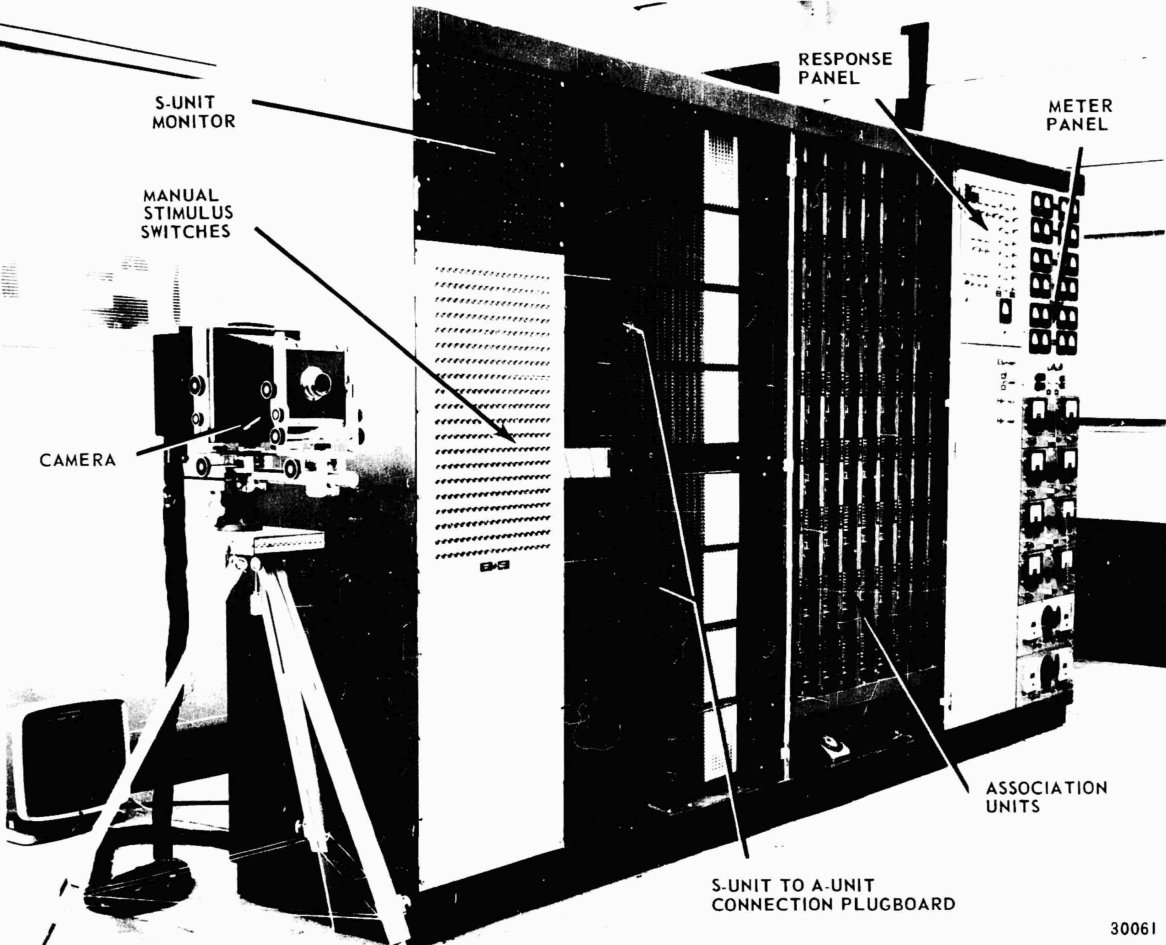
Pierwszy perceptron działał jako program na komputerze IBM 704, ale Rosenblatt wkrótce zlecił zbudowanie go jako osobnej maszyny. Mark I Perceptron, ukończony około 1960 roku, patrzył na świat przez kamerę z 400 czujników światła w siatce 20 na 20, połączonych losowo z warstwą jednostek asocjacyjnych. Jego wagami były potencjometry obracane przez małe silniki elektryczne przy każdym błędzie. Nauczył się odróżniać proste kształty i litery. Maszyna jest dziś przechowywana w National Museum of American History należącym do Smithsonian Institution.
Jeden neuron, jedna prosta
Perceptron z dwoma wejściami x i y oblicza w₁x + w₂y + b i odpowiada +1, jeśli suma jest dodatnia, i −1, jeśli jest ujemna. Suma jest równa zeru dokładnie na prostej w₁x + w₂y + b = 0, więc neuron dzieli płaszczyznę na dwie półpłaszczyzny, po jednej dla każdej odpowiedzi. Wektor wag (w₁, w₂) jest prostopadły do prostej i wskazuje stronę +1, a obciążenie b odsuwa prostą od początku układu: bez niego każda granica przechodziłaby przez (0, 0). Przy większej liczbie wejść prosta staje się płaszczyzną lub hiperpłaszczyzną, ale idea pozostaje ta sama. Sztuczka polegająca na zapisaniu obciążenia jako wagi w₀ dodatkowego wejścia zawsze równego 1 pozwala jednej regule nauczyć się wszystkich wag.
Reguła uczenia
Trening przechodzi przez przykłady po kolei. Dla każdego przykładu x o prawdziwej klasie y neuron udziela odpowiedzi ŷ. Jeśli ŷ jest równe y, nic się nie dzieje. W przeciwnym razie każda waga zmienia się o η·(y − ŷ) razy swoje wejście: w ← w + η·(y − ŷ)·x. Dla punktu klasy +1, któremu odpowiedziano −1, do w dodaje się wielokrotność x, co zwiększa w·x o wielokrotność kwadratu długości x i przesuwa punkt ku właściwej stronie; dla punktu klasy −1 dzieje się odwrotnie. Współczynnik uczenia η ustala wielkość kroku. Jedno przejście przez wszystkie przykłady to epoka, a trening kończy się po przejściu bez błędu.
Twierdzenie o zbieżności
Jeśli jakaś prosta rozdziela obie klasy, perceptron na pewno ją znajdzie. Albert Novikoff udowodnił w 1962 roku, że jeśli każde wejście ma długość co najwyżej R, a najlepsza prosta rozdziela klasy z marginesem γ, klasyczna reguła popełni co najwyżej (R/γ)² błędów, niezależnie od kolejności przykładów. Dowód porównuje dwie wielkości: każdy błąd ustawia w nieco bardziej w idealnym kierunku, co najmniej o γ, podczas gdy długość w rośnie tylko jak pierwiastek z liczby błędów, więc błędy muszą się skończyć. Znaleziona prosta jest tylko jedną z wielu rozdzielających punkty, niekoniecznie tą z najszerszym odstępem.
Minsky, Papert i XOR
Gdy żadna prosta nie rozdziela klas, reguła nigdy się nie uspokaja: każda prosta źle klasyfikuje jakiś punkt, a ten punkt znowu ją odciąga. Najprostszym przykładem jest XOR, funkcja prawdziwa wtedy, gdy dokładnie jedno z jej dwóch wejść jest prawdziwe. W książce Perceptrons z 1969 roku Marvin Minsky i Seymour Papert udowodnili, że perceptrony jednowarstwowe nie potrafią obliczyć XOR ani stwierdzić, czy figura jest spójna, i dokładnie przeanalizowali, co potrafią obliczyć. Książkę często obwinia się o spadek finansowania badań nad sieciami neuronowymi w latach 70., choć jej autorzy wiedzieli, że sieci o większej liczbie warstw potrafią więcej.
Od perceptronów do sieci neuronowych
Dla dwóch warstw XOR jest łatwy: jeden neuron oblicza OR, drugi NAND, a trzeci łączy je bramką AND. Problemem było trenowanie neuronów ukrytych, bo twardy próg nie podpowiada, w którą stronę obrócić wagę. Zastąpienie skoku gładką funkcją, taką jak sigmoida, uczyniło błąd różniczkowalnym, a propagacja wsteczna, spopularyzowana w 1986 roku przez Davida Rumelharta, Geoffreya Hintona i Ronalda Williamsa, oblicza, ile każda waga w każdej warstwie wnosi do błędu. Takie perceptrony wielowarstwowe, dziś głębokie i szerokie, to współczesne sieci neuronowe. Dla danych, których jedna warstwa nie rozdzieli, algorytm kieszeniowy Stephena Gallanta z 1990 roku zachowuje przynajmniej najlepszą prostą widzianą w trakcie treningu.

Wypróbuj sam
Otwórz wizualizator perceptronu, aby trenować perceptron na bramkach logicznych AND, OR i NAND, na losowych punktach z wybranym marginesem albo na punktach, które sam umieścisz. Przechodź regułę uczenia przykład po przykładzie i odczytuj każdą wagę przed aktualizacją i po niej, obserwuj obrót prostej i wektora wag i śledź błędy na epokę. Potem wypróbuj XOR i nakładające się chmury, zobacz, jak perceptron nie osiąga zbieżności, i włącz algorytm kieszeniowy.
Często zadawane pytania
Czy perceptron to to samo co regresja logistyczna?
Oba to pojedynczy neuron z prostą granicą, ale uczą się inaczej. Perceptron odpowiada tylko tak lub nie i zmienia wagi wyłącznie po błędzie. Regresja logistyczna przepuszcza sumę przez sigmoidę, aby otrzymać prawdopodobieństwo, i dostosowuje wagi po każdym przykładzie, aby właściwe odpowiedzi były bardziej prawdopodobne; dzięki temu poprawia się dalej nawet wtedy, gdy wszystkie punkty są już po właściwej stronie, i stabilizuje się także na danych, których żadna prosta nie rozdziela.
Dlaczego perceptron potrzebuje obciążenia?
Bez obciążenia w₁x + w₂y jest równe zeru w początku układu, więc każda granica przechodziłaby przez (0, 0). Bramki AND i OR na wejściach 0 i 1 wymagają prostej omijającej początek układu: dla AND na przykład 4x + 2y − 5 = 0 oddziela (1, 1) od pozostałych trzech wierzchołków. Obciążenia uczy się jak każdej innej wagi – jako wagi wejścia zawsze równego 1.
Jaką prostą znajduje perceptron?
Dowolną prostą rozdzielającą punkty, zależnie od wag początkowych i kolejności przykładów. Zatrzymuje się, gdy tylko nie ma błędów, więc prosta często przechodzi blisko niektórych punktów. Maszyny wektorów nośnych szukają natomiast prostej o najszerszym marginesie, a perceptrony głosujący i uśredniony Yoava Freunda i Roberta Schapire'a łączą proste z treningu, aby lepiej uogólniać.
Czym jest perceptron wielowarstwowy?
To sieć neuronów ułożonych w warstwy, w której wyjścia każdej warstwy są wejściami następnej. Z gładką funkcją aktywacji zamiast twardego progu można ją trenować propagacją wsteczną i spadkiem gradientu. Jedna warstwa ukryta z wystarczającą liczbą neuronów może przybliżyć dowolną funkcję ciągłą na ograniczonym obszarze, a dwa neurony ukryte rozwiązują już XOR.
Powiązane narzędzia
Wizualizator perceptronu
Trenuj perceptron Rosenblatta w przeglądarce: przechodź regułę uczenia przykład po przykładzie, obserwuj ruch granicy decyzyjnej i wektora wag i zobacz, dlaczego AND i OR da się nauczyć, a XOR nigdy.

Piaskownica sieci neuronowej
Trenuj na żywo małą sieć neuronową i obserwuj, jak oddziela dwie klasy punktów. Zmieniaj warstwy, neurony, aktywację, współczynnik uczenia i wejścia, i zobacz, na co reaguje każdy neuron.
Plac zabaw algorytmu genetycznego
Obserwuj, jak rakiety ewoluują, by omijając ściany dotrzeć do celu. Zmieniaj populację, współczynnik mutacji, czas życia i selekcję, rysuj własne przeszkody i śledź, ile rakiet dociera do celu w każdym pokoleniu.

Kalkulator macierzy
Darmowy kalkulator macierzy online: dodawanie, odejmowanie, mnożenie, transpozycja i odwracanie macierzy do 6x6, z wyznacznikiem, rzędem, potęgami i dokładnymi ułamkami.

Kreślarka funkcji
Darmowa kreślarka funkcji online: rysuj x², sin x, ln x, 1/x i własne wzory w interaktywnym układzie współrzędnych. Przesuwaj, powiększaj, odczytuj x i y i zapisz wykres jako PNG.
Chcesz wypróbować?
Otwórz PictorX w swojej przeglądarce — do uruchomienia nie jest wymagana żadna instalacja ani karta kredytowa.
Otwórz wizualizator perceptronu