
परसेप्ट्रॉन समझाया गया
1958 में न्यूयॉर्क राज्य के बफ़ेलो की एक प्रयोगशाला में एक मनोवैज्ञानिक ने ऐसी मशीन दिखाई जो सीखती थी। किसी ने उसे दो तरह की तस्वीरों में फ़र्क करने का नियम नहीं बताया: उसे उदाहरण दिखाए गए, और हर गलत उत्तर के बाद वह अपने ही नॉब थोड़ा-सा घुमा देती थी। वह मशीन, परसेप्ट्रॉन, कुछ पंक्तियों वाले लर्निंग नियम से लैस एक अकेला कृत्रिम न्यूरॉन है। यह सब कुछ नहीं सीख सकता, और जो यह नहीं सीख सकता उसकी कहानी उतनी ही सिखाने वाली है जितनी जो यह सीख सकता है उसकी।

सीखने वाली मशीन
कॉर्नेल एयरोनॉटिकल लैबोरेटरी के मनोवैज्ञानिक फ़्रैंक रोज़ेनब्लैट ने 1958 में परसेप्ट्रॉन का वर्णन किया। उन्होंने उस कृत्रिम न्यूरॉन को आधार बनाया जिसे वॉरेन मैककलक और वॉल्टर पिट्स ने 1943 में प्रस्तावित किया था: एक इकाई जो अपने इनपुट जोड़ती है और योग एक सीमा पार करने पर सक्रिय हो जाती है। मैककलक और पिट्स को वेट हाथ से तय करने पड़ते थे। रोज़ेनब्लैट का नया विचार एक ऐसा नियम था जो उदाहरणों से वेट तय करता था। प्रेस उत्साहित था: जुलाई 1958 में न्यूयॉर्क टाइम्स ने बताया कि नौसेना को उम्मीद है कि यह मशीन एक दिन चल सकेगी, बोल सकेगी, देख सकेगी और अपने अस्तित्व के प्रति सचेत होगी।

Mark I परसेप्ट्रॉन
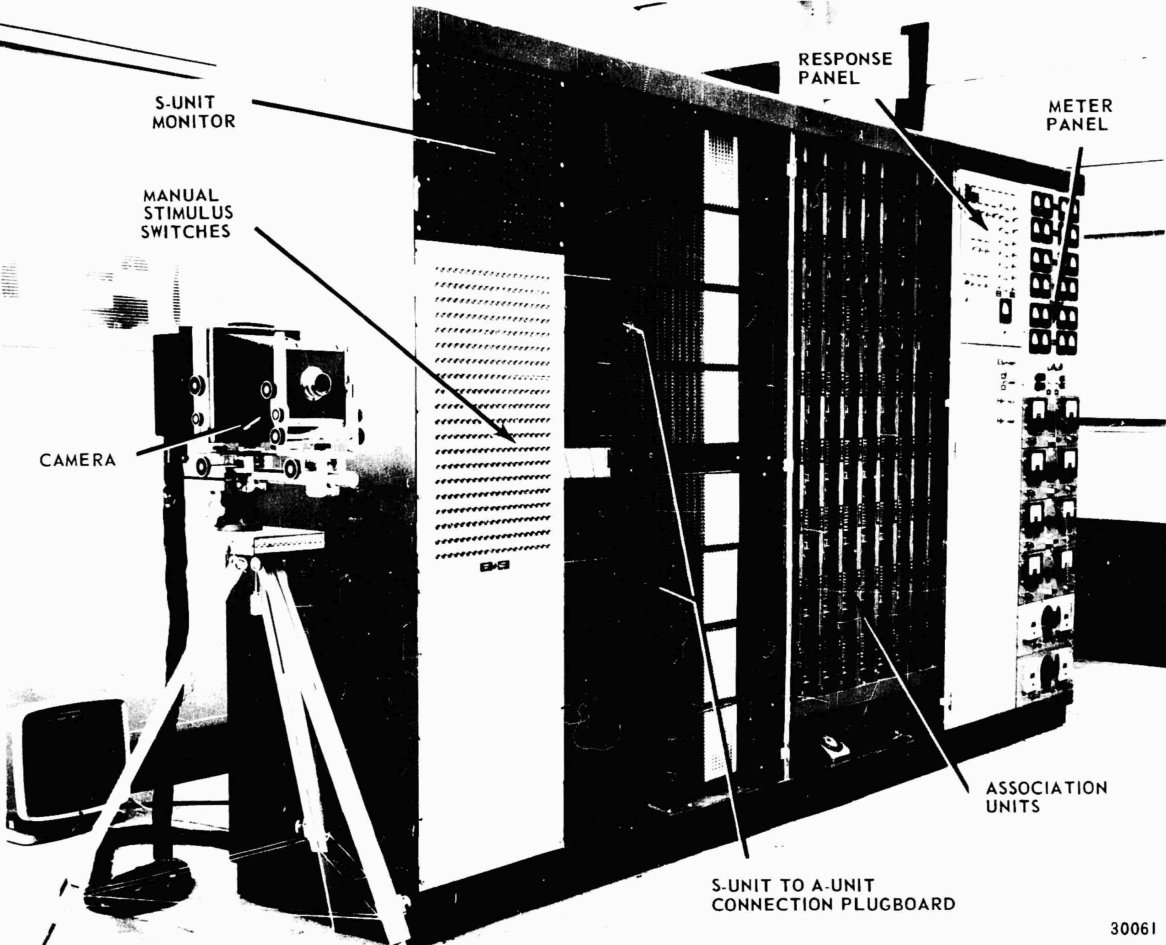
पहला परसेप्ट्रॉन IBM 704 पर एक प्रोग्राम के रूप में चला, पर रोज़ेनब्लैट ने जल्द ही इसे एक अलग मशीन के रूप में बनवाया। लगभग 1960 में पूरा हुआ Mark I परसेप्ट्रॉन दुनिया को 20 गुणा 20 के ग्रिड में लगे 400 प्रकाश सेंसरों वाले कैमरे से देखता था, जो एसोसिएशन इकाइयों की एक लेयर से यादृच्छिक रूप से जुड़े थे। इसके वेट पोटेंशियोमीटर थे, जिन्हें हर गलती पर छोटी इलेक्ट्रिक मोटरें घुमाती थीं। इसने सरल आकृतियों और अक्षरों में फ़र्क करना सीखा। यह मशीन आज स्मिथसोनियन के नेशनल म्यूज़ियम ऑफ़ अमेरिकन हिस्ट्री में रखी है।
एक न्यूरॉन, एक सीधी रेखा
दो इनपुट x और y वाला परसेप्ट्रॉन w₁x + w₂y + b की गणना करता है और योग धनात्मक हो तो +1, ऋणात्मक हो तो −1 उत्तर देता है। योग ठीक रेखा w₁x + w₂y + b = 0 पर शून्य होता है, इसलिए न्यूरॉन तल को दो अर्ध-तलों में बाँटता है, हर उत्तर के लिए एक। वेट वेक्टर (w₁, w₂) रेखा पर लंबवत है और +1 वाली तरफ़ इशारा करता है, और बायस b रेखा को मूल बिंदु से दूर खिसकाता है: इसके बिना हर सीमा (0, 0) से होकर गुज़रती। ज़्यादा इनपुट के साथ रेखा एक तल या हाइपरप्लेन बन जाती है, पर विचार वही रहता है। बायस को ऐसे अतिरिक्त इनपुट पर वेट w₀ के रूप में लिखने की तरकीब, जो हमेशा 1 हो, एक ही नियम से सारे वेट सिखा देती है।
लर्निंग नियम
ट्रेनिंग उदाहरणों को एक-एक करके देखती है। असली क्लास y वाले हर उदाहरण x के लिए न्यूरॉन अपना उत्तर ŷ देता है। अगर ŷ, y के बराबर है, तो कुछ नहीं होता। वरना हर वेट अपने इनपुट के η·(y − ŷ) गुना बदलता है: w ← w + η·(y − ŷ)·x। जिस +1 क्लास के बिंदु का उत्तर −1 आया, उसके लिए w में x का कोई गुणज जुड़ता है, जिससे w·x, x की लंबाई के वर्ग के किसी गुणज जितना बढ़ता है और बिंदु सही तरफ़ धकेला जाता है; −1 क्लास के बिंदु के लिए उलटा होता है। लर्निंग रेट η कदम का आकार तय करता है। सभी उदाहरणों पर एक चक्कर एक एपॉक है, और बिना गलती वाले चक्कर के बाद ट्रेनिंग खत्म हो जाती है।
अभिसरण प्रमेय
अगर कोई सीधी रेखा दोनों क्लासों को अलग करती है, तो परसेप्ट्रॉन को ऐसी एक रेखा मिलना तय है। अल्बर्ट नोविकॉफ़ ने 1962 में सिद्ध किया कि अगर हर इनपुट की लंबाई अधिकतम R हो और सबसे अच्छी रेखा क्लासों को मार्जिन γ से अलग करे, तो क्लासिक नियम उदाहरणों के क्रम से स्वतंत्र, अधिकतम (R/γ)² गलतियाँ करता है। प्रमाण दो राशियों की तुलना करता है: हर गलती w को आदर्श दिशा के साथ कम से कम γ और ज़्यादा संरेखित करती है, जबकि w की लंबाई केवल गलतियों की संख्या के वर्गमूल की तरह बढ़ती है, इसलिए गलतियाँ खत्म होनी ही हैं। मिली हुई रेखा बिंदुओं को अलग करने वाली कई रेखाओं में से केवल एक है, ज़रूरी नहीं कि सबसे चौड़े अंतर वाली हो।
मिंस्की, पेपर्ट और XOR
जब कोई सीधी रेखा क्लासों को अलग नहीं करती, तो नियम कभी स्थिर नहीं होता: हर रेखा किसी न किसी बिंदु को गलत वर्गीकृत करती है, और वह बिंदु रेखा को फिर खींच ले जाता है। सबसे सरल उदाहरण XOR है, वह फ़ंक्शन जो तब सत्य होता है जब उसके दो इनपुट में से ठीक एक सत्य हो। 1969 की अपनी किताब Perceptrons में मार्विन मिंस्की और सीमोर पेपर्ट ने सिद्ध किया कि एक-लेयर वाले परसेप्ट्रॉन न XOR की गणना कर सकते हैं, न बता सकते हैं कि कोई आकृति जुड़ी हुई है या नहीं, और उन्होंने सटीक विश्लेषण किया कि वे क्या गणना कर सकते हैं। 1970 के दशक में न्यूरल नेटवर्क शोध की फ़ंडिंग घटने का दोष अक्सर इस किताब पर डाला जाता है, हालाँकि इसके लेखक जानते थे कि ज़्यादा लेयर वाले नेटवर्क ज़्यादा कर सकते हैं।
परसेप्ट्रॉन से न्यूरल नेटवर्क तक
दो लेयर के लिए XOR आसान है: एक न्यूरॉन OR की गणना करता है, दूसरा NAND की, और तीसरा उन्हें AND से जोड़ता है। मुश्किल छिपे न्यूरॉनों को ट्रेन करने में थी, क्योंकि कठोर सीमा कोई संकेत नहीं देती कि वेट को किस दिशा में घुमाना है। सीढ़ी वाले फ़ंक्शन की जगह सिग्मॉइड जैसा चिकना फ़ंक्शन रखने से त्रुटि अवकलनीय हो गई, और 1986 में डेविड रुमेलहार्ट, जेफ़्री हिंटन और रोनाल्ड विलियम्स द्वारा लोकप्रिय बनाया गया बैकप्रोपेगेशन यह गणना करता है कि हर लेयर का हर वेट त्रुटि में कितना योगदान देता है। ऐसे मल्टीलेयर परसेप्ट्रॉन, जो अब गहरे और चौड़े हो चुके हैं, आज के न्यूरल नेटवर्क हैं। जिस डेटा को एक लेयर अलग नहीं कर सकती, उसके लिए स्टीफ़न गैलेंट का 1990 का पॉकेट एल्गोरिद्म कम से कम ट्रेनिंग में दिखी सबसे अच्छी रेखा सँभाल लेता है।

खुद आज़माएँ
परसेप्ट्रॉन विज़ुअलाइज़र खोलें और लॉजिक गेट AND, OR और NAND पर, अपनी पसंद के मार्जिन वाले यादृच्छिक बिंदुओं पर, या खुद रखे बिंदुओं पर परसेप्ट्रॉन को ट्रेन करें। लर्निंग नियम को एक-एक नमूने के साथ चलाएँ और हर वेट को अपडेट से पहले और बाद में पढ़ें, रेखा और वेट वेक्टर को घूमते देखें, और प्रति एपॉक गलतियों पर नज़र रखें। फिर XOR और एक-दूसरे पर चढ़े बादल आज़माएँ, परसेप्ट्रॉन को अभिसरित होने में नाकाम होते देखें, और पॉकेट एल्गोरिद्म चालू करें।
अक्सर पूछे जाने वाले प्रश्न
क्या परसेप्ट्रॉन और लॉजिस्टिक रिग्रेशन एक ही चीज़ हैं?
दोनों सीधी सीमा वाला एक अकेला न्यूरॉन हैं, पर वे अलग तरह से सीखते हैं। परसेप्ट्रॉन केवल हाँ या नहीं में उत्तर देता है और केवल गलती के बाद अपने वेट बदलता है। लॉजिस्टिक रिग्रेशन योग को सिग्मॉइड से गुज़ारकर एक प्रायिकता पाता है और हर उदाहरण के बाद वेट समायोजित करता है ताकि सही उत्तर ज़्यादा संभावित हों; इसलिए यह तब भी सुधरता रहता है जब सारे बिंदु पहले से सही तरफ़ हों, और ऐसे डेटा पर भी स्थिर हो जाता है जिसे कोई रेखा अलग नहीं करती।
परसेप्ट्रॉन को बायस की ज़रूरत क्यों है?
बायस के बिना w₁x + w₂y मूल बिंदु पर शून्य होता है, इसलिए हर सीमा (0, 0) से गुज़रती। 0 और 1 इनपुट वाले AND और OR गेट को ऐसी रेखा चाहिए जो मूल बिंदु से न गुज़रे: उदाहरण के लिए AND के लिए 4x + 2y − 5 = 0, (1, 1) को बाकी तीन कोनों से अलग करती है। बायस किसी भी दूसरे वेट की तरह सीखा जाता है, उस इनपुट के वेट के रूप में जो हमेशा 1 होता है।
परसेप्ट्रॉन कौन-सी रेखा ढूँढता है?
बिंदुओं को अलग करने वाली कोई भी रेखा, जो शुरुआती वेट और उदाहरणों के क्रम पर निर्भर करती है। गलतियाँ खत्म होते ही यह रुक जाता है, इसलिए रेखा अक्सर कुछ बिंदुओं के बहुत पास से गुज़रती है। सपोर्ट वेक्टर मशीनें इसके बजाय सबसे चौड़े मार्जिन वाली रेखा खोजती हैं, और योआव फ़्रॉइंड और रॉबर्ट शापिरे के वोटेड और एवरेज्ड परसेप्ट्रॉन बेहतर सामान्यीकरण के लिए ट्रेनिंग में दिखी रेखाओं को मिलाते हैं।
मल्टीलेयर परसेप्ट्रॉन क्या है?
लेयरों में रखे न्यूरॉनों का नेटवर्क, जिसमें हर लेयर के आउटपुट अगली लेयर के इनपुट होते हैं। कठोर सीमा की जगह चिकने एक्टिवेशन फ़ंक्शन के साथ इसे बैकप्रोपेगेशन और ग्रेडिएंट डिसेंट से ट्रेन किया जा सकता है। पर्याप्त न्यूरॉनों वाली एक छिपी लेयर किसी सीमित क्षेत्र पर किसी भी सतत फ़ंक्शन का सन्निकटन कर सकती है, और दो छिपे न्यूरॉन XOR को हल कर देते हैं।
संबंधित टूल
परसेप्ट्रॉन विज़ुअलाइज़र
रोज़ेनब्लैट के परसेप्ट्रॉन को अपने ब्राउज़र में ट्रेन करें: लर्निंग नियम को एक-एक नमूने के साथ चलाएँ, निर्णय सीमा और वेट वेक्टर को हिलते देखें, और जानें कि AND और OR क्यों सीखे जाते हैं पर XOR कभी नहीं।

न्यूरल नेटवर्क सैंडबॉक्स
एक छोटे न्यूरल नेटवर्क को लाइव ट्रेन करें और उसे बिंदुओं के दो वर्गों को अलग करते देखें। लेयर, न्यूरॉन, एक्टिवेशन, लर्निंग रेट और इनपुट बदलें, और देखें कि हर न्यूरॉन किस पर प्रतिक्रिया देता है।
जेनेटिक एल्गोरिदम प्लेग्राउंड
रॉकेटों को दीवारों के चारों ओर से होकर लक्ष्य तक पहुँचने के लिए विकसित होते देखें। जनसंख्या, उत्परिवर्तन दर, जीवनकाल और चयन बदलें, अपनी बाधाएँ बनाएँ, और देखें कि हर पीढ़ी में कितने रॉकेट पहुँचते हैं।

मैट्रिक्स कैलकुलेटर
मुफ़्त ऑनलाइन मैट्रिक्स कैलकुलेटर: 6x6 तक के मैट्रिक्स जोड़ें, घटाएँ, गुणा करें, परिवर्त और व्युत्क्रम निकालें, सारणिक, रैंक, घात और सटीक भिन्नों के साथ।

फ़ंक्शन प्लॉटर
मुफ़्त ऑनलाइन फ़ंक्शन प्लॉटर: x², sin x, ln x, 1/x और अपने सूत्र इंटरैक्टिव ग्रिड पर बनाएँ। खिसकाएँ, ज़ूम करें, x और y पढ़ें और ग्राफ़ को PNG के रूप में सहेजें।
आज़माने के लिए तैयार?
अपने ब्राउज़र में PictorX खोलें — शुरू करने के लिए इंस्टॉल या क्रेडिट कार्ड की ज़रूरत नहीं।
परसेप्ट्रॉन विज़ुअलाइज़र खोलें