
Perceptronul explicat
În 1958, un psiholog a prezentat, într-un laborator din Buffalo, statul New York, o mașină care învăța. Nimeni nu-i spunea regula după care să deosebească două feluri de imagini: i se arătau exemple, iar după fiecare răspuns greșit își răsucea puțin propriile butoane. Acea mașină, perceptronul, este un singur neuron artificial cu o regulă de învățare de câteva rânduri. Nu poate învăța totul, iar povestea a ceea ce nu poate învăța este la fel de instructivă ca povestea a ceea ce poate.

O mașină care învață
Frank Rosenblatt, psiholog la Cornell Aeronautical Laboratory, a descris perceptronul în 1958. A pornit de la neuronul artificial propus în 1943 de Warren McCulloch și Walter Pitts: o unitate care își adună intrările și se activează când totalul depășește un prag. McCulloch și Pitts trebuiau să fixeze ponderile de mână. Ideea nouă a lui Rosenblatt a fost o regulă care le stabilea din exemple. Presa a fost entuziasmată: în iulie 1958, New York Times scria că Marina se aștepta ca mașina să poată într-o zi să meargă, să vorbească, să vadă și să fie conștientă de propria existență.

Mark I Perceptron
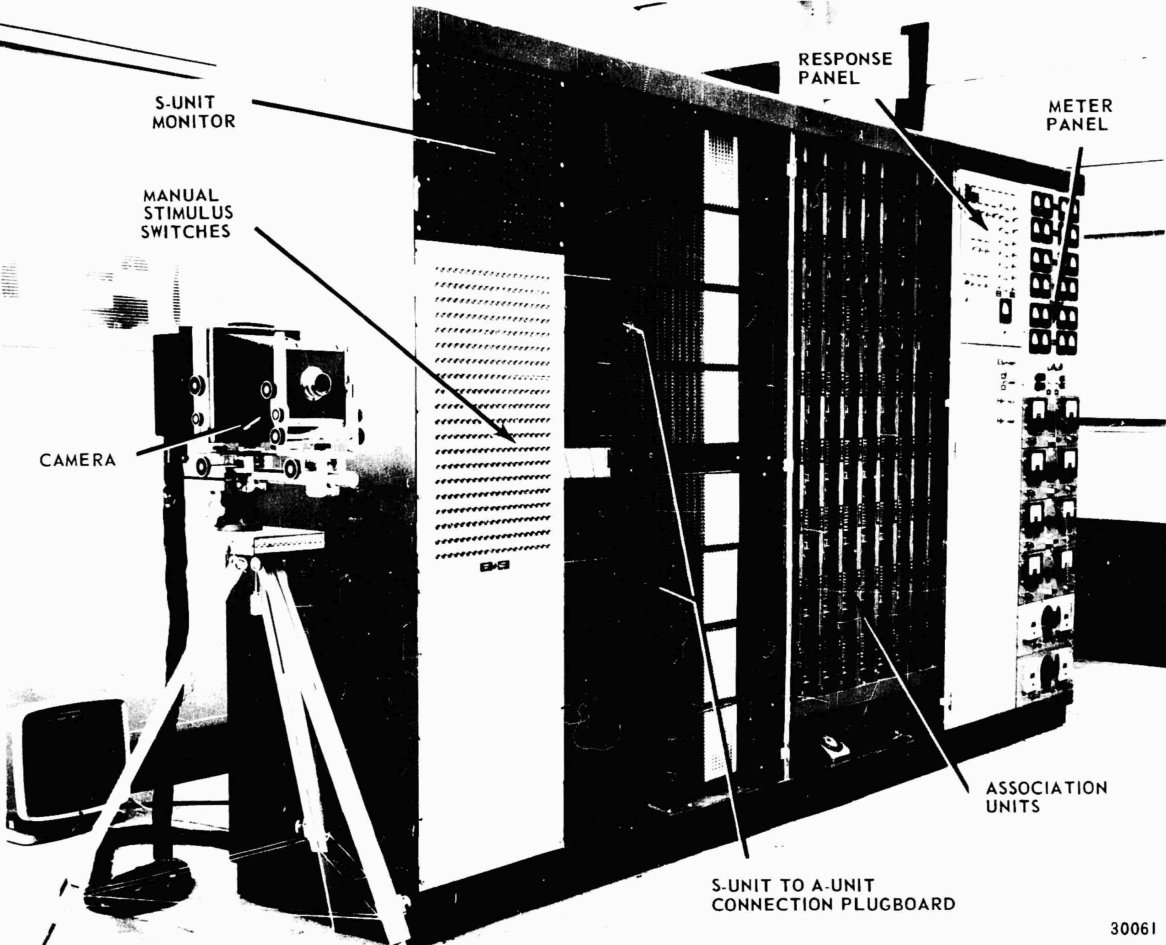
Primul perceptron a rulat ca program pe un IBM 704, dar Rosenblatt l-a pus curând să fie construit ca mașină de sine stătătoare. Mark I Perceptron, terminat în jurul anului 1960, privea lumea printr-o cameră cu 400 de senzori de lumină într-o grilă de 20 pe 20, legați la întâmplare de un strat de unități de asociere. Ponderile lui erau potențiometre, rotite de mici motoare electrice ori de câte ori greșea. A învățat să deosebească forme și litere simple. Mașina este păstrată astăzi la National Museum of American History al Smithsonian Institution.
Un neuron, o dreaptă
Un perceptron cu două intrări x și y calculează w₁x + w₂y + b și răspunde +1 dacă suma este pozitivă și −1 dacă este negativă. Suma este zero exact pe dreapta w₁x + w₂y + b = 0, așa că neuronul împarte planul în două semiplane, câte unul pentru fiecare răspuns. Vectorul ponderilor (w₁, w₂) este perpendicular pe dreaptă și arată spre partea +1, iar biasul b îndepărtează dreapta de origine: fără el, orice frontieră ar trece prin (0, 0). Cu mai multe intrări, dreapta devine un plan sau un hiperplan, dar ideea rămâne aceeași. Trucul de a scrie biasul ca o pondere w₀ pe o intrare suplimentară mereu egală cu 1 permite unei singure reguli să învețe toate ponderile.
Regula de învățare
Antrenarea parcurge exemplele unul câte unul. Pentru fiecare exemplu x cu clasa adevărată y, neuronul dă răspunsul ŷ. Dacă ŷ este egal cu y, nu se întâmplă nimic. Altfel, fiecare pondere se modifică cu η·(y − ŷ) înmulțit cu intrarea sa: w ← w + η·(y − ŷ)·x. Pentru un punct +1 la care s-a răspuns −1, la w se adaugă un multiplu al lui x, ceea ce crește w·x cu un multiplu al pătratului lungimii lui x și împinge punctul spre partea corectă; pentru un punct −1 se întâmplă invers. Rata de învățare η stabilește mărimea pasului. O trecere prin toate exemplele este o epocă, iar antrenarea se încheie după o trecere fără greșeli.
Teorema de convergență
Dacă o dreaptă separă cele două clase, perceptronul găsește sigur una. Albert Novikoff a demonstrat în 1962 că, dacă fiecare intrare are lungimea cel mult R și cea mai bună dreaptă separă clasele cu o margine γ, regula clasică face cel mult (R/γ)² greșeli, indiferent de ordinea exemplelor. Demonstrația compară două mărimi: fiecare greșeală aliniază w ceva mai bine cu direcția ideală, cu cel puțin γ, în timp ce lungimea lui w crește doar ca rădăcina pătrată a numărului de greșeli, așa că greșelile trebuie să se termine. Dreapta găsită este doar una dintre multele care separă punctele, nu neapărat cea cu spațiul cel mai larg.
Minsky, Papert și XOR
Când nicio dreaptă nu separă clasele, regula nu se stabilizează niciodată: fiecare dreaptă clasifică greșit vreun punct, iar acel punct o trage din nou în altă parte. Cel mai simplu exemplu este XOR, funcția adevărată când exact una dintre cele două intrări este adevărată. În cartea lor Perceptrons din 1969, Marvin Minsky și Seymour Papert au demonstrat că perceptronii cu un singur strat nu pot calcula XOR și nici nu pot spune dacă o figură este conexă, și au analizat precis ce pot calcula. Cartea este adesea învinuită pentru scăderea finanțării cercetării în rețele neuronale din anii 1970, deși autorii ei știau că rețelele cu mai multe straturi pot mai mult.
De la perceptroni la rețele neuronale
Pentru două straturi, XOR este ușor: un neuron calculează OR, altul NAND, iar al treilea le combină cu AND. Problema era antrenarea neuronilor ascunși, pentru că un prag abrupt nu dă niciun indiciu în ce sens să rotești o pondere. Înlocuirea treptei cu o funcție netedă precum sigmoida a făcut eroarea derivabilă, iar retropropagarea, popularizată în 1986 de David Rumelhart, Geoffrey Hinton și Ronald Williams, calculează cât contribuie la eroare fiecare pondere din fiecare strat. Asemenea perceptroni multistrat, ajunși adânci și largi, sunt rețelele neuronale de azi. Pentru date pe care un strat nu le poate separa, algoritmul de buzunar al lui Stephen Gallant din 1990 păstrează măcar cea mai bună dreaptă apărută în timpul antrenării.

Explorați
Deschideți vizualizatorul de perceptron pentru a antrena un perceptron pe porțile logice AND, OR și NAND, pe puncte aleatoare cu marginea dorită sau pe puncte puse de dumneavoastră. Parcurgeți regula de învățare exemplu cu exemplu și citiți fiecare pondere înainte și după actualizare, urmăriți cum se rotesc dreapta și vectorul ponderilor și urmăriți greșelile pe epocă. Apoi încercați XOR și norii suprapuși, vedeți cum perceptronul nu reușește să conveargă și porniți algoritmul de buzunar.
Întrebări frecvente
Este un perceptron același lucru cu regresia logistică?
Amândouă sunt un singur neuron cu o frontieră dreaptă, dar învață diferit. Perceptronul răspunde doar da sau nu și își schimbă ponderile doar după o greșeală. Regresia logistică trece suma printr-o sigmoidă pentru a obține o probabilitate și își ajustează ponderile după fiecare exemplu, ca răspunsurile corecte să devină mai probabile; astfel continuă să se îmbunătățească chiar și când toate punctele sunt deja de partea corectă și se stabilizează și pe date pe care nicio dreaptă nu le separă.
De ce are nevoie un perceptron de bias?
Fără bias, w₁x + w₂y este zero în origine, așa că orice frontieră ar trece prin (0, 0). Porțile AND și OR pe intrările 0 și 1 au nevoie de o dreaptă care ocolește originea: pentru AND, de exemplu, 4x + 2y − 5 = 0 separă (1, 1) de celelalte trei colțuri. Biasul se învață ca orice altă pondere, ca ponderea unei intrări mereu egale cu 1.
Ce dreaptă găsește perceptronul?
Orice dreaptă care separă punctele, în funcție de ponderile inițiale și de ordinea exemplelor. Se oprește imediat ce nu mai există greșeli, așa că dreapta trece adesea aproape de unele puncte. Mașinile cu vectori suport caută în schimb dreapta cu marginea cea mai largă, iar perceptronii cu vot și cu medie ai lui Yoav Freund și Robert Schapire combină dreptele văzute în timpul antrenării pentru a generaliza mai bine.
Ce este un perceptron multistrat?
O rețea de neuroni așezați în straturi, în care ieșirile fiecărui strat sunt intrările următorului. Cu o funcție de activare netedă în locul unui prag abrupt, poate fi antrenată prin retropropagare și coborâre pe gradient. Un singur strat ascuns cu suficienți neuroni poate aproxima orice funcție continuă pe o regiune mărginită, iar doi neuroni ascunși rezolvă deja XOR.
Unelte conexe
Vizualizator de perceptron
Antrenați perceptronul lui Rosenblatt în browser: parcurgeți regula de învățare exemplu cu exemplu, urmăriți cum se mișcă frontiera de decizie și vectorul ponderilor și vedeți de ce AND și OR se învață, dar XOR niciodată.

Sandbox pentru rețele neuronale
Antrenați în direct o rețea neuronală mică și urmăriți cum separă două clase de puncte. Schimbați straturile, neuronii, activarea, rata de învățare și intrările și vedeți la ce reacționează fiecare neuron.
Laborator de algoritmi genetici
Urmăriți cum rachetele evoluează pentru a ocoli pereții și a atinge o țintă. Schimbați populația, rata de mutație, durata de viață și selecția, desenați-vă propriile obstacole și urmăriți câte ajung la țintă în fiecare generație.

Calculator de matrice
Calculator de matrice online gratuit: adună, scade, înmulțește, transpune și inversează matrice de până la 6x6, cu determinant, rang, puteri și fracții exacte.

Trasator de funcții
Un trasator de funcții online gratuit: desenează x², sin x, ln x, 1/x și propriile formule într-un sistem de coordonate interactiv. Deplasează, mărește, citește x și y și salvează graficul ca PNG.
Ești gata să încerci?
Deschide PictorX în browser – fără instalare și fără card de credit.
Deschideți vizualizatorul de perceptron