
Das Perzeptron erklärt
1958 führte ein Psychologe in einem Labor in Buffalo im Bundesstaat New York eine Maschine vor, die lernte. Niemand nannte ihr die Regel, mit der sich zwei Arten von Bildern unterscheiden lassen: Man zeigte ihr Beispiele, und nach jeder falschen Antwort drehte sie ein wenig an ihren eigenen Knöpfen. Diese Maschine, das Perzeptron, ist ein einzelnes künstliches Neuron mit einer Lernregel von wenigen Zeilen. Es kann nicht alles lernen, und die Geschichte dessen, was es nicht lernen kann, ist ebenso lehrreich wie die Geschichte dessen, was es kann.

Eine Maschine, die lernt
Frank Rosenblatt, Psychologe am Cornell Aeronautical Laboratory, beschrieb das Perzeptron 1958. Er baute auf dem künstlichen Neuron auf, das Warren McCulloch und Walter Pitts 1943 vorgeschlagen hatten: eine Einheit, die ihre Eingaben addiert und feuert, wenn die Summe eine Schwelle überschreitet. McCulloch und Pitts mussten die Gewichte von Hand einstellen. Rosenblatts neue Idee war eine Regel, die sie aus Beispielen bestimmt. Die Presse war begeistert: Im Juli 1958 berichtete die New York Times, die Marine erwarte, dass die Maschine eines Tages gehen, sprechen, sehen und sich ihrer eigenen Existenz bewusst sein werde.

Das Mark I Perceptron
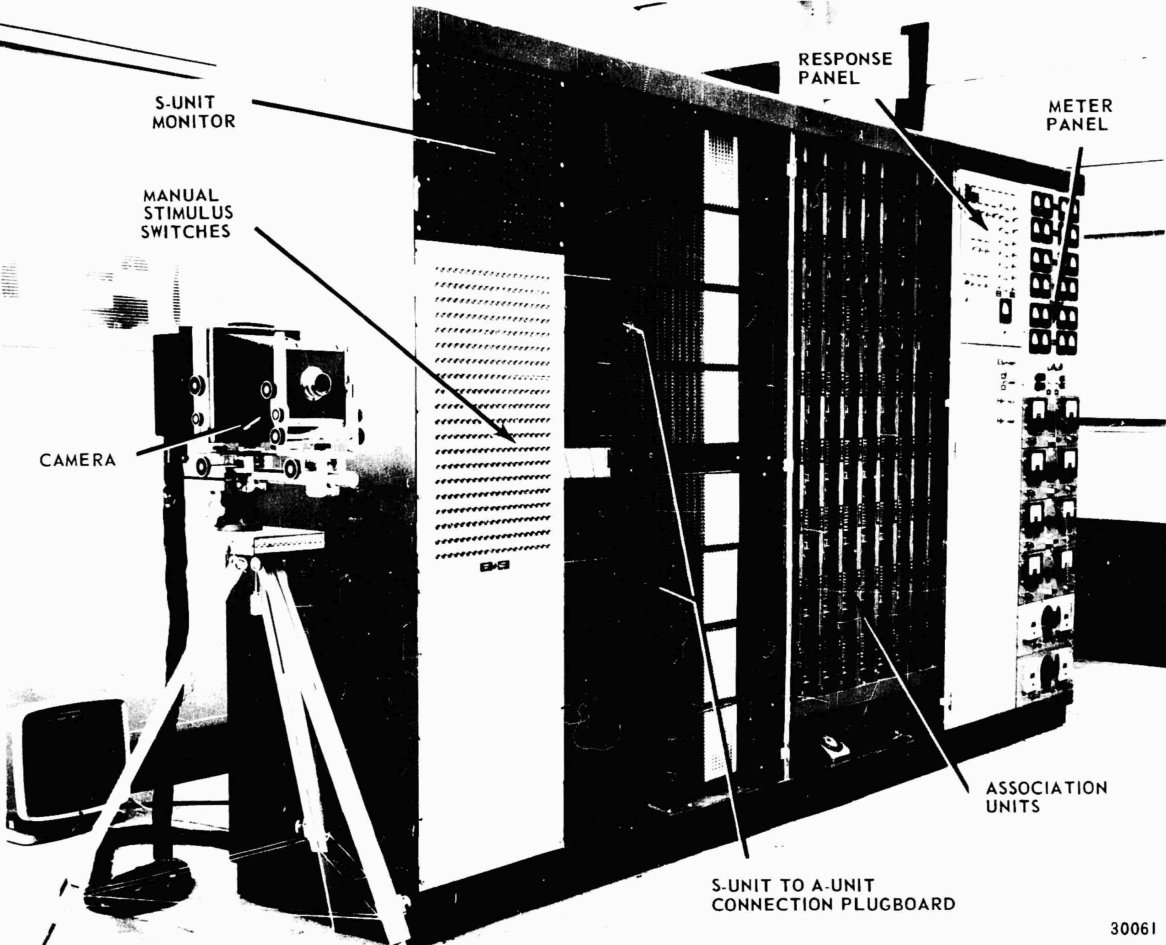
Das erste Perzeptron lief als Programm auf einer IBM 704, doch Rosenblatt ließ es bald als eigene Maschine bauen. Das Mark I Perceptron, um 1960 fertiggestellt, sah die Welt durch eine Kamera aus 400 Lichtsensoren in einem Raster von 20 mal 20, die zufällig mit einer Schicht von Assoziationseinheiten verdrahtet waren. Seine Gewichte waren Potentiometer, die bei jedem Fehler von kleinen Elektromotoren gedreht wurden. Es lernte, einfache Formen und Buchstaben zu unterscheiden. Die Maschine wird heute im National Museum of American History der Smithsonian Institution aufbewahrt.
Ein Neuron, eine Gerade
Ein Perzeptron mit zwei Eingaben x und y berechnet w₁x + w₂y + b und antwortet +1, wenn diese Summe positiv ist, und −1, wenn sie negativ ist. Genau auf der Geraden w₁x + w₂y + b = 0 ist die Summe null, also teilt das Neuron die Ebene in zwei Halbebenen, eine für jede Antwort. Der Gewichtsvektor (w₁, w₂) steht senkrecht auf der Geraden und zeigt in die Seite von +1, und der Bias b verschiebt die Gerade vom Ursprung weg: Ohne ihn ginge jede Grenze durch (0, 0). Bei mehr Eingaben wird aus der Geraden eine Ebene oder Hyperebene, aber die Idee bleibt dieselbe. Der Trick, den Bias als Gewicht w₀ auf einer zusätzlichen Eingabe zu schreiben, die immer 1 ist, lässt eine einzige Regel alle Gewichte lernen.
Die Lernregel
Das Training geht die Beispiele eines nach dem anderen durch. Für jedes Beispiel x mit der wahren Klasse y gibt das Neuron seine Antwort ŷ. Ist ŷ gleich y, passiert nichts. Andernfalls ändert sich jedes Gewicht um η·(y − ŷ) mal seine Eingabe: w ← w + η·(y − ŷ)·x. Für einen Punkt der Klasse +1 mit der Antwort −1 kommt ein Vielfaches von x zu w hinzu, was w·x um ein Vielfaches der quadrierten Länge von x erhöht und den Punkt zur richtigen Seite schiebt; bei einem Punkt der Klasse −1 geschieht das Gegenteil. Die Lernrate η bestimmt die Schrittweite. Ein Durchlauf über alle Beispiele ist eine Epoche, und das Training endet nach einem Durchlauf ohne Fehler.
Der Konvergenzsatz
Wenn irgendeine Gerade die beiden Klassen trennt, findet das Perzeptron garantiert eine. Albert Novikoff bewies 1962: Hat jede Eingabe höchstens die Länge R und trennt die beste Gerade die Klassen mit einem Abstand γ, dann macht die klassische Regel höchstens (R/γ)² Fehler, gleich in welcher Reihenfolge die Beispiele kommen. Der Beweis vergleicht zwei Größen: Jeder Fehler richtet w um mindestens γ stärker auf die ideale Richtung aus, während die Länge von w nur wie die Quadratwurzel der Fehlerzahl wächst, also müssen die Fehler irgendwann ausgehen. Die gefundene Gerade ist nur eine von vielen, die die Punkte trennen, nicht unbedingt die mit der breitesten Lücke.
Minsky, Papert und XOR
Wenn keine Gerade die Klassen trennt, kommt die Regel nie zur Ruhe: Jede Gerade klassifiziert irgendeinen Punkt falsch, und dieser Punkt zieht die Gerade wieder weg. Das einfachste Beispiel ist XOR, die Funktion, die wahr ist, wenn genau eine ihrer beiden Eingaben wahr ist. In ihrem Buch Perceptrons von 1969 bewiesen Marvin Minsky und Seymour Papert, dass einschichtige Perzeptronen weder XOR berechnen noch erkennen können, ob eine Figur zusammenhängend ist, und analysierten genau, was sie berechnen können. Dem Buch wird oft der Rückgang der Förderung für die Forschung an neuronalen Netzen in den 1970er-Jahren angelastet, obwohl seine Autoren wussten, dass Netze mit mehr Schichten mehr können.
Vom Perzeptron zu neuronalen Netzen
Für zwei Schichten ist XOR leicht: Ein Neuron berechnet OR, ein anderes NAND, und ein drittes verknüpft beide mit AND. Schwierig war das Training der verborgenen Neuronen, denn eine harte Schwelle verrät nicht, in welche Richtung ein Gewicht gedreht werden muss. Ersetzte man die Stufe durch eine glatte Funktion wie die Sigmoide, wurde der Fehler differenzierbar, und die Backpropagation, 1986 von David Rumelhart, Geoffrey Hinton und Ronald Williams bekannt gemacht, berechnet, wie viel jedes Gewicht in jeder Schicht zum Fehler beiträgt. Solche mehrschichtigen Perzeptronen, tief und breit geworden, sind die neuronalen Netze von heute. Für Daten, die eine Schicht nicht trennen kann, behält Stephen Gallants Pocket-Algorithmus von 1990 wenigstens die beste Gerade, die während des Trainings auftaucht.

Selbst ausprobieren
Öffnen Sie den Perzeptron-Visualisierer, um ein Perzeptron mit den Logikgattern AND, OR und NAND zu trainieren, mit Zufallspunkten und einem Abstand Ihrer Wahl oder mit Punkten, die Sie selbst setzen. Gehen Sie die Lernregel Beispiel für Beispiel durch und lesen Sie jedes Gewicht vor und nach der Aktualisierung, beobachten Sie, wie sich Gerade und Gewichtsvektor drehen, und verfolgen Sie die Fehler pro Epoche. Probieren Sie dann XOR und die überlappenden Wolken, sehen Sie das Perzeptron an der Konvergenz scheitern und schalten Sie den Pocket-Algorithmus ein.
Häufig gestellte Fragen
Ist ein Perzeptron dasselbe wie logistische Regression?
Beide sind ein einzelnes Neuron mit einer geraden Grenze, aber sie lernen unterschiedlich. Das Perzeptron antwortet nur mit Ja oder Nein und ändert seine Gewichte nur nach einem Fehler. Die logistische Regression schickt die Summe durch eine Sigmoide, um eine Wahrscheinlichkeit zu erhalten, und passt ihre Gewichte nach jedem Beispiel an, um die richtigen Antworten wahrscheinlicher zu machen; so verbessert sie sich weiter, selbst wenn schon alle Punkte auf der richtigen Seite liegen, und kommt auch bei Daten zur Ruhe, die keine Gerade trennt.
Warum braucht ein Perzeptron einen Bias?
Ohne Bias ist w₁x + w₂y im Ursprung null, also ginge jede Grenze durch (0, 0). Die Gatter AND und OR auf den Eingaben 0 und 1 brauchen eine Gerade, die am Ursprung vorbeigeht: Für AND trennt zum Beispiel 4x + 2y − 5 = 0 den Punkt (1, 1) von den anderen drei Ecken. Der Bias wird wie jedes andere Gewicht gelernt, als Gewicht einer Eingabe, die immer 1 ist.
Welche Gerade findet das Perzeptron?
Irgendeine Gerade, die die Punkte trennt, abhängig von den Startgewichten und der Reihenfolge der Beispiele. Es hört auf, sobald es keine Fehler mehr gibt, deshalb verläuft die Gerade oft dicht an einigen Punkten. Support-Vector-Maschinen suchen stattdessen die Gerade mit dem breitesten Abstand, und das Voted und das Averaged Perceptron von Yoav Freund und Robert Schapire kombinieren die während des Trainings gesehenen Geraden, um besser zu verallgemeinern.
Was ist ein mehrschichtiges Perzeptron?
Ein Netz von Neuronen in Schichten, in dem die Ausgaben jeder Schicht die Eingaben der nächsten sind. Mit einer glatten Aktivierungsfunktion statt einer harten Schwelle lässt es sich mit Backpropagation und Gradientenabstieg trainieren. Eine einzige verborgene Schicht mit genügend Neuronen kann jede stetige Funktion auf einem beschränkten Bereich annähern, und zwei verborgene Neuronen lösen bereits XOR.
Verwandte Tools
Perzeptron-Visualisierer
Trainieren Sie Rosenblatts Perzeptron im Browser: Gehen Sie die Lernregel Beispiel für Beispiel durch, sehen Sie Entscheidungsgrenze und Gewichtsvektor wandern und erfahren Sie, warum AND und OR gelernt werden, XOR aber nie.

Sandbox für neuronale Netze
Trainieren Sie live ein kleines neuronales Netz und sehen Sie zu, wie es zwei Klassen von Punkten trennt. Ändern Sie Schichten, Neuronen, Aktivierung, Lernrate und Eingaben und sehen Sie, worauf jedes Neuron reagiert.
Spielwiese für genetische Algorithmen
Sehen Sie zu, wie sich Raketen entwickeln, bis sie um Wände herum ein Ziel erreichen. Ändern Sie Population, Mutationsrate, Lebensdauer und Selektion, zeichnen Sie eigene Hindernisse und verfolgen Sie, wie viele in jeder Generation ankommen.

Matrizenrechner
Kostenloser Online-Matrizenrechner: Matrizen bis 6x6 addieren, subtrahieren, multiplizieren, transponieren und invertieren, mit Determinante, Rang, Potenzen und exakten Brüchen.

Funktionsplotter
Ein kostenloser Online-Funktionsplotter: Zeichne x², sin x, ln x, 1/x und eigene Formeln in einem interaktiven Koordinatensystem. Verschieben, zoomen, x und y ablesen und den Graphen als PNG speichern.
Bereit, es auszuprobieren?
Öffnen Sie PictorX in Ihrem Browser – keine Installation, zum Starten ist keine Kreditkarte erforderlich.
Perzeptron-Visualisierer öffnen