
Il percettrone spiegato
Nel 1958 uno psicologo presentò, in un laboratorio di Buffalo, nello Stato di New York, una macchina che imparava. Nessuno le diceva la regola per distinguere due tipi di immagini: le si mostravano esempi e, dopo ogni risposta sbagliata, girava un poco le proprie manopole. Quella macchina, il percettrone, è un singolo neurone artificiale con una regola di apprendimento di poche righe. Non può imparare tutto, e la storia di ciò che non può imparare è istruttiva quanto quella di ciò che può.

Una macchina che impara
Frank Rosenblatt, psicologo al Cornell Aeronautical Laboratory, descrisse il percettrone nel 1958. Si basava sul neurone artificiale proposto nel 1943 da Warren McCulloch e Walter Pitts: un'unità che somma i suoi ingressi e si attiva quando il totale supera una soglia. McCulloch e Pitts dovevano impostare i pesi a mano. L'idea nuova di Rosenblatt fu una regola che li ricavava dagli esempi. La stampa era entusiasta: nel luglio 1958 il New York Times riferì che la Marina si aspettava che un giorno la macchina avrebbe camminato, parlato, visto e sarebbe stata consapevole della propria esistenza.

Il Mark I Perceptron
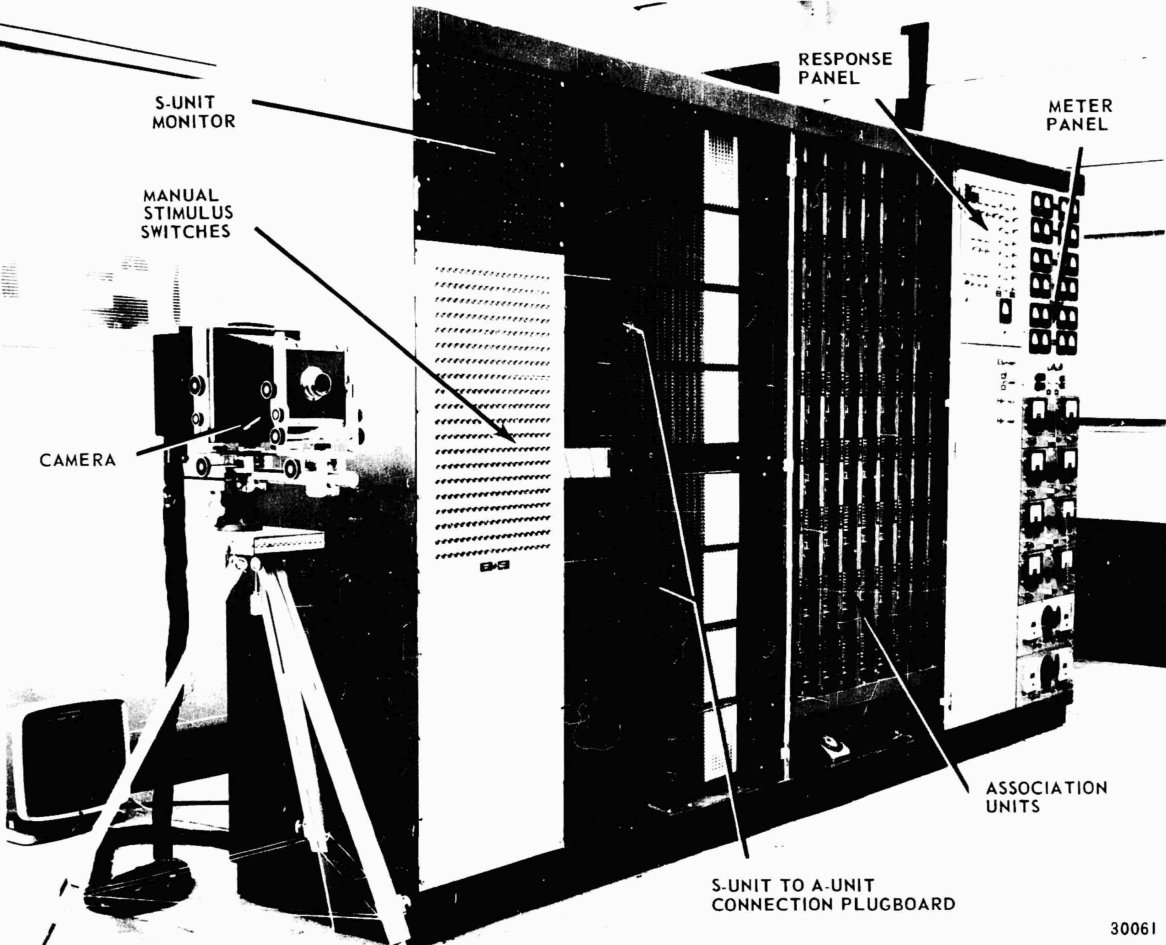
Il primo percettrone girava come programma su un IBM 704, ma Rosenblatt lo fece presto costruire come macchina a sé. Il Mark I Perceptron, completato intorno al 1960, guardava il mondo attraverso una telecamera di 400 sensori di luce disposti in una griglia di 20 per 20, collegati a caso a uno strato di unità di associazione. I suoi pesi erano potenziometri, ruotati da piccoli motori elettrici a ogni errore. Imparò a distinguere forme e lettere semplici. Oggi la macchina è conservata al National Museum of American History della Smithsonian Institution.
Un neurone, una retta
Un percettrone con due ingressi x e y calcola w₁x + w₂y + b e risponde +1 se la somma è positiva e −1 se è negativa. La somma è zero esattamente sulla retta w₁x + w₂y + b = 0, quindi il neurone divide il piano in due semipiani, uno per ogni risposta. Il vettore dei pesi (w₁, w₂) è perpendicolare alla retta e punta verso il lato +1, e il bias b allontana la retta dall'origine: senza di esso ogni confine passerebbe per (0, 0). Con più ingressi la retta diventa un piano o un iperpiano, ma l'idea resta la stessa. Il trucco di scrivere il bias come un peso w₀ su un ingresso in più che vale sempre 1 permette a una sola regola di imparare tutti i pesi.
La regola di apprendimento
L'addestramento passa in rassegna gli esempi uno alla volta. Per ogni esempio x con classe vera y, il neurone dà la sua risposta ŷ. Se ŷ è uguale a y, non succede nulla. Altrimenti ogni peso cambia di η·(y − ŷ) volte il suo ingresso: w ← w + η·(y − ŷ)·x. Per un punto +1 a cui è stato risposto −1, si aggiunge a w un multiplo di x, il che aumenta w·x di un multiplo del quadrato della lunghezza di x e spinge il punto verso il lato giusto; per un punto −1 avviene il contrario. Il tasso di apprendimento η fissa l'ampiezza del passo. Un passaggio su tutti gli esempi è un'epoca, e l'addestramento termina dopo un passaggio senza errori.
Il teorema di convergenza
Se esiste una retta che separa le due classi, il percettrone ne trova di sicuro una. Albert Novikoff dimostrò nel 1962 che, se ogni ingresso ha lunghezza al più R e la retta migliore separa le classi con un margine γ, la regola classica commette al più (R/γ)² errori, qualunque sia l'ordine degli esempi. La dimostrazione confronta due grandezze: ogni errore allinea un po' di più w alla direzione ideale, di almeno γ, mentre la lunghezza di w cresce solo come la radice quadrata del numero di errori, quindi gli errori prima o poi devono finire. La retta trovata è solo una delle tante che separano i punti, non necessariamente quella con lo spazio più ampio.
Minsky, Papert e XOR
Quando nessuna retta separa le classi, la regola non si assesta mai: ogni retta classifica male qualche punto, e quel punto la trascina di nuovo via. L'esempio più semplice è XOR, la funzione vera quando esattamente uno dei suoi due ingressi è vero. Nel loro libro Perceptrons del 1969, Marvin Minsky e Seymour Papert dimostrarono che i percettroni a uno strato non possono calcolare XOR né stabilire se una figura è connessa, e analizzarono con precisione che cosa possono calcolare. Al libro si attribuisce spesso il calo dei finanziamenti alla ricerca sulle reti neurali negli anni Settanta, anche se i suoi autori sapevano che reti con più strati potevano fare di più.
Dai percettroni alle reti neurali
Per due strati XOR è facile: un neurone calcola OR, un altro NAND, e un terzo li combina con AND. Il problema era addestrare i neuroni nascosti, perché una soglia netta non dice in che direzione girare un peso. Sostituire il gradino con una funzione liscia come la sigmoide rese l'errore derivabile, e la retropropagazione, resa popolare nel 1986 da David Rumelhart, Geoffrey Hinton e Ronald Williams, calcola quanto ogni peso di ogni strato contribuisce all'errore. Questi percettroni multistrato, diventati profondi e larghi, sono le reti neurali di oggi. Per i dati che uno strato non riesce a separare, l'algoritmo pocket di Stephen Gallant del 1990 conserva almeno la retta migliore vista durante l'addestramento.

Esploralo
Apri il visualizzatore del percettrone per addestrare un percettrone sulle porte logiche AND, OR e NAND, su punti casuali con il margine che preferisci o su punti che inserisci tu. Segui la regola di apprendimento un esempio alla volta e leggi ogni peso prima e dopo l'aggiornamento, guarda ruotare la retta e il vettore dei pesi e segui gli errori per epoca. Poi prova XOR e le nuvole sovrapposte, guarda il percettrone non riuscire a convergere e attiva l'algoritmo pocket.
Domande frequenti
Un percettrone è la stessa cosa della regressione logistica?
Entrambi sono un singolo neurone con un confine rettilineo, ma imparano in modo diverso. Il percettrone risponde solo sì o no e cambia i pesi solo dopo un errore. La regressione logistica passa la somma attraverso una sigmoide per ottenere una probabilità e regola i pesi dopo ogni esempio per rendere più probabili le risposte giuste; così continua a migliorare anche quando tutti i punti sono già dalla parte giusta, e si assesta anche su dati che nessuna retta separa.
Perché un percettrone ha bisogno di un bias?
Senza bias, w₁x + w₂y vale zero nell'origine, quindi ogni confine passerebbe per (0, 0). Le porte AND e OR sugli ingressi 0 e 1 hanno bisogno di una retta che non passi per l'origine: per AND, per esempio, 4x + 2y − 5 = 0 separa (1, 1) dagli altri tre vertici. Il bias si impara come qualsiasi altro peso, come peso di un ingresso che vale sempre 1.
Quale retta trova il percettrone?
Una qualsiasi retta che separa i punti, a seconda dei pesi iniziali e dell'ordine degli esempi. Si ferma appena non ci sono più errori, perciò la retta passa spesso vicino ad alcuni punti. Le macchine a vettori di supporto cercano invece la retta con il margine più ampio, e i percettroni votato e mediato di Yoav Freund e Robert Schapire combinano le rette viste durante l'addestramento per generalizzare meglio.
Che cos'è un percettrone multistrato?
Una rete di neuroni disposti in strati, in cui le uscite di ogni strato sono gli ingressi del successivo. Con una funzione di attivazione liscia invece di una soglia netta si può addestrare con la retropropagazione e la discesa del gradiente. Un solo strato nascosto con abbastanza neuroni può approssimare qualsiasi funzione continua su una regione limitata, e due neuroni nascosti risolvono già XOR.
Strumenti correlati
Visualizzatore del percettrone
Addestra il percettrone di Rosenblatt nel browser: segui la regola di apprendimento un esempio alla volta, guarda muoversi il confine di decisione e il vettore dei pesi, e scopri perché AND e OR si imparano ma XOR mai.

Sandbox di reti neurali
Addestra dal vivo una piccola rete neurale e guardala separare due classi di punti. Cambia strati, neuroni, attivazione, tasso di apprendimento e ingressi, e scopri a cosa reagisce ogni neurone.
Laboratorio di algoritmi genetici
Guarda dei razzi evolvere fino a raggiungere un bersaglio aggirando dei muri. Cambia popolazione, tasso di mutazione, durata di vita e selezione, disegna i tuoi ostacoli e segui quanti arrivano a ogni generazione.

Calcolatrice di matrici
Calcolatrice di matrici online gratuita: somma, sottrai, moltiplica, trasponi e inverti matrici fino a 6x6, con determinante, rango, potenze e frazioni esatte.

Plotter di funzioni
Un plotter di funzioni online gratuito: disegna x², sin x, ln x, 1/x e le tue formule su un piano interattivo. Sposta, ingrandisci, leggi x e y e salva il grafico in PNG.
Pronto a provarlo?
Apri PictorX nel tuo browser: nessuna installazione, nessuna carta di credito richiesta per iniziare.
Apri il visualizzatore del percettrone