
Le perceptron expliqué
En 1958, un psychologue présenta, dans un laboratoire de Buffalo, dans l'État de New York, une machine qui apprenait. Personne ne lui donnait la règle pour distinguer deux sortes d'images : on lui montrait des exemples, et après chaque mauvaise réponse elle tournait un peu ses propres boutons. Cette machine, le perceptron, est un seul neurone artificiel doté d'une règle d'apprentissage de quelques lignes. Il ne peut pas tout apprendre, et l'histoire de ce qu'il ne peut pas apprendre est aussi instructive que celle de ce qu'il peut apprendre.

Une machine qui apprend
Frank Rosenblatt, psychologue au Cornell Aeronautical Laboratory, décrivit le perceptron en 1958. Il s'appuyait sur le neurone artificiel proposé en 1943 par Warren McCulloch et Walter Pitts : une unité qui additionne ses entrées et s'active quand le total dépasse un seuil. McCulloch et Pitts devaient régler les poids à la main. L'idée nouvelle de Rosenblatt était une règle qui les fixait à partir d'exemples. La presse s'enthousiasma : en juillet 1958, le New York Times rapporta que la Marine s'attendait à ce que la machine puisse un jour marcher, parler, voir et avoir conscience de sa propre existence.

Le Mark I Perceptron
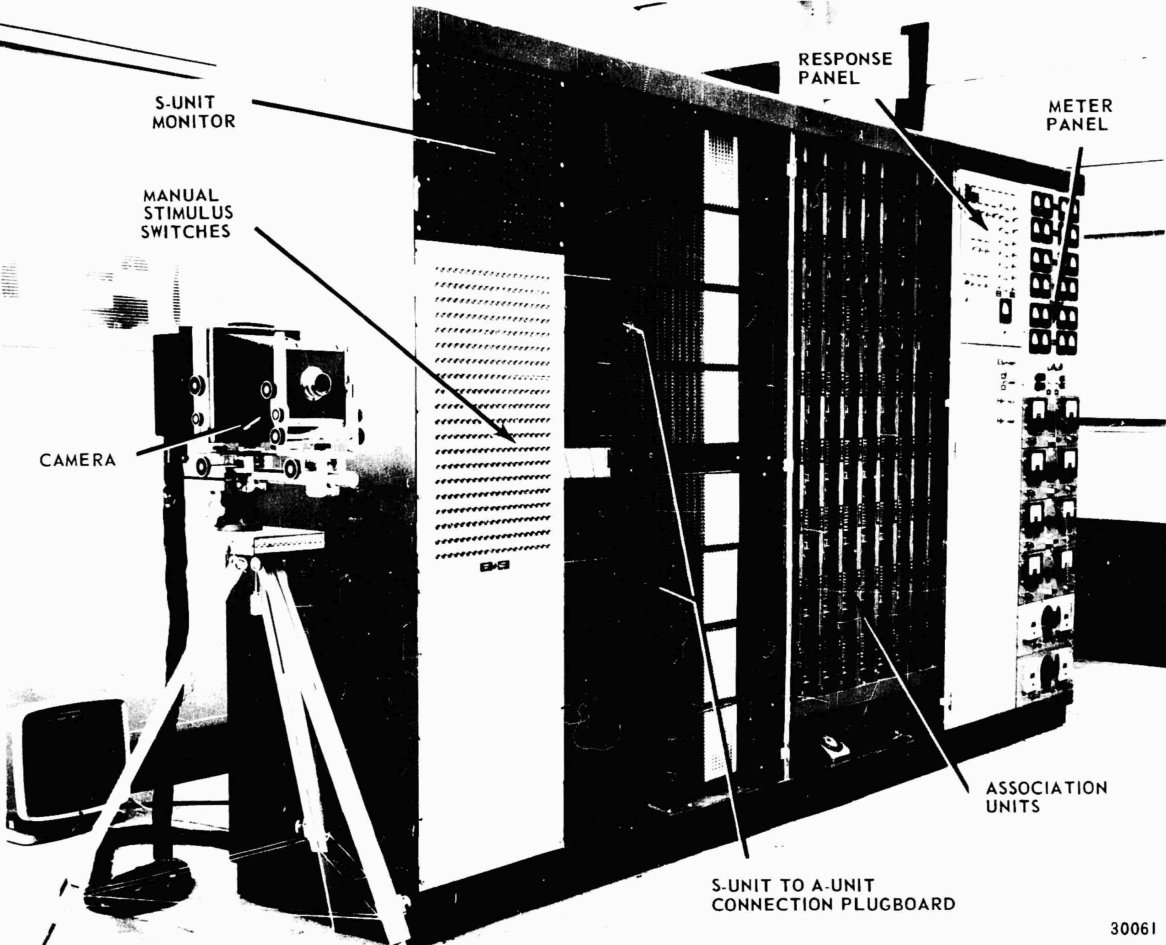
Le premier perceptron tournait comme programme sur un IBM 704, mais Rosenblatt le fit bientôt construire comme une machine à part entière. Le Mark I Perceptron, achevé vers 1960, voyait le monde à travers une caméra de 400 capteurs de lumière disposés en grille de 20 sur 20, reliés au hasard à une couche d'unités d'association. Ses poids étaient des potentiomètres, tournés par de petits moteurs électriques à chaque erreur. Il apprit à distinguer des formes et des lettres simples. La machine est aujourd'hui conservée au National Museum of American History de la Smithsonian Institution.
Un neurone, une droite
Un perceptron à deux entrées x et y calcule w₁x + w₂y + b et répond +1 si cette somme est positive et −1 si elle est négative. La somme est nulle exactement sur la droite w₁x + w₂y + b = 0 : le neurone partage donc le plan en deux demi-plans, un pour chaque réponse. Le vecteur de poids (w₁, w₂) est perpendiculaire à la droite et pointe vers le côté +1, et le biais b éloigne la droite de l'origine : sans lui, toute frontière passerait par (0, 0). Avec plus d'entrées, la droite devient un plan ou un hyperplan, mais l'idée reste la même. L'astuce qui consiste à écrire le biais comme un poids w₀ sur une entrée supplémentaire toujours égale à 1 permet à une seule règle d'apprendre tous les poids.
La règle d'apprentissage
L'entraînement passe les exemples un par un. Pour chaque exemple x de vraie classe y, le neurone donne sa réponse ŷ. Si ŷ vaut y, rien ne se passe. Sinon, chaque poids varie de η·(y − ŷ) fois son entrée : w ← w + η·(y − ŷ)·x. Pour un point +1 auquel le neurone a répondu −1, on ajoute à w un multiple de x, ce qui augmente w·x d'un multiple du carré de la longueur de x et pousse le point vers le bon côté ; pour un point −1, c'est l'inverse. Le taux d'apprentissage η règle la taille du pas. Un passage sur tous les exemples est une époque, et l'entraînement se termine après un passage sans erreur.
Le théorème de convergence
Si une droite sépare les deux classes, le perceptron est sûr d'en trouver une. Albert Novikoff a prouvé en 1962 que si chaque entrée a une longueur d'au plus R et que la meilleure droite sépare les classes avec une marge γ, la règle classique fait au plus (R/γ)² erreurs, quel que soit l'ordre des exemples. La preuve compare deux quantités : chaque erreur aligne un peu plus w sur la direction idéale, d'au moins γ, tandis que la longueur de w ne croît que comme la racine carrée du nombre d'erreurs ; les erreurs finissent donc par s'épuiser. La droite trouvée n'est qu'une parmi toutes celles qui séparent les points, pas forcément celle qui laisse l'écart le plus large.
Minsky, Papert et XOR
Quand aucune droite ne sépare les classes, la règle ne se stabilise jamais : chaque droite classe mal un point, et ce point la tire à nouveau ailleurs. L'exemple le plus simple est XOR, la fonction vraie quand exactement une de ses deux entrées est vraie. Dans leur livre Perceptrons de 1969, Marvin Minsky et Seymour Papert ont prouvé que les perceptrons à une couche ne peuvent ni calculer XOR ni dire si une figure est connexe, et ont analysé précisément ce qu'ils peuvent calculer. On accuse souvent ce livre d'avoir fait baisser le financement de la recherche sur les réseaux de neurones dans les années 1970, bien que ses auteurs aient su que des réseaux à plusieurs couches pouvaient faire davantage.
Des perceptrons aux réseaux de neurones
XOR est facile pour deux couches : un neurone calcule OR, un autre NAND, et un troisième les combine avec AND. La difficulté était d'entraîner les neurones cachés, car un seuil brutal n'indique pas dans quel sens tourner un poids. Remplacer la marche par une fonction lisse comme la sigmoïde a rendu l'erreur dérivable, et la rétropropagation, popularisée en 1986 par David Rumelhart, Geoffrey Hinton et Ronald Williams, calcule la part de chaque poids de chaque couche dans l'erreur. Ces perceptrons multicouches, devenus profonds et larges, sont les réseaux de neurones d'aujourd'hui. Pour les données qu'une seule couche ne peut séparer, l'algorithme de poche de Stephen Gallant, en 1990, garde au moins la meilleure droite vue pendant l'entraînement.

À vous d'explorer
Ouvrez le visualiseur de perceptron pour entraîner un perceptron sur les portes logiques AND, OR et NAND, sur des points aléatoires avec la marge de votre choix, ou sur des points que vous placez vous-même. Suivez la règle d'apprentissage exemple par exemple et lisez chaque poids avant et après la mise à jour, regardez tourner la droite et le vecteur de poids, et suivez les erreurs par époque. Essayez ensuite XOR et les nuages qui se chevauchent, voyez le perceptron échouer à converger, et activez l'algorithme de poche.
Questions fréquemment posées
Un perceptron est-il la même chose qu'une régression logistique ?
Tous deux sont un seul neurone avec une frontière droite, mais ils apprennent différemment. Le perceptron répond seulement oui ou non et ne change ses poids qu'après une erreur. La régression logistique fait passer la somme dans une sigmoïde pour obtenir une probabilité et ajuste ses poids après chaque exemple pour rendre les bonnes réponses plus probables ; elle continue donc de s'améliorer même quand tous les points sont déjà du bon côté, et elle se stabilise aussi sur des données qu'aucune droite ne sépare.
Pourquoi un perceptron a-t-il besoin d'un biais ?
Sans biais, w₁x + w₂y vaut zéro à l'origine, donc toute frontière passerait par (0, 0). Les portes AND et OR sur les entrées 0 et 1 ont besoin d'une droite qui évite l'origine : pour AND, par exemple, 4x + 2y − 5 = 0 sépare (1, 1) des trois autres coins. Le biais s'apprend comme n'importe quel autre poids, en tant que poids d'une entrée qui vaut toujours 1.
Quelle droite le perceptron trouve-t-il ?
N'importe quelle droite qui sépare les points, selon les poids de départ et l'ordre des exemples. Il s'arrête dès qu'il n'y a plus d'erreur, si bien que la droite passe souvent près de certains points. Les machines à vecteurs de support cherchent au contraire la droite à la marge la plus large, et les perceptrons votés et moyennés de Yoav Freund et Robert Schapire combinent les droites vues pendant l'entraînement pour mieux généraliser.
Qu'est-ce qu'un perceptron multicouche ?
Un réseau de neurones organisés en couches, où les sorties de chaque couche sont les entrées de la suivante. Avec une fonction d'activation lisse au lieu d'un seuil brutal, il s'entraîne par rétropropagation et descente de gradient. Une seule couche cachée avec assez de neurones peut approcher toute fonction continue sur une région bornée, et deux neurones cachés suffisent déjà pour XOR.
Outils associés
Visualiseur de perceptron
Entraînez le perceptron de Rosenblatt dans votre navigateur : suivez la règle d'apprentissage exemple par exemple, regardez la frontière de décision et le vecteur de poids bouger, et voyez pourquoi AND et OR s'apprennent mais jamais XOR.

Bac à sable de réseau de neurones
Entraînez en direct un petit réseau de neurones et regardez-le séparer deux classes de points. Modifiez les couches, les neurones, l'activation, le taux d'apprentissage et les entrées, et voyez ce à quoi réagit chaque neurone.
Terrain de jeu d'algorithme génétique
Regardez des fusées évoluer pour atteindre une cible en contournant des murs. Modifiez la population, le taux de mutation, la durée de vie et la sélection, dessinez vos propres obstacles et suivez combien arrivent à chaque génération.

Calculatrice matricielle
Calculatrice matricielle gratuite en ligne : additionnez, soustrayez, multipliez, transposez et inversez des matrices jusqu'à 6x6, avec déterminant, rang, puissances et fractions exactes.

Traceur de fonctions
Un traceur de fonctions gratuit en ligne : tracez x², sin x, ln x, 1/x et vos propres formules dans un repère interactif. Déplacez, zoomez, lisez x et y et enregistrez le graphique en PNG.
Prêt à l'essayer ?
Ouvrez PictorX dans votre navigateur – aucune installation, aucune carte de crédit requise pour démarrer.
Ouvrir le visualiseur de perceptron