
De perceptron uitgelegd
In 1958 liet een psycholoog in een laboratorium in Buffalo, in de staat New York, een machine zien die leerde. Niemand vertelde haar de regel om twee soorten plaatjes uit elkaar te houden: ze kreeg voorbeelden te zien, en na elk fout antwoord draaide ze een beetje aan haar eigen knoppen. Die machine, de perceptron, is één kunstmatig neuron met een leerregel van een paar regels. Hij kan niet alles leren, en het verhaal van wat hij niet kan leren is net zo leerzaam als het verhaal van wat hij wel kan.

Een machine die leert
Frank Rosenblatt, psycholoog aan het Cornell Aeronautical Laboratory, beschreef de perceptron in 1958. Hij bouwde voort op het kunstmatige neuron dat Warren McCulloch en Walter Pitts in 1943 hadden voorgesteld: een eenheid die haar invoer optelt en vuurt als het totaal een drempel overschrijdt. McCulloch en Pitts moesten de gewichten met de hand instellen. Rosenblatts nieuwe idee was een regel die ze uit voorbeelden afleidde. De pers was laaiend enthousiast: in juli 1958 meldde The New York Times dat de marine verwachtte dat de machine ooit zou kunnen lopen, praten, zien en zich bewust zou zijn van haar eigen bestaan.

De Mark I Perceptron
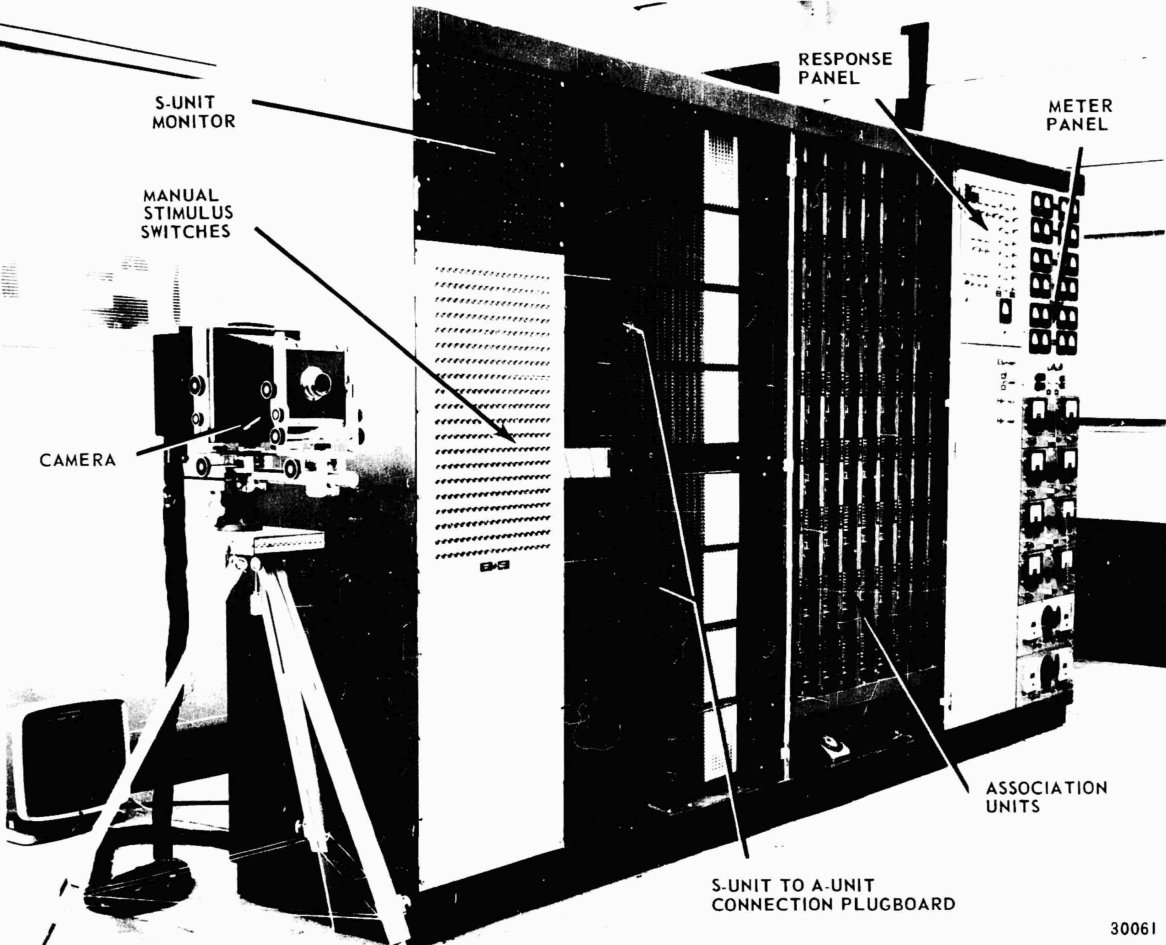
De eerste perceptron draaide als programma op een IBM 704, maar Rosenblatt liet hem al snel als eigen machine bouwen. De Mark I Perceptron, rond 1960 voltooid, keek naar de wereld via een camera van 400 lichtsensoren in een raster van 20 bij 20, willekeurig verbonden met een laag associatie-eenheden. Zijn gewichten waren potentiometers, die bij elke fout door kleine elektromotoren werden verdraaid. Hij leerde eenvoudige vormen en letters onderscheiden. De machine staat nu in het National Museum of American History van het Smithsonian.
Eén neuron, één lijn
Een perceptron met twee invoerwaarden x en y berekent w₁x + w₂y + b en antwoordt +1 als die som positief is en −1 als ze negatief is. Precies op de lijn w₁x + w₂y + b = 0 is de som nul, dus het neuron verdeelt het vlak in twee halfvlakken, één voor elk antwoord. De gewichtsvector (w₁, w₂) staat loodrecht op de lijn en wijst naar de kant van +1, en de bias b schuift de lijn weg van de oorsprong: zonder bias zou elke grens door (0, 0) gaan. Met meer invoerwaarden wordt de lijn een vlak of hypervlak, maar het idee blijft hetzelfde. De truc om de bias te schrijven als een gewicht w₀ op een extra invoer die altijd 1 is, laat één regel alle gewichten leren.
De leerregel
De training loopt de voorbeelden één voor één door. Voor elk voorbeeld x met echte klasse y geeft het neuron zijn antwoord ŷ. Is ŷ gelijk aan y, dan gebeurt er niets. Anders verandert elk gewicht met η·(y − ŷ) keer zijn invoer: w ← w + η·(y − ŷ)·x. Voor een punt van klasse +1 met antwoord −1 komt er een veelvoud van x bij w, wat w·x verhoogt met een veelvoud van de gekwadrateerde lengte van x en het punt naar de goede kant duwt; voor een punt van klasse −1 gebeurt het omgekeerde. De leersnelheid η bepaalt de stapgrootte. Eén ronde langs alle voorbeelden is een epoch, en de training eindigt na een ronde zonder fouten.
De convergentiestelling
Als er een rechte lijn bestaat die de twee klassen scheidt, vindt de perceptron er gegarandeerd een. Albert Novikoff bewees in 1962 dat als elke invoer hoogstens lengte R heeft en de beste lijn de klassen scheidt met een marge γ, de klassieke regel hoogstens (R/γ)² fouten maakt, in welke volgorde de voorbeelden ook komen. Het bewijs vergelijkt twee grootheden: elke fout richt w met minstens γ meer naar de ideale richting, terwijl de lengte van w maar groeit als de wortel uit het aantal fouten, dus raken de fouten op. De gevonden lijn is maar één van de vele die de punten scheiden, niet per se die met de breedste tussenruimte.
Minsky, Papert en XOR
Als geen rechte lijn de klassen scheidt, komt de regel nooit tot rust: elke lijn classificeert wel een punt fout, en dat punt trekt de lijn weer weg. Het eenvoudigste voorbeeld is XOR, de functie die waar is als precies één van haar twee invoerwaarden waar is. In hun boek Perceptrons uit 1969 bewezen Marvin Minsky en Seymour Papert dat perceptrons met één laag XOR niet kunnen berekenen en niet kunnen zien of een figuur samenhangend is, en ze analyseerden precies wat ze wel kunnen berekenen. Het boek krijgt vaak de schuld van de teruggang in de financiering van onderzoek naar neurale netwerken in de jaren zeventig, hoewel de auteurs wisten dat netwerken met meer lagen meer konden.
Van perceptrons naar neurale netwerken
Voor twee lagen is XOR makkelijk: één neuron berekent OR, een ander NAND, en een derde combineert ze met AND. Het probleem was het trainen van de verborgen neuronen, want een harde drempel geeft geen hint welke kant je een gewicht op moet draaien. Door de stap te vervangen door een gladde functie zoals de sigmoïde werd de fout differentieerbaar, en backpropagation, in 1986 bekend gemaakt door David Rumelhart, Geoffrey Hinton en Ronald Williams, berekent hoeveel elk gewicht in elke laag bijdraagt aan de fout. Zulke meerlaagse perceptrons, diep en breed geworden, zijn de neurale netwerken van nu. Voor data die één laag niet kan scheiden, bewaart het pocketalgoritme van Stephen Gallant uit 1990 in elk geval de beste lijn die tijdens de training voorbijkwam.

Probeer het zelf
Open de perceptron-visualizer om een perceptron te trainen op de logische poorten AND, OR en NAND, op willekeurige punten met een marge naar keuze of op punten die je zelf plaatst. Loop de leerregel voorbeeld voor voorbeeld door en lees elk gewicht voor en na de update, kijk hoe de lijn en de gewichtsvector draaien en volg de fouten per epoch. Probeer daarna XOR en de overlappende wolken, zie de perceptron er niet in slagen te convergeren en zet het pocketalgoritme aan.
Veelgestelde vragen
Is een perceptron hetzelfde als logistische regressie?
Beide zijn één neuron met een rechte grens, maar ze leren anders. De perceptron antwoordt alleen ja of nee en past zijn gewichten alleen aan na een fout. Logistische regressie stuurt de som door een sigmoïde om een kans te krijgen en past haar gewichten na elk voorbeeld aan om de goede antwoorden waarschijnlijker te maken; zo blijft ze verbeteren, ook als alle punten al aan de goede kant liggen, en komt ze ook tot rust bij data die geen rechte lijn scheidt.
Waarom heeft een perceptron een bias nodig?
Zonder bias is w₁x + w₂y nul in de oorsprong, dus zou elke grens door (0, 0) gaan. De poorten AND en OR op de invoer 0 en 1 hebben een lijn nodig die langs de oorsprong gaat: voor AND scheidt bijvoorbeeld 4x + 2y − 5 = 0 het punt (1, 1) van de andere drie hoeken. De bias wordt geleerd zoals elk ander gewicht, als het gewicht van een invoer die altijd 1 is.
Welke lijn vindt de perceptron?
Een willekeurige lijn die de punten scheidt, afhankelijk van de startgewichten en de volgorde van de voorbeelden. Hij stopt zodra er geen fouten meer zijn, dus de lijn loopt vaak vlak langs sommige punten. Support vector machines zoeken in plaats daarvan de lijn met de breedste marge, en de voted en averaged perceptron van Yoav Freund en Robert Schapire combineren de lijnen uit de training om beter te generaliseren.
Wat is een meerlaagse perceptron?
Een netwerk van neuronen in lagen, waarin de uitvoer van elke laag de invoer van de volgende is. Met een gladde activatiefunctie in plaats van een harde drempel kan het worden getraind met backpropagation en gradiëntafdaling. Eén verborgen laag met genoeg neuronen kan elke continue functie op een begrensd gebied benaderen, en twee verborgen neuronen lossen XOR al op.
Gerelateerde gereedschappen
Perceptron-visualizer
Train de perceptron van Rosenblatt in je browser: loop de leerregel voorbeeld voor voorbeeld door, zie de beslissingsgrens en de gewichtsvector bewegen, en ontdek waarom AND en OR geleerd worden maar XOR nooit.

Sandbox voor neurale netwerken
Train live een klein neuraal netwerk en kijk hoe het twee klassen punten scheidt. Verander lagen, neuronen, activatie, leersnelheid en invoer, en zie waarop elk neuron reageert.
Speeltuin voor genetische algoritmen
Kijk hoe raketten evolueren tot ze om muren heen een doel bereiken. Verander populatie, mutatiegraad, levensduur en selectie, teken je eigen obstakels en volg hoeveel er per generatie aankomen.

Matrixcalculator
Gratis online matrixcalculator: matrices tot 6x6 optellen, aftrekken, vermenigvuldigen, transponeren en inverteren, met determinant, rang, machten en exacte breuken.

Functieplotter
Een gratis online functieplotter: teken x², sin x, ln x, 1/x en je eigen formules in een interactief assenstelsel. Verschuif, zoom, lees x en y af en sla de grafiek op als PNG.
Klaar om het te proberen?
Open PictorX in je browser - geen installatie, geen creditcard nodig om te starten.
Open de perceptron-visualizer