
パーセプトロン解説
1958 年、ニューヨーク州バッファローの研究所で、ある心理学者が学習する機械を披露しました。2 種類の画像を見分ける規則は誰も教えませんでした。例を見せられ、答えを間違えるたびに、機械は自分のつまみを少しずつ回したのです。この機械、パーセプトロンは、数行で書ける学習規則を持つ 1 つの人工ニューロンです。何でも学習できるわけではなく、学習できないことの物語は、学習できることの物語と同じくらい多くを教えてくれます。

学習する機械
コーネル航空研究所の心理学者フランク・ローゼンブラットは、1958 年にパーセプトロンを発表しました。土台にしたのは、ウォーレン・マカロックとウォルター・ピッツが 1943 年に提案した人工ニューロンです。入力を足し合わせ、合計がしきい値を超えると発火する素子です。マカロックとピッツは重みを手で設定しなければなりませんでした。ローゼンブラットの新しい発想は、例から重みを決める規則でした。報道は熱狂しました。1958 年 7 月、ニューヨーク・タイムズ紙は、海軍がこの機械はいつか歩き、話し、見て、自分の存在を意識するようになると期待していると伝えました。

Mark I パーセプトロン
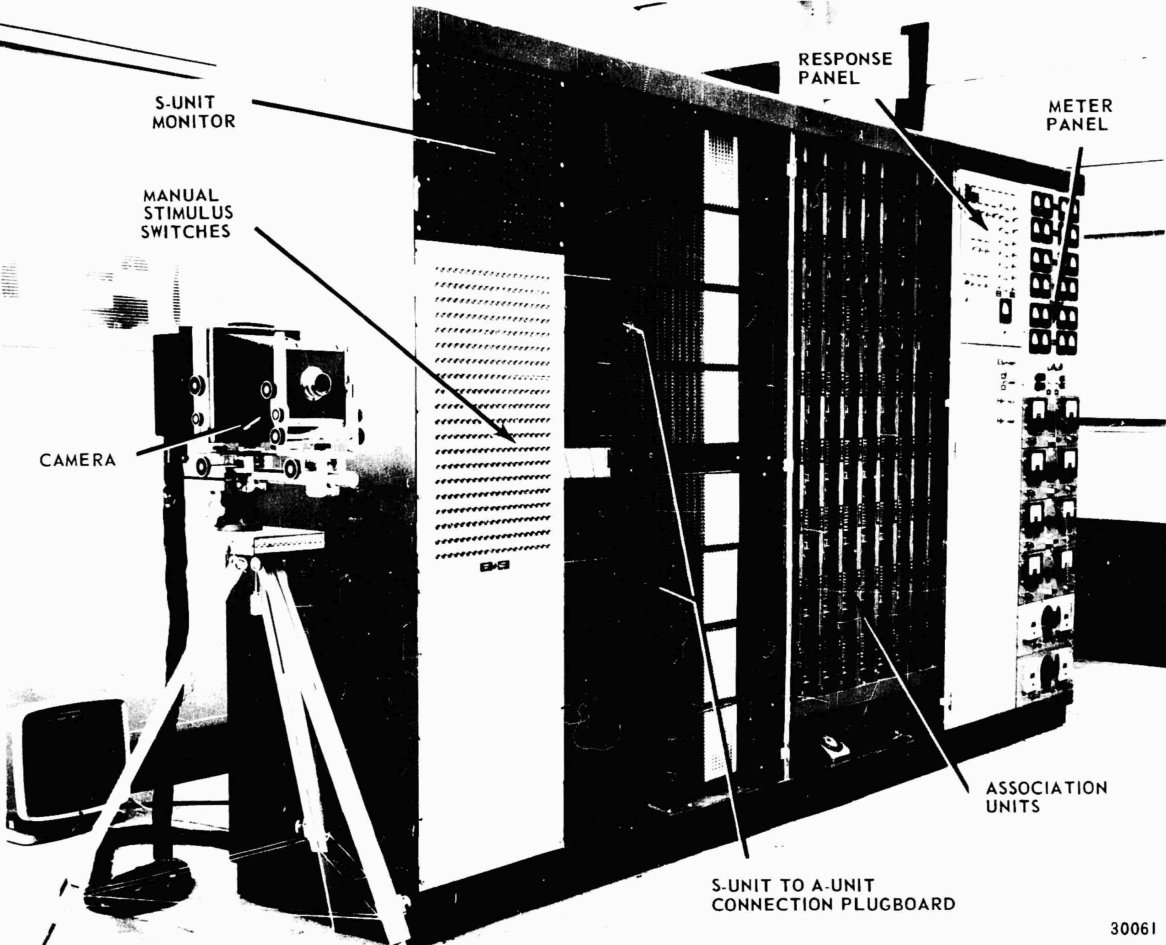
最初のパーセプトロンは IBM 704 上のプログラムとして動きましたが、ローゼンブラットはまもなく専用の機械として作らせました。1960 年ごろに完成した Mark I パーセプトロンは、20 × 20 の格子に並んだ 400 個の光センサーからなるカメラで世界を見ており、センサーは連合ユニットの層にランダムにつながっていました。重みはポテンショメーターで、誤るたびに小さな電動モーターが回しました。簡単な図形や文字を見分けることを学びました。この機械は現在、スミソニアン協会の国立アメリカ歴史博物館に保管されています。
1 つのニューロン、1 本の直線
2 つの入力 x と y を持つパーセプトロンは w₁x + w₂y + b を計算し、和が正なら +1、負なら −1 と答えます。和がちょうどゼロになるのは直線 w₁x + w₂y + b = 0 の上なので、ニューロンは平面を答えごとに 1 つずつ、2 つの半平面に分けます。重みベクトル (w₁, w₂) は直線に垂直で +1 の側を向き、バイアス b は直線を原点から遠ざけます。バイアスがなければ、どの境界も (0, 0) を通ってしまいます。入力が増えると直線は平面や超平面になりますが、考え方は同じです。バイアスを、常に 1 である追加の入力にかかる重み w₀ として書く工夫により、1 つの規則ですべての重みを学習できます。
学習規則
学習ではサンプルを 1 つずつ順にたどります。本当のクラスが y であるサンプル x ごとに、ニューロンは答え ŷ を出します。ŷ が y と等しければ何も起こりません。そうでなければ、各重みは入力の η·(y − ŷ) 倍だけ変わります。w ← w + η·(y − ŷ)·x です。−1 と答えられたクラス +1 の点では、w に x の何倍かが加わり、w·x が x の長さの 2 乗の何倍か増えて、点は正しい側へ押されます。クラス −1 の点ではその逆です。学習率 η が一歩の大きさを決めます。すべてのサンプルを 1 周するのが 1 エポックで、誤りのない周回が終わると学習は完了します。
収束定理
2 つのクラスを分ける直線があるなら、パーセプトロンは必ずそのような直線を見つけます。アルバート・ノヴィコフは 1962 年に、どの入力の長さも R 以下で、最良の直線がマージン γ でクラスを分けているなら、サンプルの順序にかかわらず古典的な規則の誤りは多くても (R/γ)² 回であることを証明しました。証明は 2 つの量を比べます。誤るたびに w は理想の方向へ少なくとも γ ずつ揃っていきますが、w の長さは誤りの回数の平方根のようにしか伸びないので、誤りはいずれ尽きるのです。見つかる直線は点を分ける多くの直線の 1 つにすぎず、隙間がいちばん広い直線とは限りません。
ミンスキー、パパート、そして XOR
どの直線でもクラスを分けられないとき、規則は決して落ち着きません。どの直線もどこかの点を誤分類し、その点が直線をまた引き離すからです。いちばん単純な例が XOR、つまり 2 つの入力のちょうど一方が真のときに真になる関数です。マービン・ミンスキーとシーモア・パパートは 1969 年の著書『パーセプトロン』で、単層パーセプトロンは XOR を計算できず、図形がつながっているかどうかも判定できないことを証明し、何を計算できるのかを厳密に分析しました。この本は 1970 年代にニューラルネットワーク研究の資金が減った原因としてよく挙げられますが、著者たちは層を増やしたネットワークならもっと多くのことができると知っていました。
パーセプトロンからニューラルネットワークへ
2 層なら XOR は簡単です。1 つのニューロンが OR を、別のニューロンが NAND を計算し、3 つ目がそれらを AND で組み合わせます。難しかったのは隠れニューロンの学習でした。硬いしきい値では、重みをどちらへ回せばよいか手がかりが得られないからです。階段関数をシグモイドのような滑らかな関数に置き換えると誤差が微分可能になり、1986 年にデビッド・ラメルハート、ジェフリー・ヒントン、ロナルド・ウィリアムズが広めた誤差逆伝播法によって、各層の各重みが誤差にどれだけ寄与しているかを計算できるようになりました。深く広くなったこうした多層パーセプトロンが、今日のニューラルネットワークです。1 層では分けられないデータに対しては、スティーブン・ギャラントの 1990 年のポケットアルゴリズムが、少なくとも学習中に現れた最良の直線を保持します。

試してみよう
パーセプトロン可視化を開いて、論理ゲート AND、OR、NAND や、好きなマージンを付けたランダムな点、あるいは自分で置いた点でパーセプトロンを学習させてみましょう。学習規則をサンプルごとにたどって更新の前と後の重みを読み、直線と重みベクトルが回転する様子を見ながら、エポックごとの誤りを追いかけます。続いて XOR や重なり合う雲を試し、パーセプトロンが収束できない様子を確かめてから、ポケットアルゴリズムをオンにしてみてください。
よくある質問
パーセプトロンはロジスティック回帰と同じものですか?
どちらも直線の境界を持つ 1 つのニューロンですが、学習の仕方が違います。パーセプトロンは「はい」か「いいえ」でしか答えず、誤ったときにだけ重みを変えます。ロジスティック回帰は和をシグモイドに通して確率を求め、正しい答えがより起こりやすくなるよう、サンプルごとに重みを調整します。そのため、すべての点がすでに正しい側にあっても改善を続け、どの直線でも分けられないデータでも落ち着きます。
なぜパーセプトロンにはバイアスが必要なのですか?
バイアスがないと w₁x + w₂y は原点でゼロになるので、どの境界も (0, 0) を通ってしまいます。入力 0 と 1 の AND ゲートや OR ゲートには、原点を通らない直線が必要です。たとえば AND では、4x + 2y − 5 = 0 が (1, 1) を残りの 3 つの角から分けます。バイアスは、常に 1 である入力の重みとして、ほかの重みと同じように学習されます。
パーセプトロンはどの直線を見つけるのですか?
初期重みとサンプルの順序によって、点を分ける直線のどれか 1 本です。誤りがなくなった時点で止まるので、直線はしばしば一部の点のすぐそばを通ります。サポートベクターマシンは代わりにマージンが最も広い直線を探し、ヨアヴ・フロイントとロバート・シャピアの投票型パーセプトロンや平均化パーセプトロンは、学習中に現れた直線を組み合わせて汎化性能を高めます。
多層パーセプトロンとは何ですか?
ニューロンを層状に並べたネットワークで、各層の出力が次の層の入力になります。硬いしきい値の代わりに滑らかな活性化関数を使えば、誤差逆伝播法と勾配降下法で学習させられます。十分な数のニューロンを持つ隠れ層が 1 つあれば、有界な領域上の任意の連続関数を近似でき、隠れニューロンが 2 つあれば XOR はもう解けます。
関連ツール
パーセプトロン可視化
ローゼンブラットのパーセプトロンをブラウザーで学習させましょう。学習規則をサンプルごとにたどり、決定境界と重みベクトルが動く様子を見て、AND と OR は学習できるのに XOR は決して学習できない理由を確かめられます。

ニューラルネットワーク・サンドボックス
小さなニューラルネットワークをリアルタイムで訓練し、2つのクラスの点を分ける様子を見られます。層、ニューロン、活性化関数、学習率、入力を変えて、各ニューロンが何に反応するかを確かめましょう。
遺伝的アルゴリズム・プレイグラウンド
ロケットが壁を回り込んで目標にたどり着くよう進化する様子を見てみましょう。個体数、突然変異率、寿命、選択方式を変え、障害物を自分で描き、各世代で何機が到達するかを追えます。

行列計算機
無料のオンライン行列計算機:6x6 までの行列の加算、減算、乗算、転置、逆行列を、行列式・階数・累乗・厳密な分数で計算します。

関数グラフ描画
無料のオンライン関数グラフ描画ツール。x²、sin x、ln x、1/x や自分の式をインタラクティブな座標平面に描けます。移動、拡大縮小、x と y の読み取り、PNG 保存に対応。
試してみますか?
ブラウザで PictorX を開きます。インストール不要、始めるのにクレジットカードも不要です。
パーセプトロン可視化を開く