
- Trainingspunten
- Testpunten
- Beslissingsgrens
- Trainingsverlies
- Testverlies
Sandbox voor neurale netwerken
Een neuraal netwerk is een stapel eenvoudige eenheden die gewogen invoer optellen en de som door een knik sturen. Op zichzelf kan elke eenheid alleen een rechte lijn trekken, maar samen kunnen ze een cirkel, een spiraal of wat dan ook volgen. Kies een dataset, bouw een netwerk met maximaal vier verborgen lagen, druk op Trainen en kijk hoe de grens tussen blauw en oranje epoch na epoch in vorm buigt, terwijl elk neuron laat zien welk deel van het patroon het heeft leren herkennen. Kies een dataset en een netwerk, druk dan op Trainen en kijk hoe het netwerk leert de blauwe punten van de oranje te scheiden. Gevulde punten trainen het netwerk; ringen zijn testpunten waarop het nooit traint. De achtergrond toont het antwoord van het netwerk voor elk punt van het vlak, en de lijn is waar het van mening verandert. In het diagram laat elk neuron zien waarop het reageert, en elke verbinding is blauw bij een positief gewicht en oranje bij een negatief, en dikker naarmate het gewicht groter is. Klik in het vlak om punten toe te voegen in de kleur die onder Klik voegt toe is gekozen.
Hoe het werkt
- Kies een dataset, van twee wolken die een rechte lijn kan scheiden tot een spiraal die meerdere lagen nodig heeft, of klik in het vlak om je eigen punten te plaatsen.
- Stel de verborgen lagen, de neuronen per laag, de activatie, de leersnelheid en de invoer van het netwerk in.
- Druk op Trainen en volg de grens, de neuronen en het verlies; vergelijk het trainingsverlies met het testverlies om overfitting op te sporen.
Wat het netwerk doet
Elk neuron vermenigvuldigt zijn invoer met gewichten, telt er een bias bij op en stuurt het totaal door een activatiefunctie zoals tanh of ReLU. De neuronen van de eerste verborgen laag verdelen het vlak elk langs één rechte lijn, verzacht tot een geleidelijke overgang. De volgende laag combineert die halfvlakken tot wiggen, banden en vlekken, en het uitvoerneuron zet het resultaat om in een kans op blauw. De achtergrond van het vlak toont die kans overal, en de donkere lijn is waar die precies een half is: de beslissingsgrens.
Hoe het leert
Het trainen begint met willekeurige gewichten. Voor een kleine batch trainingspunten vergelijkt het netwerk zijn antwoorden met de echte kleuren, en backpropagation berekent, van de uitvoer terug naar de invoer, hoeveel elk gewicht aan de fout heeft bijgedragen. Elk gewicht verschuift dan een kleine stap, de leersnelheid, in de richting die het verlies verlaagt. Eén doorgang over alle trainingspunten is een epoch. Een te kleine leersnelheid maakt de vooruitgang traag; een te grote laat het verlies heen en weer springen of exploderen. De testpunten worden nooit gebruikt om te trainen, dus het testverlies laat zien hoe goed het netwerk generaliseert.
Veelgestelde vragen
Waarom kan een netwerk zonder verborgen lagen de cirkel of XOR niet leren?
Zonder verborgen lagen is de uitvoer een functie van één gewogen som van de invoer, dus is de grens een rechte lijn. Geen enkele rechte lijn legt de binnenkant van een cirkel aan de ene kant en de ring aan de andere, of scheidt de twee diagonalen van XOR. Marvin Minsky en Seymour Papert wezen hier in 1969 op voor perceptrons met één laag. Een verborgen laag lost het op, en een extra invoer ook: met x² en y² wordt de cirkel een rechte snede, en met x·y geldt dat ook voor XOR.
Wat is overfitting, en hoe zie ik het hier?
Een netwerk overfit wanneer het de trainingspunten uit het hoofd leert, ruis inbegrepen, in plaats van het patroon erachter. Kies een dataset met veel ruis en weinig punten en een groot netwerk, en train lang: het trainingsverlies blijft dalen terwijl het testverlies afvlakt en begint te stijgen, en de grens krijgt eilandjes rond losse punten. Minder neuronen, meer punten of eerder stoppen helpen.
Welke activatiefunctie moet ik gebruiken?
Tanh geeft vloeiende, ronde grenzen en traint goed op deze kleine problemen. ReLU, die nul is voor negatieve sommen en anders de som zelf, is de standaard in moderne deep learning en geeft grenzen die uit rechte stukken bestaan. Sigmoïde leert langzamer in verborgen lagen omdat de helling klein is. Lineair maakt elke verborgen laag zinloos: een stapel lineaire lagen is nog steeds één lineaire functie, dus de grens blijft recht.
Wat betekenen de kleine plaatjes in het netwerkdiagram?
Elk plaatje toont de uitvoer van een neuron voor elk punt van het vlak, blauw voor hoog en oranje voor laag. Invoerneuronen tonen x, y en de andere invoer, de eerste verborgen laag toont zachte halfvlakken, en diepere neuronen tonen de complexere vormen die daaruit zijn opgebouwd. De verbindingen zijn blauw bij positieve gewichten en oranje bij negatieve, en dikker naarmate het gewicht groter is.
Wordt er iets naar een server gestuurd?
Nee. De data, het netwerk en het trainen draaien allemaal in je browser in gewoon JavaScript, zonder machine-learningbibliotheek. Je instellingen en de punten die je aanklikt, blijven in de lokale opslag van deze browser.
Gerelateerde gereedschappen

Neurale netwerken uitgelegd
Hoe een neuraal netwerk werkt, van één neuron tot verborgen lagen: gewichten en biases, activatiefuncties, het verlies, gradiëntafdaling, backpropagation, de leersnelheid en overfitting.

Perceptron-visualizer
Train de perceptron van Rosenblatt in je browser: loop de leerregel voorbeeld voor voorbeeld door, zie de beslissingsgrens en de gewichtsvector bewegen, en ontdek waarom AND en OR geleerd worden maar XOR nooit.

Functieplotter
Een gratis online functieplotter: teken x², sin x, ln x, 1/x en je eigen formules in een interactief assenstelsel. Verschuif, zoom, lees x en y af en sla de grafiek op als PNG.

Matrixcalculator
Gratis online matrixcalculator: matrices tot 6x6 optellen, aftrekken, vermenigvuldigen, transponeren en inverteren, met determinant, rang, machten en exacte breuken.

Statistiekcalculator
Gratis online statistiekcalculator: plak getallen en zie direct gemiddelde, mediaan, modus, variantie, standaardafwijking, kwartielen en een histogram.
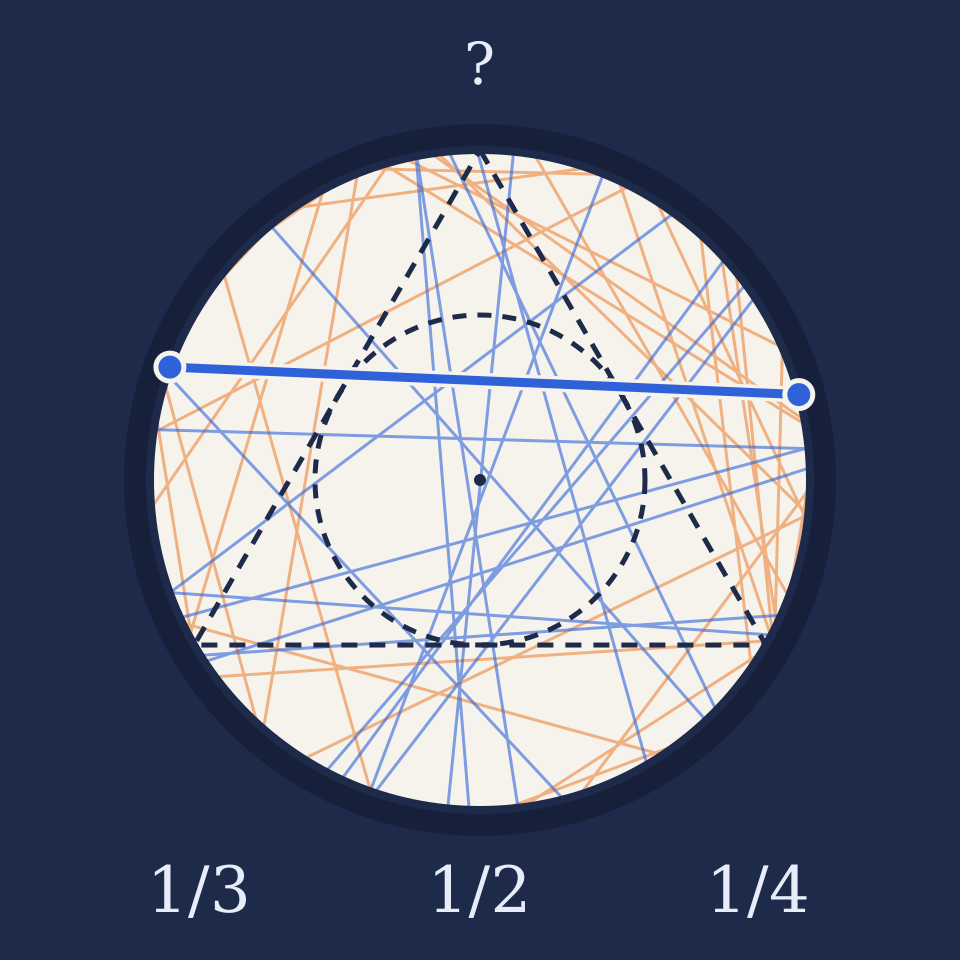
Paradox van Bertrand
Trek op vier manieren willekeurige koorden in een cirkel en zie het aandeel dat langer is dan de zijde van de driehoek uitkomen op 1/3, 1/2 of 1/4. Bekijk de middelpunten, de theoriecurve en de strootjes van Jaynes.

Cellulaire automaten
Draai Conway's Game of Life, Rule 30, Rule 110, Brian's Brain en Wireworld in je browser. Teken cellen, wijzig de regel en zie hoe eenvoudige regels complexe patronen laten groeien.
Klaar om het te proberen?
Open PictorX in je browser - geen installatie, geen creditcard nodig om te starten.
Ga naar Editor