
- Træningspunkter
- Testpunkter
- Beslutningsgrænse
- Træningstab
- Testtab
Sandkasse til neurale netværk
Et neuralt netværk er en stak af simple enheder, der lægger vægtede input sammen og sender summen gennem et knæk. Alene kan hver enhed kun tegne en ret linje, men sammen kan de følge en cirkel, en spiral eller hvad som helst andet. Vælg et datasæt, byg et netværk med op til fire skjulte lag, tryk på Træn, og se grænsen mellem blå og orange bøje sig på plads, epoke for epoke, mens hver neuron viser den del af mønstret, den har lært at genkende. Vælg et datasæt og et netværk, tryk så på Træn, og se netværket lære at adskille de blå punkter fra de orange. Udfyldte punkter træner netværket; ringe er testpunkter, som det aldrig trænes på. Baggrunden viser netværkets svar for hvert punkt i planen, og linjen er der, hvor det skifter mening. I diagrammet viser hver neuron, hvad den reagerer på, og hver forbindelse er blå for en positiv vægt og orange for en negativ, tykkere jo større vægten er. Klik i planen for at tilføje punkter i den farve, der er valgt under Klik tilføjer.
Sådan virker det
- Vælg et datasæt, fra to klynger, som en ret linje kan adskille, til en spiral, der kræver flere lag, eller klik i planen for at placere dine egne punkter.
- Indstil de skjulte lag, neuronerne pr. lag, aktiveringen, læringsraten og de input, netværket får.
- Tryk på Træn, og hold øje med grænsen, neuronerne og tabet; sammenlign træningstabet med testtabet for at opdage overfitting.
Hvad netværket gør
Hver neuron ganger sine input med vægte, lægger en bias til og sender summen gennem en aktiveringsfunktion som tanh eller ReLU. Neuronerne i det første skjulte lag deler hver planen langs én ret linje, blødt op til en glidende overgang. Det næste lag kombinerer disse halvplaner til kiler, bånd og klatter, og outputneuronen gør resultatet til en sandsynlighed for blå. Planens baggrund viser denne sandsynlighed overalt, og den mørke linje er der, hvor den er præcis en halv: beslutningsgrænsen.
Hvordan det lærer
Træningen starter fra tilfældige vægte. For en lille batch af træningspunkter sammenligner netværket sine svar med de rigtige farver, og backpropagation regner ud, fra outputtet tilbage til inputtene, hvor meget hver vægt bidrog til fejlen. Hver vægt flytter sig så et lille skridt, læringsraten, i den retning, der sænker tabet. Én gennemgang af alle træningspunkter er en epoke. En for lille læringsrate gør fremskridtet langsomt; en for stor får tabet til at hoppe rundt eller eksplodere. Testpunkterne bruges aldrig til træning, så testtabet viser, hvor godt netværket generaliserer.
Ofte stillede spørgsmål
Hvorfor kan et netværk uden skjulte lag ikke lære cirklen eller XOR?
Uden skjulte lag er outputtet en funktion af én vægtet sum af inputtene, så grænsen er en ret linje. Ingen ret linje lægger det indre af en cirkel på den ene side og ringen på den anden eller adskiller de to diagonaler i XOR. Marvin Minsky og Seymour Papert påpegede dette for perceptroner med ét lag i 1969. Et skjult lag løser det, og det gør et ekstra input også: med x² og y² bliver cirklen et lige snit, og med x·y gælder det samme for XOR.
Hvad er overfitting, og hvordan ser jeg det her?
Et netværk overfitter, når det lærer træningspunkterne udenad, støj inklusive, i stedet for mønstret bag dem. Vælg et datasæt med meget støj og få punkter og et stort netværk, og træn længe: træningstabet bliver ved med at falde, mens testtabet flader ud og begynder at stige, og grænsen får små øer omkring enkelte punkter. Færre neuroner, flere punkter eller at stoppe tidligere hjælper.
Hvilken aktiveringsfunktion skal jeg bruge?
Tanh giver glatte, afrundede grænser og træner godt på disse små problemer. ReLU, som er nul for negative summer og ellers selve summen, er standardvalget i moderne deep learning og giver grænser, der består af lige stykker. Sigmoid lærer langsommere i skjulte lag, fordi dens hældning er lille. Lineær gør ethvert skjult lag meningsløst: en stak af lineære lag er stadig én lineær funktion, så grænsen forbliver ret.
Hvad betyder de små billeder i netværksdiagrammet?
Hvert billede viser en neurons output for hvert punkt i planen, blå for højt og orange for lavt. Inputneuroner viser x, y og de andre input, det første skjulte lag viser bløde halvplaner, og dybere neuroner viser de mere komplekse former, der er bygget af dem. Forbindelserne er blå for positive vægte og orange for negative, tykkere jo større vægten er.
Bliver noget sendt til en server?
Nej. Data, netværket og træningen kører alt sammen i din browser i almindelig JavaScript uden noget maskinlæringsbibliotek. Dine indstillinger og de punkter, du klikker ind, bliver i denne browsers lokale lager.
Relaterede værktøjer

Neurale netværk forklaret
Hvordan et neuralt netværk fungerer, fra en enkelt neuron til skjulte lag: vægte og bias, aktiveringsfunktioner, tabet, gradientnedstigning, backpropagation, læringsraten og overfitting.

Perceptron-visualisering
Træn Rosenblatts perceptron i din browser: Gå læringsreglen igennem ét eksempel ad gangen, se beslutningsgrænsen og vægtvektoren flytte sig, og se, hvorfor AND og OR bliver lært, men XOR aldrig.

Funktionsplotter
En gratis online funktionsplotter: tegn x², sin x, ln x, 1/x og dine egne formler i et interaktivt koordinatsystem. Panorér, zoom, aflæs x og y, og gem grafen som PNG.

Matrixberegner
Gratis online matrixberegner: læg sammen, træk fra, gang, transponér og invertér matricer op til 6x6, med determinant, rang, potenser og eksakte brøker.

Statistikberegner
Gratis online statistikberegner: indsæt tal og få straks gennemsnit, median, typetal, varians, standardafvigelse, kvartiler og histogram.
Bertrands paradoks
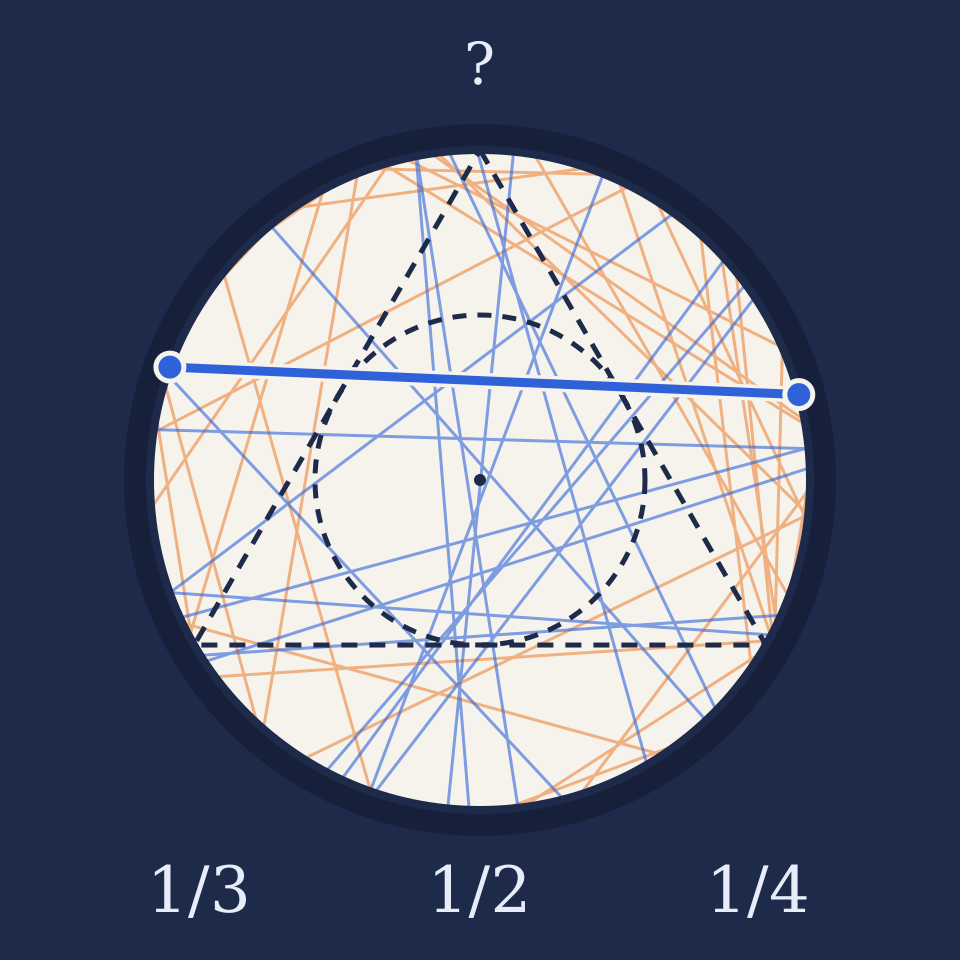
Træk tilfældige korder i en cirkel på fire måder, og se andelen, der er længere end trekantens side, falde til ro ved 1/3, 1/2 eller 1/4. Se midtpunkterne, teorikurven og Jaynes' strå.

Cellulære automater
Kør Conways Game of Life, Regel 30, Regel 110, Brian's Brain og Wireworld i din browser. Tegn celler, skift reglen, og se simple regler vokse til komplekse mønstre.
Er du klar til at prøve?
Åbn PictorX i din browser – ingen installation og intet kreditkort for at komme i gang.
Gå til Editor