
最长公共子序列(LCS)
比较一个文件的两个版本时,没有改变的行就是两者的一个公共子序列。找出最长的那个,就能准确知道增加了什么、删除了什么。同样的思想还能比对 DNA 链、提供拼写纠正建议,而解决它的,是计算机科学中最优雅的表格之一。
问题
一个单词的子序列按原来的顺序保留它的部分字母:ACE 是 ABCDE 的子序列,但 EA 不是。两个单词的公共子序列是同时属于两者的子序列,问题就是找出最长的那个。长度为 n 的单词有 2ⁿ 个子序列,所以只要超过几个字母,逐一尝试就毫无希望。
表格
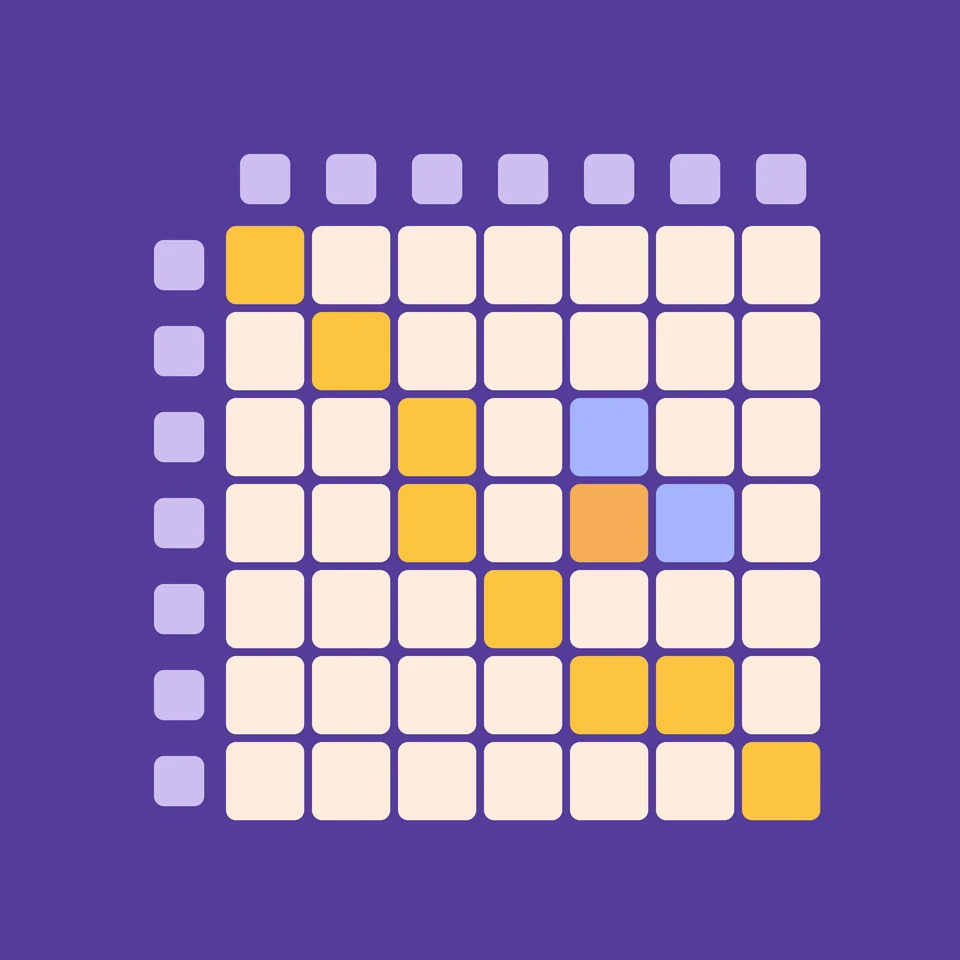
设 len[i][j] 为一个单词的前 i 个字母与另一个单词的前 j 个字母的最长公共子序列长度。空单词与任何单词都没有共同部分,所以第一行和第一列都是 0。如果第 i 个字母等于第 j 个字母,则 len[i][j] = len[i − 1][j − 1] + 1:这次匹配延长了它之前的结果。否则,len[i][j] 取 len[i − 1][j] 和 len[i][j − 1] 中较大的值:去掉两个字母中的一个,保留更好的结果。
一个例子
比较 ABCBDAB 和 BDCABA。第二个单词的第一个字母 B 与第 2 行的 B 匹配;第三列的 C 与第 3 行匹配,以此类推,每次匹配都在左上方格子的基础上加一。右下角的格子最终为 4。从那里倒推得到 BCBA,但 BCAB 和 BDAB 一样长:最长公共子序列不一定唯一。
倒推出答案
从右下角的格子开始。如果它所在行和列的字母相同,该字母就属于答案:记下它,并沿对角线向左上方走一步。否则走向上方或左侧值较大的相邻格子,因为这个格子的值就是从那里来的。到达第一行或第一列时停止。把记下的字母倒过来,就是子序列。
历史与应用
大约在 1970 年,有几个人各自独立地发现了这种表格方法,其中包括 Robert Wagner 和 Michael Fischer,他们 1974 年的论文解决了与之密切相关的编辑距离问题。1975 年,Dan Hirschberg 展示了如何用少得多的内存找出子序列;1976 年,James Hunt 和 Douglas McIlroy 基于行的最长公共子序列编写了 Unix diff 程序。生物学家用同样的思想(再加上评分)来比对 DNA 和蛋白质序列。
动手探索
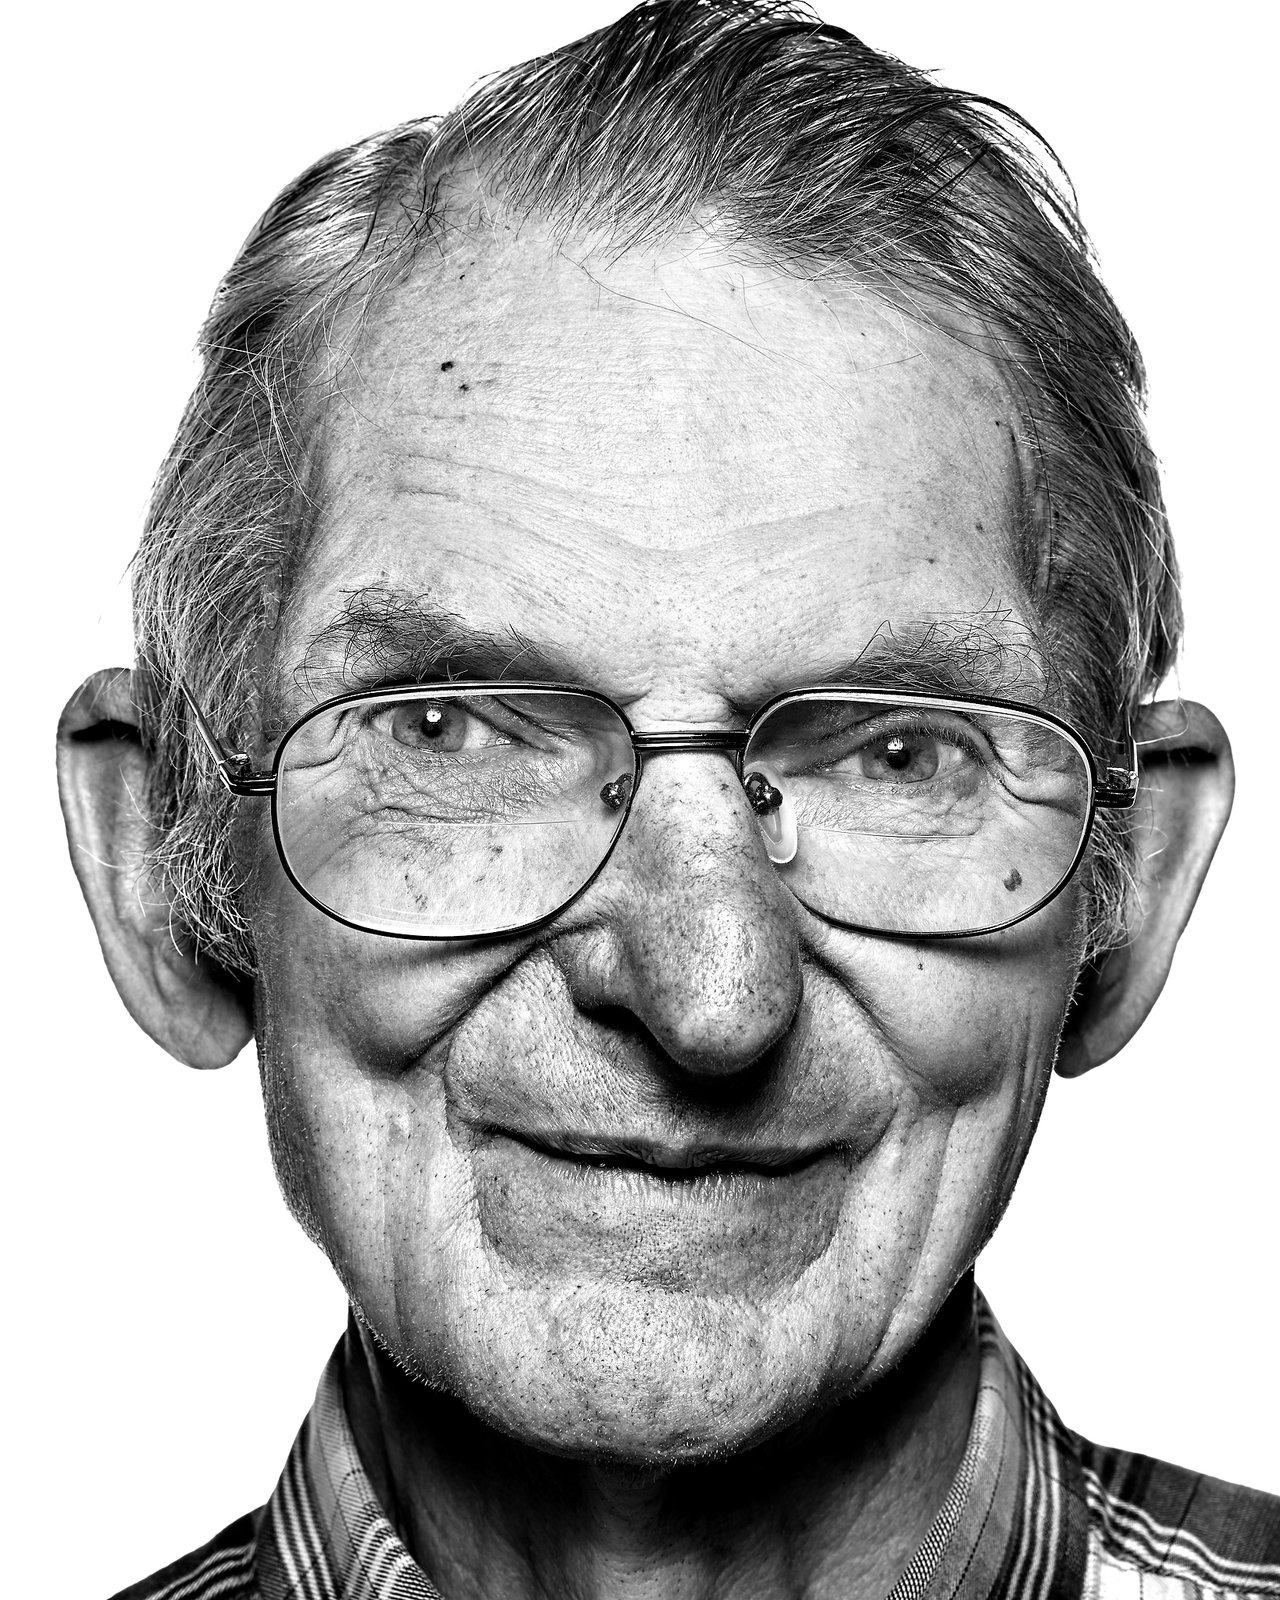
打开应用,按“单步”。正在比较的两个字母会在表头中亮起;匹配时读取左上方的蓝色格子,不匹配时读取上方和左侧的两个蓝色格子。表格填满后,橙色路径从角落往回攀升,答案的字母出现在表格下方。
常见问题
LCS 算法需要多少时间和内存?
对于长度为 m 和 n 的单词,需要 O(m·n) 的时间。要倒推出答案,完整的表格也需要 O(m·n) 的内存;Dan Hirschberg 在 1975 年展示了如何只用 O(min(m, n)) 的内存找出子序列本身。
diff 如何使用最长公共子序列?
它把文件的每一行当作一个符号,找出两个文件各行的最长公共子序列。在这个子序列中的行没有改变;旧文件中的其他行被删除了,新文件中的其他行是新增的。
三个或更多单词呢?
每多一个单词,表格就多一个维度,所以三个长度为 n 的单词需要 n³ 个格子。对于任意数量的单词,这个问题是 NP 困难的。
LCS 和编辑距离有什么关系?
如果只允许插入和删除,两个单词的编辑距离等于它们的总长度减去最长公共子序列长度的两倍。如果还允许替换,得到的就是 Levenshtein 距离,它用一张非常相似的表格计算。
相关工具
最长公共子序列(LCS)
一步一步观看如何找出两个单词的最长公共子序列。看每个格子比较两个字母、根据相邻格子填值,再从角落倒推出共有的字母。
编辑距离(莱文斯坦距离)
求两个单词之间的编辑距离,并逐步观看 Levenshtein 表格的填充过程。看每个单元格如何在插入、删除和替换之间做出选择,再从角落回溯出编辑操作。
最长递增子序列(LIS)
一步步观看如何找出列表的最长递增子序列。查看每个值与它前面的值的比较、以每个位置结尾的最佳序列的长度,以及倒推读出的答案。
背包问题
按千克和美元把物品装进背包,找出价值最高的装法,并在表格中一步步观看动态规划如何求解 0/1 背包问题。
用动态规划求斐波那契数
观看斐波那契数如何一次一个加法地填满表格。比较自底向上的制表法和自顶向下的记忆化,查看调用栈,并统计朴素递归需要多少次调用。
准备好尝试了吗?
在浏览器中打开 PictorX — 无需安装,无需信用卡即可启动。
试试最长公共子序列