
Längsta gemensamma delsekvens (LCS)
När du jämför två versioner av en fil är raderna som inte har ändrats en gemensam delsekvens av båda. Hittar du den längsta vet du exakt vad som lagts till och vad som tagits bort. Samma idé används för att rada upp DNA-strängar och föreslå stavningsrättelser, och den löses med en av de mest eleganta tabellerna inom datavetenskapen.
Problemet
En delsekvens av ett ord behåller några av dess bokstäver i deras ursprungliga ordning: ACE är en delsekvens av ABCDE, men EA är det inte. En gemensam delsekvens av två ord är en delsekvens av båda, och problemet är att hitta den längsta. Ett ord med längden n har 2ⁿ delsekvenser, så att pröva alla är hopplöst så snart det är mer än några få bokstäver.
Tabellen
Låt len[i][j] vara längden på den längsta gemensamma delsekvensen av de första i bokstäverna i det ena ordet och de första j bokstäverna i det andra. Ett tomt ord har inget gemensamt med något, så första raden och kolumnen är 0. Om bokstav i är lika med bokstav j är len[i][j] = len[i − 1][j − 1] + 1: matchningen förlänger det som kom före. Annars är len[i][j] det största av len[i − 1][j] och len[i][j − 1]: släpp en av de två bokstäverna och behåll det bästa resultatet.
Ett exempel
Jämför ABCBDAB med BDCABA. Den första bokstaven i det andra ordet, B, matchar B:et på rad 2; C:et i tredje kolumnen matchar rad 3, och så vidare, och varje matchning lägger till ett till cellen snett upp till vänster. Cellen längst ned till höger slutar på 4. Läser man tillbaka därifrån får man BCBA, men BCAB och BDAB är lika långa: en längsta gemensam delsekvens behöver inte vara unik.
Läsa tillbaka svaret
Börja i cellen längst ned till höger. Om bokstäverna för dess rad och kolumn matchar hör den bokstaven till svaret: anteckna den och gå snett upp till vänster. Annars går du till grannen, ovanför eller till vänster, med det största värdet, eftersom det är därifrån cellen fick sitt värde. Stanna vid första raden eller kolumnen. De antecknade bokstäverna i omvänd ordning är delsekvensen.
Historia och användning
Tabellmetoden upptäcktes oberoende av flera personer runt 1970, bland dem Robert Wagner och Michael Fischer, vars artikel från 1974 löste det närbesläktade redigeringsavståndet. 1975 visade Dan Hirschberg hur man hittar delsekvensen med mycket mindre minne, och 1976 byggde James Hunt och Douglas McIlroy programmet Unix diff på längsta gemensamma delsekvenser av rader. Biologer använder samma idé, med poäng, för att jämföra DNA- och proteinsekvenser.
Utforska själv
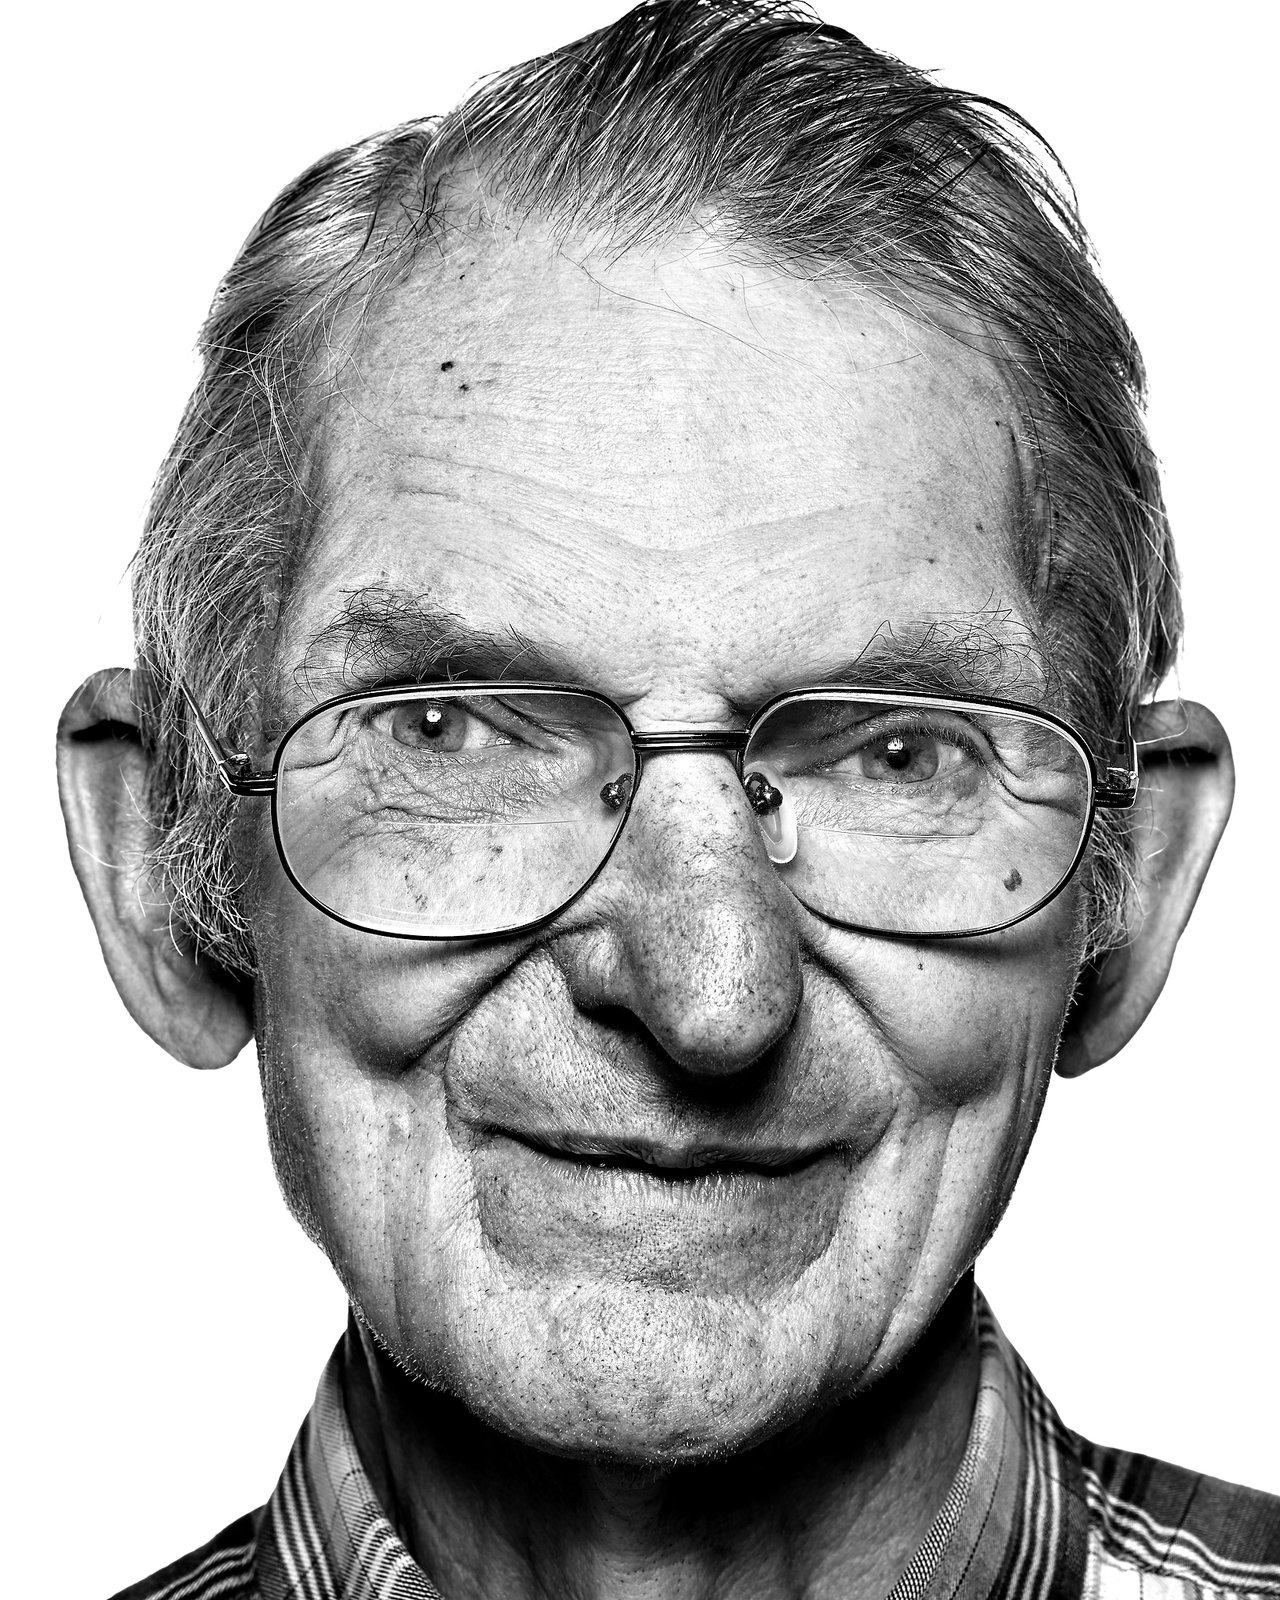
Öppna appen och tryck på Steg. De två bokstäverna som jämförs lyser upp i rubrikerna; en matchning läser den blå cellen snett upp till vänster, en skillnad läser de två blå cellerna ovanför och till vänster. När tabellen är full klättrar den orange stigen tillbaka från hörnet, och svarets bokstäver visas under tabellen.
Ofta ställda frågor
Hur mycket tid och minne behöver LCS-algoritmen?
O(m·n) tid för ord med längderna m och n. Den fullständiga tabellen behöver också O(m·n) minne för att läsa tillbaka svaret; Dan Hirschberg visade 1975 hur man hittar själva delsekvensen med bara O(min(m, n)) minne.
Hur använder diff den längsta gemensamma delsekvensen?
Det behandlar varje rad i en fil som en symbol och hittar en längsta gemensam delsekvens av de två filernas rader. Rader i den delsekvensen är oförändrade; den gamla filens övriga rader har tagits bort, och den nya filens övriga rader har lagts till.
Hur blir det med tre eller fler ord?
Tabellen får en dimension per ord, så tre ord med längden n kräver n³ celler. För ett godtyckligt antal ord är problemet NP-svårt.
Hur hänger LCS ihop med redigeringsavstånd?
Om bara tillägg och borttagningar är tillåtna är redigeringsavståndet mellan två ord deras sammanlagda längd minus två gånger längden på deras längsta gemensamma delsekvens. Tillåter man också utbyten får man Levenshteinavståndet, som räknas ut med en mycket liknande tabell.
Relaterade verktyg
Längsta gemensamma delsekvens (LCS)
Se steg för steg hur den längsta gemensamma delsekvensen av två ord hittas. Se varje cell jämföra två bokstäver och fyllas från sina grannar, och se de gemensamma bokstäverna spåras tillbaka från hörnet.
Redigeringsavstånd (Levenshteinavstånd)
Räkna ut redigeringsavståndet mellan två ord och se Levenshteintabellen fyllas i steg för steg. Se hur varje cell väljer mellan infoga, ta bort och ersätt, och läs ändringarna baklänges från hörnet.
Längsta växande delföljd (LIS)
Se steg för steg hur den längsta växande delföljden i en lista hittas. Se varje värde jämföras med dem före, längden på den bästa kedjan som slutar vid varje position och svaret läst baklänges.
Kappsäcksproblemet
Packa föremål i en ryggsäck efter kilo och dollar, hitta den mest värdefulla ryggsäcken och se dynamisk programmering lösa 0/1-kappsäcksproblemet steg för steg i en tabell.
Fibonacci med dynamisk programmering
Se Fibonaccital fylla en tabell, en addition i taget. Jämför bottom-up-tabulering med top-down-memoisering, se anropsstacken och räkna de anrop som vanlig rekursion skulle göra.
Redo att prova det?
Öppna PictorX i din webbläsare - ingen installation, inget kreditkort krävs för att starta.
Prova längsta gemensamma delsekvens