
Subsekuens bersama terpanjang (LCS)
Saat membandingkan dua versi sebuah file, baris-baris yang tidak berubah adalah subsekuens bersama dari keduanya. Menemukan yang terpanjang menunjukkan dengan tepat apa yang ditambahkan dan apa yang dihapus. Gagasan yang sama dipakai untuk menjajarkan untai DNA dan menyarankan perbaikan ejaan, dan masalah ini diselesaikan dengan salah satu tabel paling elegan dalam ilmu komputer.
Masalahnya
Subsekuens dari sebuah kata mempertahankan sebagian hurufnya dalam urutan aslinya: ACE adalah subsekuens dari ABCDE, tetapi EA bukan. Subsekuens bersama dari dua kata adalah subsekuens dari keduanya, dan masalahnya adalah mencari yang terpanjang. Kata sepanjang n punya 2ⁿ subsekuens, jadi mencoba semuanya sia-sia begitu hurufnya lebih dari beberapa.
Tabelnya
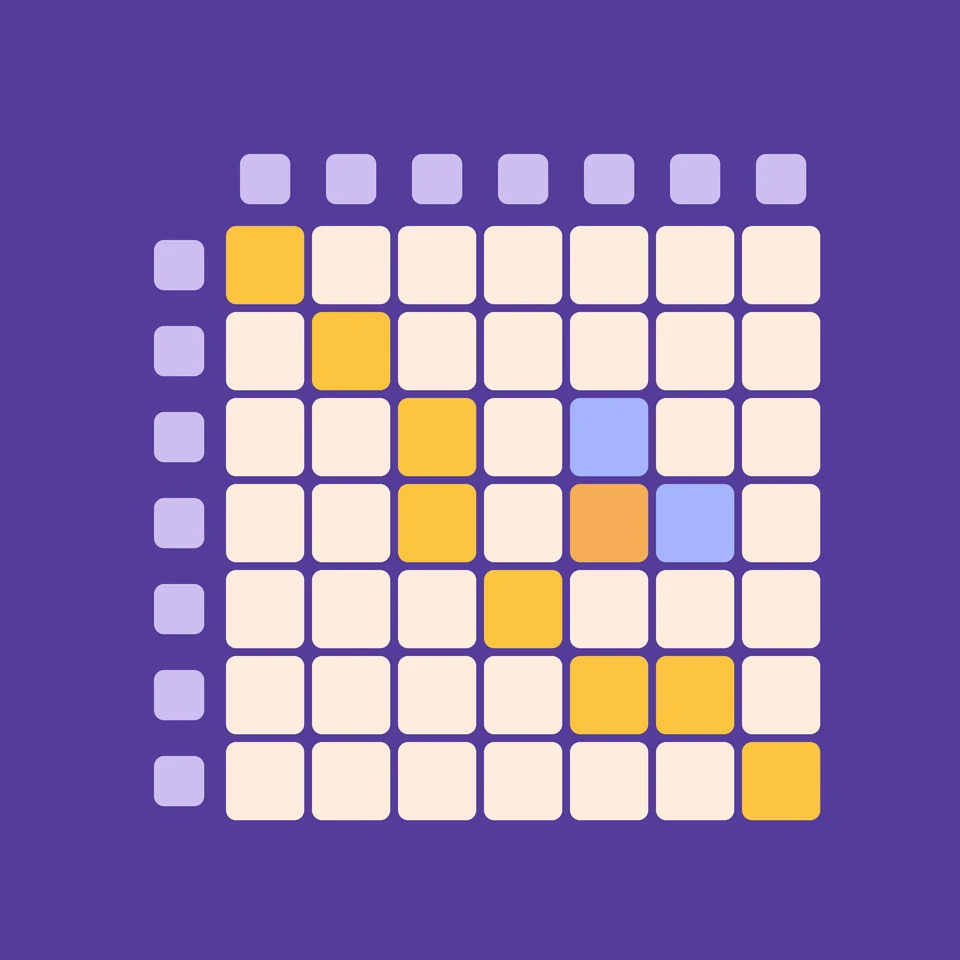
Misalkan len[i][j] adalah panjang subsekuens bersama terpanjang dari i huruf pertama satu kata dan j huruf pertama kata lainnya. Kata kosong tidak punya kesamaan apa pun, jadi baris dan kolom pertama bernilai 0. Jika huruf ke-i sama dengan huruf ke-j, len[i][j] = len[i − 1][j − 1] + 1: kecocokan itu memperpanjang apa pun yang ada sebelumnya. Jika tidak, len[i][j] adalah yang lebih besar antara len[i − 1][j] dan len[i][j − 1]: buang salah satu dari dua huruf dan simpan hasil yang lebih baik.
Sebuah contoh
Bandingkan ABCBDAB dengan BDCABA. Huruf pertama kata kedua, B, cocok dengan B di baris 2; C di kolom ketiga cocok dengan baris 3, dan seterusnya, setiap kecocokan menambahkan satu pada sel di kiri atas. Sel kanan bawah berakhir di 4. Membaca balik dari sana menghasilkan BCBA, tetapi BCAB dan BDAB sama panjangnya: subsekuens bersama terpanjang tidak harus tunggal.
Membaca balik jawabannya
Mulai dari sel kanan bawah. Jika huruf baris dan kolomnya cocok, huruf itu termasuk dalam jawaban: catat, lalu melangkah diagonal ke kiri atas. Jika tidak, melangkah ke tetangga di atas atau di kiri yang nilainya lebih besar, karena dari sanalah sel itu mendapat nilainya. Berhenti di baris atau kolom pertama. Huruf-huruf yang dicatat, dibalik urutannya, adalah subsekuensnya.
Sejarah dan kegunaan
Metode tabel ini ditemukan secara terpisah oleh beberapa orang sekitar tahun 1970, di antaranya Robert Wagner dan Michael Fischer, yang makalahnya pada 1974 memecahkan masalah jarak edit yang berkaitan erat. Pada 1975 Dan Hirschberg menunjukkan cara menemukan subsekuens dengan memori yang jauh lebih sedikit, dan pada 1976 James Hunt dan Douglas McIlroy membangun program Unix diff berdasarkan subsekuens bersama terpanjang dari baris-baris. Ahli biologi memakai gagasan yang sama, dengan skor, untuk menjajarkan sekuens DNA dan protein.
Jelajahi sendiri
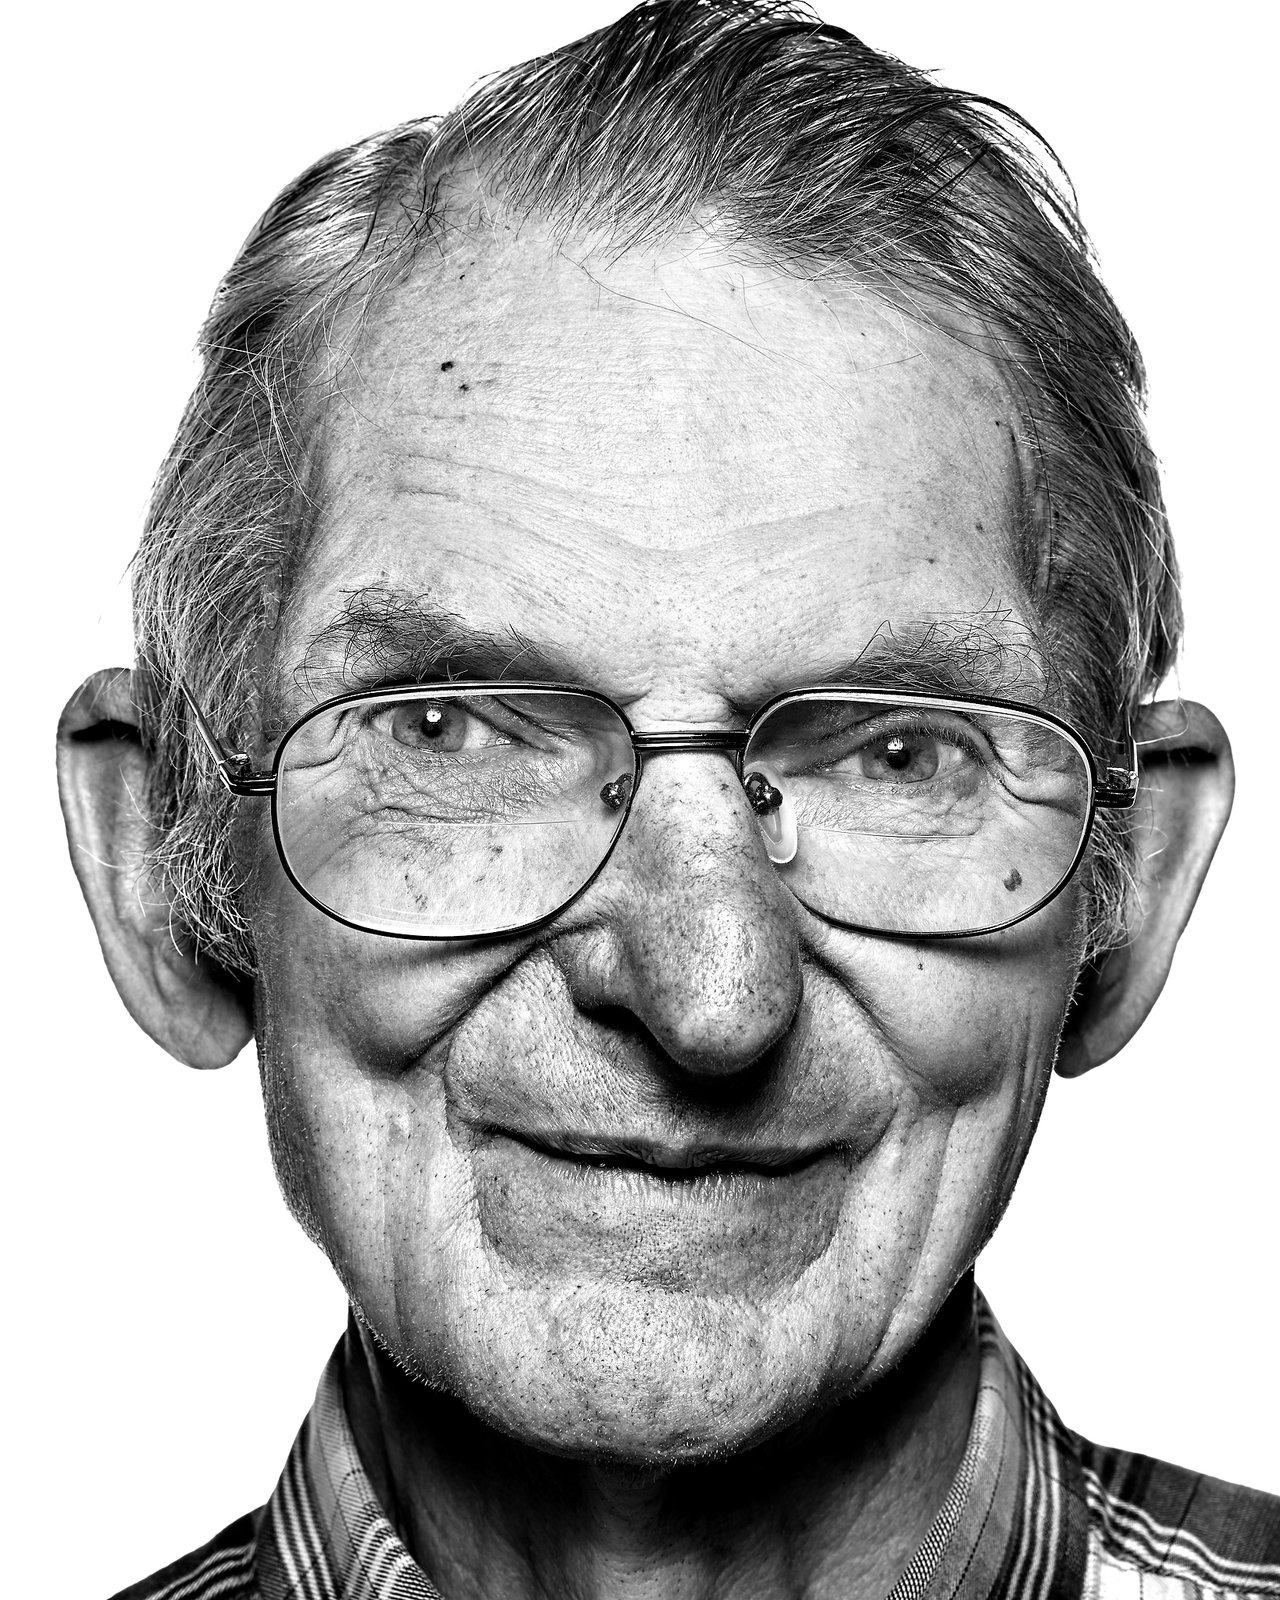
Buka aplikasinya dan tekan Langkah. Dua huruf yang sedang dibandingkan menyala di judul baris dan kolom; kecocokan membaca sel biru di kiri atas, ketidakcocokan membaca dua sel biru di atas dan di kiri. Saat tabel penuh, jalur oranye naik balik dari sudut dan huruf-huruf jawabannya muncul di bawah tabel.
Pertanyaan yang sering diajukan
Berapa banyak waktu dan memori yang dibutuhkan algoritma LCS?
Waktu O(m·n) untuk kata sepanjang m dan n. Tabel lengkap juga butuh memori O(m·n) untuk membaca balik jawabannya; pada 1975 Dan Hirschberg menunjukkan cara menemukan subsekuensnya sendiri hanya dengan memori O(min(m, n)).
Bagaimana diff menggunakan subsekuens bersama terpanjang?
Diff memperlakukan setiap baris file sebagai satu simbol dan mencari subsekuens bersama terpanjang dari baris-baris kedua file. Baris dalam subsekuens itu tidak berubah; baris lain di file lama telah dihapus, dan baris lain di file baru telah ditambahkan.
Bagaimana dengan tiga kata atau lebih?
Tabel mendapat satu dimensi per kata, jadi tiga kata sepanjang n butuh n³ sel. Untuk jumlah kata sembarang, masalah ini NP-hard.
Apa hubungan LCS dengan jarak edit?
Jika hanya penyisipan dan penghapusan yang diizinkan, jarak edit dua kata sama dengan total panjang keduanya dikurangi dua kali panjang subsekuens bersama terpanjangnya. Jika penggantian juga diizinkan, hasilnya adalah jarak Levenshtein, yang dihitung dengan tabel yang sangat mirip.
Alat terkait
Subsekuens bersama terpanjang (LCS)
Lihat langkah demi langkah bagaimana subsekuens bersama terpanjang dari dua kata ditemukan. Lihat setiap sel membandingkan dua huruf dan terisi dari sel tetangganya, lalu huruf-huruf yang sama ditelusuri balik dari sudut.
Jarak edit (jarak Levenshtein)
Cari jarak edit antara dua kata dan lihat tabel Levenshtein terisi langkah demi langkah. Lihat setiap sel memilih antara sisip, hapus, dan ganti, lalu baca balik edit-editnya dari sudut.
Subbarisan naik terpanjang (LIS)
Lihat subbarisan naik terpanjang dari sebuah daftar ditemukan langkah demi langkah. Lihat tiap nilai dibandingkan dengan nilai-nilai sebelumnya, panjang deret terbaik yang berakhir di tiap posisi, dan jawaban yang dibaca mundur.
Masalah knapsack
Masukkan barang ke dalam tas punggung berdasarkan kilogram dan dolar, temukan isi tas yang paling berharga, dan lihat pemrograman dinamis menyelesaikan masalah knapsack 0/1 langkah demi langkah dalam tabel.
Fibonacci dengan pemrograman dinamis
Lihat bilangan Fibonacci mengisi tabel satu penjumlahan demi satu penjumlahan. Bandingkan tabulasi bawah ke atas dengan memoisasi atas ke bawah, lihat tumpukan panggilan (call stack), dan hitung berapa panggilan yang dibuat rekursi biasa.
Siap mencobanya?
Buka PictorX di browser Anda — tanpa instalasi, tanpa kartu kredit untuk memulai.
Coba subsekuens bersama terpanjang