
最長共通部分列(LCS)
ファイルの2つの版を比べるとき、変わっていない行は両方に共通する部分列です。その最長のものを見つければ、何が追加され何が削除されたかが正確にわかります。同じ考え方で DNA 鎖を並べてそろえたり、スペルの修正候補を出したりでき、しかもそれはコンピューターサイエンスで最も美しい表の1つで解けます。
問題
単語の部分列は、その文字のいくつかを元の順番のまま残したものです。ACE は ABCDE の部分列ですが、EA はそうではありません。2つの単語の共通部分列とは両方の部分列になっているもので、問題はその最長のものを見つけることです。長さ n の単語には 2ⁿ 個の部分列があるので、数文字を超えるとすべて試すのは絶望的です。
表
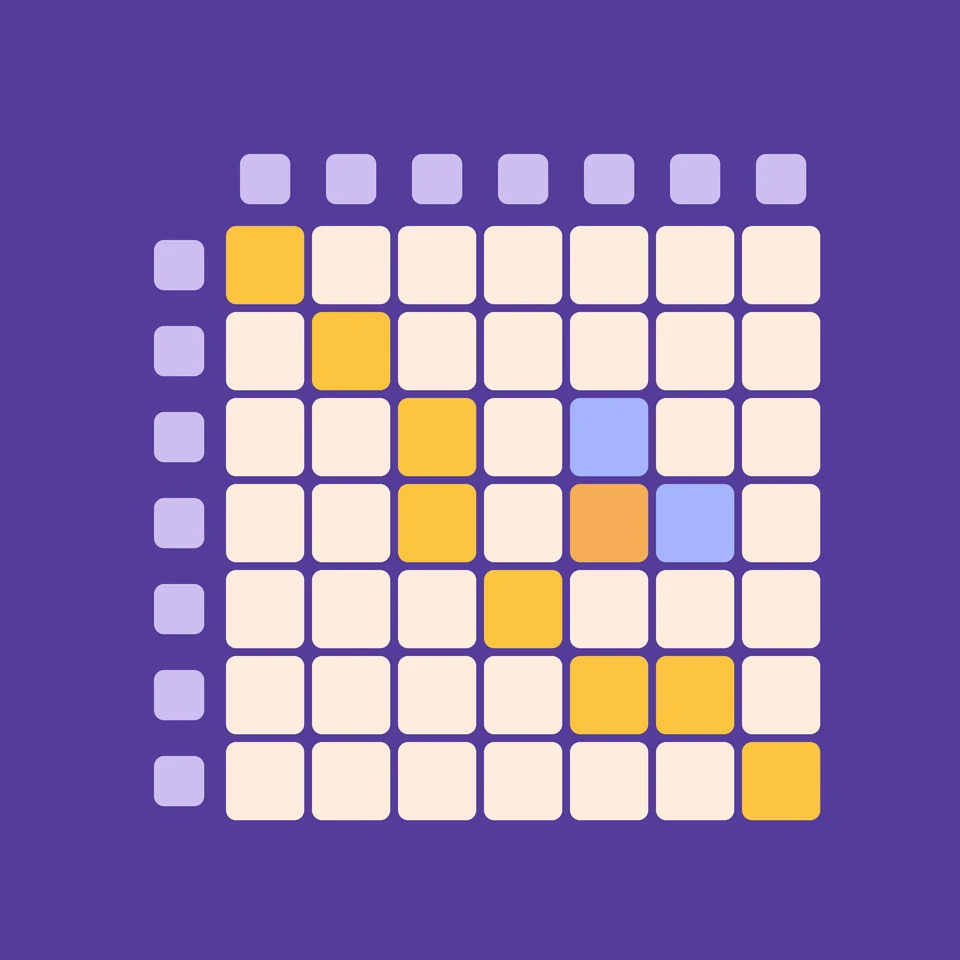
len[i][j] を、一方の単語の最初の i 文字ともう一方の単語の最初の j 文字の最長共通部分列の長さとします。空の単語は何も共通しないので、最初の行と列は 0 です。i 番目の文字と j 番目の文字が等しければ、len[i][j] = len[i − 1][j − 1] + 1 です。その一致が、それまでの結果を延ばします。等しくなければ、len[i][j] は len[i − 1][j] と len[i][j − 1] の大きいほうです。2つの文字のどちらかを捨てて、よいほうの結果を残します。
例
ABCBDAB と BDCABA を比べます。2つ目の単語の最初の文字 B は 2 行目の B と一致し、3 列目の C は 3 行目と一致し、というように続きます。一致するたびに左上のマスに1を足します。右下のマスは最終的に 4 になります。そこから逆にたどると BCBA が得られますが、BCAB と BDAB も同じ長さです。最長共通部分列は1つとは限りません。
答えを逆にたどる
右下のマスから始めます。その行と列の文字が一致すれば、その文字は答えに含まれます。書き留めて、斜め左上へ1つ進みます。一致しなければ、上か左の隣のマスのうち値の大きいほうへ進みます。マスの値はそこから来たからです。最初の行か列に着いたら止まります。書き留めた文字を逆順に並べると部分列になります。
歴史と応用
表を使うこの方法は、1970 年ごろに何人かがそれぞれ独立に見つけました。その中には、1974 年の論文で密接に関連する編集距離の問題を解いたロバート・ワグナーとマイケル・フィッシャーもいます。1975 年にはダン・ハーシュバーグが、はるかに少ないメモリで部分列を見つける方法を示し、1976 年にはジェームズ・ハントとダグラス・マキルロイが、行の最長共通部分列をもとに Unix diff プログラムを作りました。生物学者は同じ考え方にスコアを加えて、DNA やタンパク質の配列をアラインメントしています。
試してみよう
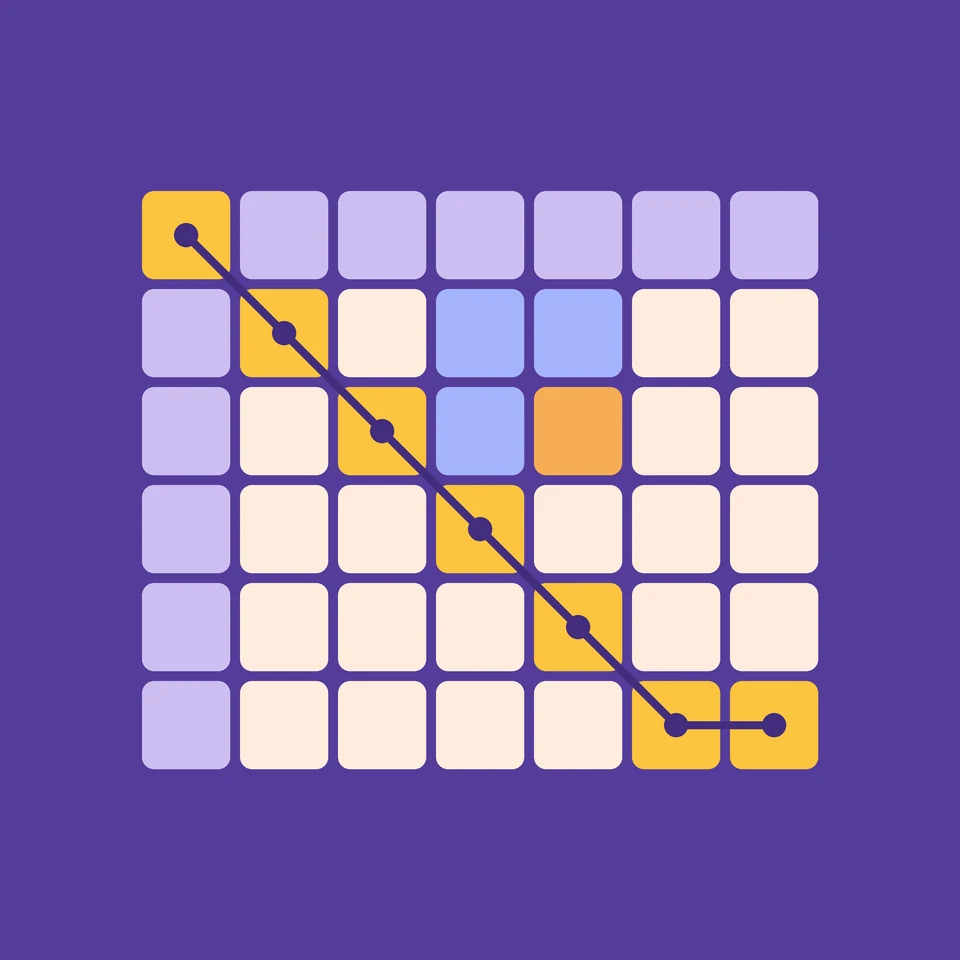
アプリを開いて「ステップ」を押してください。比べている2つの文字が見出しで光ります。一致すれば左上の青いマスを、一致しなければ上と左の2つの青いマスを読みます。表が埋まると、オレンジの経路が角から逆に上っていき、答えの文字が表の下に表示されます。
よくある質問
LCS のアルゴリズムにはどれくらいの時間とメモリが必要ですか?
長さ m と n の単語なら、時間は O(m·n) です。答えを逆にたどるには表全体が必要なので、メモリも O(m·n) かかります。ダン・ハーシュバーグは 1975 年に、部分列そのものを O(min(m, n)) のメモリだけで見つける方法を示しました。
diff は最長共通部分列をどう使っていますか?
ファイルの各行を1つの記号として扱い、2つのファイルの行の最長共通部分列を見つけます。その部分列に含まれる行は変わっていません。古いファイルのそれ以外の行は削除され、新しいファイルのそれ以外の行は追加されたものです。
単語が3つ以上の場合は?
表の次元が単語ごとに1つ増えるので、長さ n の単語3つには n³ 個のマスが必要です。単語の数が任意の場合、この問題は NP 困難です。
LCS と編集距離はどう関係していますか?
挿入と削除だけが許される場合、2つの単語の編集距離は、2つの長さの合計から最長共通部分列の長さの2倍を引いたものです。置き換えも許すとレーベンシュタイン距離になり、とてもよく似た表で計算されます。
関連ツール
最長共通部分列(LCS)
2つの単語の最長共通部分列が見つかる様子を1ステップずつ見られます。各マスが2つの文字を比べて隣のマスから値を埋め、共通の文字を角から逆にたどる様子がわかります。
編集距離(レーベンシュタイン距離)
2つの単語の編集距離を求め、レーベンシュタインの表が1ステップずつ埋まる様子を見られます。各マスが挿入・削除・置換のどれを選ぶかを確かめ、角から編集をさかのぼって読み取れます。
最長増加部分列(LIS)
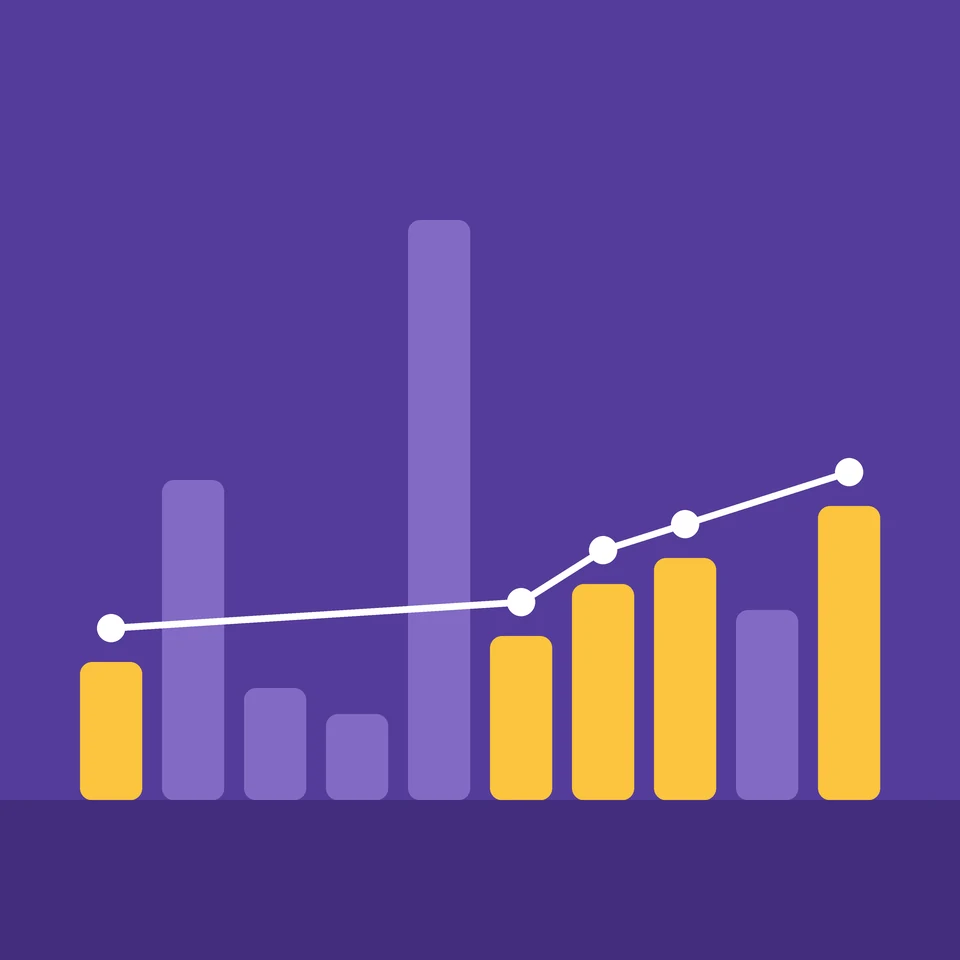
リストの最長増加部分列が見つかる様子をステップごとに見てみましょう。各値とそれより前の値との比較、各位置で終わる最良の並びの長さ、さかのぼって読み取る答えがわかります。
ナップサック問題
キログラムとドルを見ながら品物をナップサックに詰め、最も価値の高い詰め方を見つけ、動的計画法が表の上で0/1ナップサック問題を一歩ずつ解く様子を見てみましょう。
動的計画法でフィボナッチ数
フィボナッチ数が足し算1回ずつ表を埋めていく様子を見てみましょう。ボトムアップの表計算とトップダウンのメモ化を比べ、コールスタックを確認し、単純な再帰なら何回呼び出すかを数えます。
試してみますか?
ブラウザで PictorX を開きます。インストール不要、始めるのにクレジットカードも不要です。
最長共通部分列を試す