
Længste fælles delsekvens (LCS)
Når du sammenligner to versioner af en fil, er de linjer, der ikke er ændret, en fælles delsekvens af begge. Finder du den længste, ved du præcis, hvad der er tilføjet, og hvad der er fjernet. Samme idé bruges til at stille DNA-strenge op mod hinanden og til at foreslå staverettelser, og den løses med en af de mest elegante tabeller i datalogien.
Problemet
En delsekvens af et ord beholder nogle af dets bogstaver i deres oprindelige rækkefølge: ACE er en delsekvens af ABCDE, men EA er ikke. En fælles delsekvens af to ord er en delsekvens af begge, og opgaven er at finde den længste. Et ord med længde n har 2ⁿ delsekvenser, så det er håbløst at prøve dem alle, så snart der er mere end nogle få bogstaver.
Tabellen
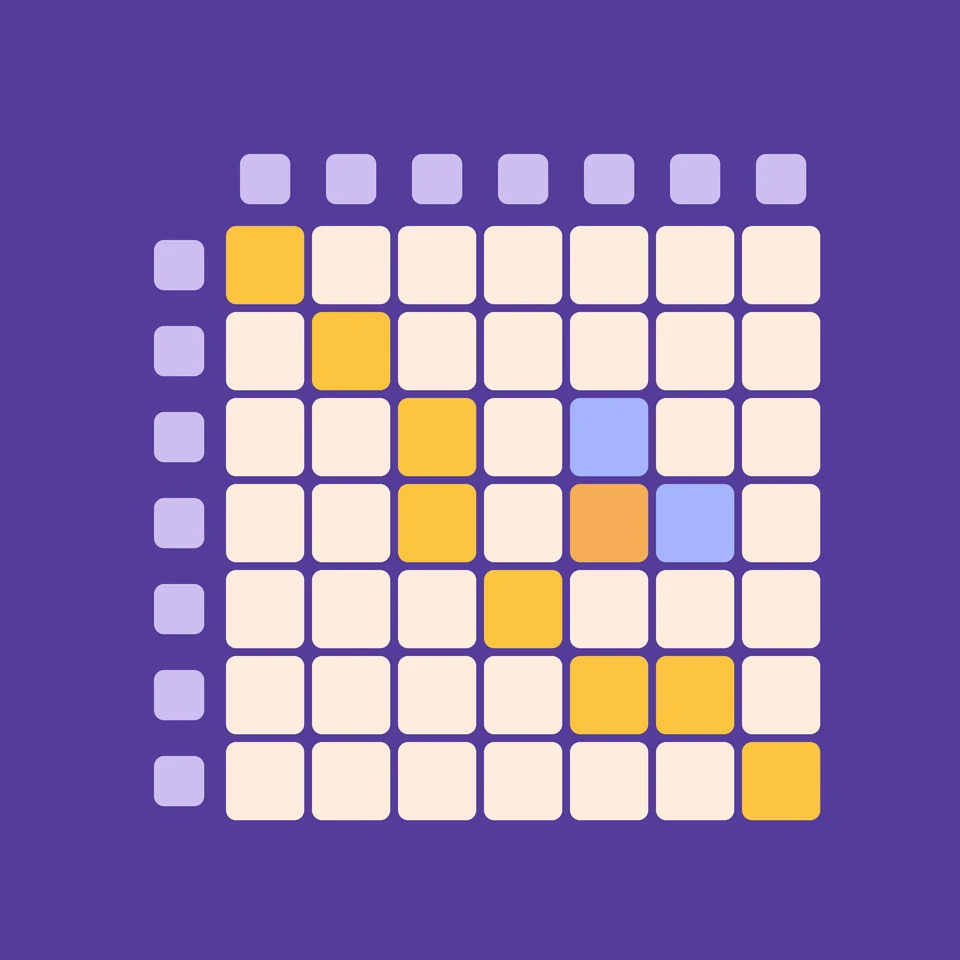
Lad len[i][j] være længden af den længste fælles delsekvens af de første i bogstaver i det ene ord og de første j bogstaver i det andet. Et tomt ord har intet til fælles med noget, så første række og kolonne er 0. Hvis bogstav i er lig med bogstav j, er len[i][j] = len[i − 1][j − 1] + 1: matchet forlænger det, der kom før. Ellers er len[i][j] den største af len[i − 1][j] og len[i][j − 1]: drop det ene af de to bogstaver, og behold det bedste resultat.
Et eksempel
Sammenlign ABCBDAB med BDCABA. Det første bogstav i det andet ord, B, matcher B'et i række 2; C'et i tredje kolonne matcher række 3, og så videre, og hvert match lægger én til cellen skråt op til venstre. Cellen nederst til højre ender på 4. Læser man tilbage derfra, får man BCBA, men BCAB og BDAB er lige så lange: en længste fælles delsekvens behøver ikke være entydig.
Læs svaret tilbage
Begynd i cellen nederst til højre. Hvis bogstaverne i dens række og kolonne er ens, hører det bogstav til svaret: skriv det ned, og gå skråt op til venstre. Ellers går du til naboen, ovenover eller til venstre, med den største værdi, for det er derfra, cellen har sin værdi. Stop ved første række eller kolonne. De noterede bogstaver i omvendt rækkefølge er delsekvensen.
Historie og anvendelser
Tabelmetoden blev fundet uafhængigt af flere personer omkring 1970, blandt dem Robert Wagner og Michael Fischer, hvis artikel fra 1974 løste den nært beslægtede redigeringsafstand. I 1975 viste Dan Hirschberg, hvordan man finder delsekvensen med langt mindre hukommelse, og i 1976 byggede James Hunt og Douglas McIlroy programmet Unix diff på længste fælles delsekvenser af linjer. Biologer bruger samme idé, med point, til at sammenstille DNA- og proteinsekvenser.
Udforsk det
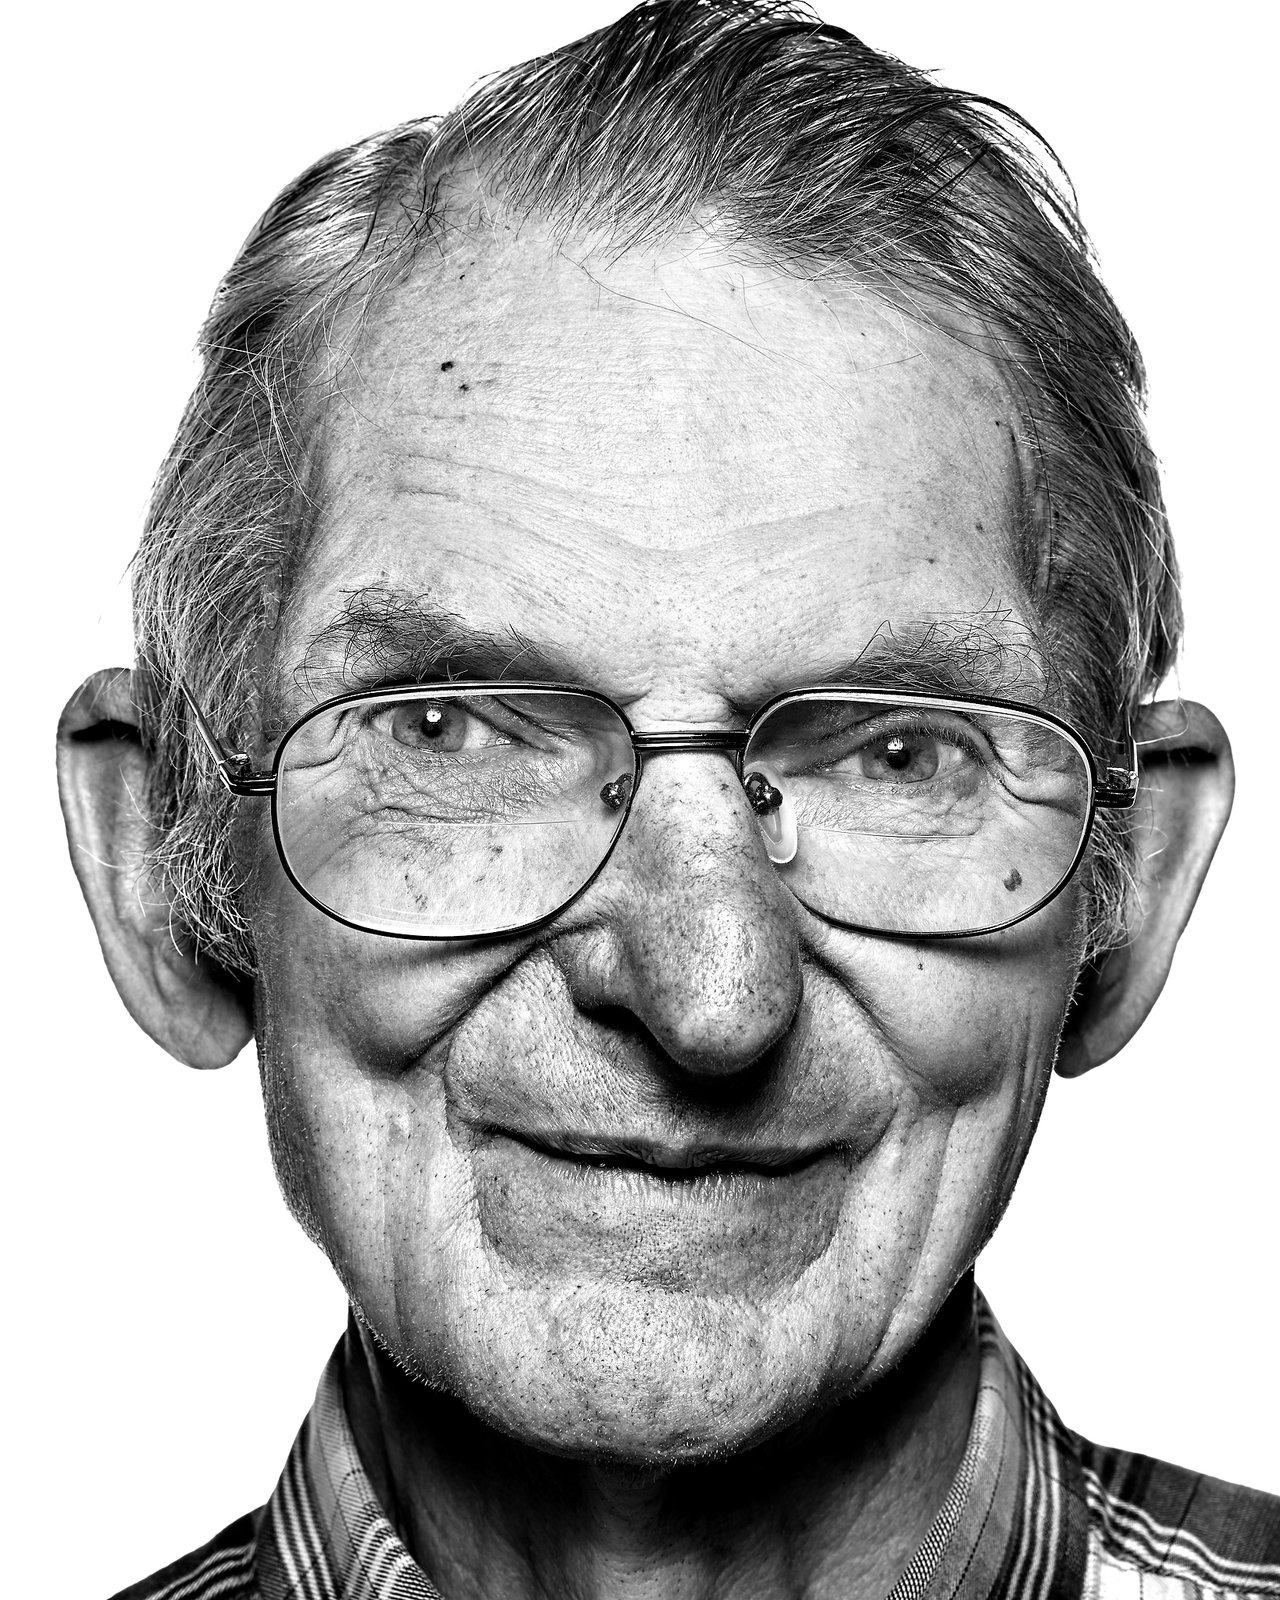
Åbn appen, og tryk på Trin. De to bogstaver, der sammenlignes, lyser op i overskrifterne; et match læser den blå celle skråt op til venstre, en forskel læser de to blå celler ovenover og til venstre. Når tabellen er fuld, klatrer den orange sti tilbage fra hjørnet, og svarets bogstaver vises under tabellen.
Ofte stillede spørgsmål
Hvor meget tid og hukommelse kræver LCS-algoritmen?
O(m·n) tid for ord med længderne m og n. Den fulde tabel kræver også O(m·n) hukommelse for at læse svaret tilbage; Dan Hirschberg viste i 1975, hvordan man finder selve delsekvensen med kun O(min(m, n)) hukommelse.
Hvordan bruger diff den længste fælles delsekvens?
Det behandler hver linje i en fil som ét symbol og finder en længste fælles delsekvens af de to filers linjer. Linjer i den delsekvens er uændrede; de øvrige linjer i den gamle fil er slettet, og de øvrige linjer i den nye fil er tilføjet.
Hvad med tre eller flere ord?
Tabellen får én dimension pr. ord, så tre ord med længde n kræver n³ celler. For et vilkårligt antal ord er problemet NP-svært.
Hvordan hænger LCS sammen med redigeringsafstand?
Hvis kun indsættelser og sletninger er tilladt, er redigeringsafstanden mellem to ord deres samlede længde minus to gange længden af deres længste fælles delsekvens. Tillader man også udskiftninger, får man Levenshtein-afstanden, som beregnes med en meget lignende tabel.
Relaterede værktøjer
Længste fælles delsekvens (LCS)
Se trin for trin, hvordan den længste fælles delsekvens af to ord findes. Se hver celle sammenligne to bogstaver og blive udfyldt ud fra sine naboer, og se de fælles bogstaver blive fulgt tilbage fra hjørnet.
Redigeringsafstand (Levenshtein-afstand)
Find redigeringsafstanden mellem to ord, og se Levenshtein-tabellen blive udfyldt trin for trin. Se hver celle vælge mellem indsæt, slet og erstat, og læs ændringerne baglæns fra hjørnet.
Længste voksende delfølge (LIS)
Se trin for trin, hvordan den længste voksende delfølge i en liste bliver fundet. Se hver værdi sammenlignet med dem før den, længden af den bedste kæde, der slutter ved hver position, og svaret læst baglæns.
Rygsækproblemet
Pak genstande i en rygsæk efter kilo og dollars, find den mest værdifulde rygsæk, og se dynamisk programmering løse 0/1-rygsækproblemet trin for trin i en tabel.
Fibonacci med dynamisk programmering
Se Fibonacci-tal fylde en tabel, én addition ad gangen. Sammenlign bottom-up-tabulering med top-down-memoisering, se kaldstakken, og tæl de kald, almindelig rekursion ville lave.
Er du klar til at prøve?
Åbn PictorX i din browser – ingen installation og intet kreditkort for at komme i gang.
Prøv den længste fælles delsekvens