
Plus longue sous-séquence commune (LCS)
Quand vous comparez deux versions d'un fichier, les lignes qui n'ont pas changé forment une sous-séquence commune aux deux. Trouver la plus longue vous dit exactement ce qui a été ajouté et ce qui a été supprimé. La même idée sert à aligner des brins d'ADN et à suggérer des corrections orthographiques, et elle se résout avec l'un des tableaux les plus élégants de l'informatique.
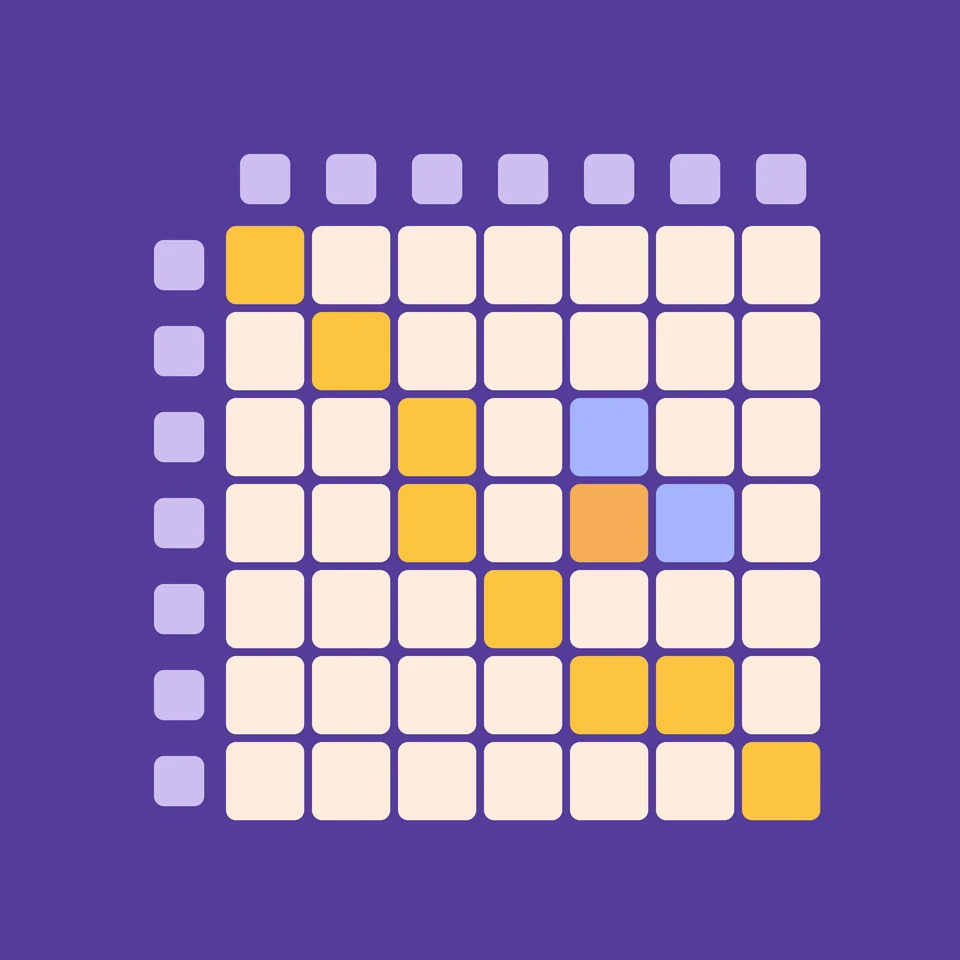
Le problème
Une sous-séquence d'un mot garde certaines de ses lettres dans leur ordre d'origine : ACE est une sous-séquence de ABCDE, mais EA n'en est pas une. Une sous-séquence commune de deux mots est une sous-séquence des deux, et le problème consiste à trouver la plus longue. Un mot de longueur n a 2ⁿ sous-séquences : les essayer toutes est sans espoir au-delà de quelques lettres.
Le tableau
Soit len[i][j] la longueur de la plus longue sous-séquence commune des i premières lettres d'un mot et des j premières lettres de l'autre. Un mot vide n'a rien en commun avec quoi que ce soit, donc la première ligne et la première colonne valent 0. Si la lettre i est égale à la lettre j, len[i][j] = len[i − 1][j − 1] + 1 : la correspondance prolonge ce qui la précède. Sinon, len[i][j] est la plus grande des valeurs len[i − 1][j] et len[i][j − 1] : on écarte l'une des deux lettres et on garde le meilleur résultat.
Un exemple
Comparez ABCBDAB et BDCABA. La première lettre du second mot, B, correspond au B de la ligne 2 ; le C de la troisième colonne correspond à la ligne 3, et ainsi de suite, chaque correspondance ajoutant un à la case en haut à gauche. La case en bas à droite finit à 4. La relecture à partir de là donne BCBA, mais BCAB et BDAB sont tout aussi longues : une plus longue sous-séquence commune n'est pas forcément unique.
Relire la réponse
Commencez par la case en bas à droite. Si les lettres de sa ligne et de sa colonne sont identiques, cette lettre fait partie de la réponse : notez-la et montez en diagonale vers la gauche. Sinon, passez à la voisine, au-dessus ou à gauche, qui a la plus grande valeur, car c'est de là que la case tient sa valeur. Arrêtez-vous à la première ligne ou colonne. Les lettres notées, dans l'ordre inverse, forment la sous-séquence.
Histoire et applications
La méthode du tableau a été découverte indépendamment par plusieurs personnes vers 1970, parmi lesquelles Robert Wagner et Michael Fischer, dont l'article de 1974 résolvait le problème très proche de la distance d'édition. En 1975, Dan Hirschberg a montré comment trouver la sous-séquence avec beaucoup moins de mémoire, et en 1976 James Hunt et Douglas McIlroy ont fondé le programme Unix diff sur les plus longues sous-séquences communes de lignes. Les biologistes utilisent la même idée, avec des scores, pour aligner des séquences d'ADN et de protéines.
À vous de jouer
Ouvrez l'application et appuyez sur Étape. Les deux lettres comparées s'allument dans les en-têtes ; une correspondance lit la case bleue en haut à gauche, une différence lit les deux cases bleues au-dessus et à gauche. Quand le tableau est plein, le chemin orange remonte depuis le coin et les lettres de la réponse apparaissent sous le tableau.
Questions fréquemment posées
De combien de temps et de mémoire l'algorithme LCS a-t-il besoin ?
Un temps en O(m·n) pour des mots de longueurs m et n. Le tableau complet demande aussi O(m·n) de mémoire pour relire la réponse ; Dan Hirschberg a montré en 1975 comment trouver la sous-séquence elle-même avec seulement O(min(m, n)) de mémoire.
Comment diff utilise-t-il la plus longue sous-séquence commune ?
Il traite chaque ligne d'un fichier comme un seul symbole et trouve une plus longue sous-séquence commune des lignes des deux fichiers. Les lignes de cette sous-séquence sont inchangées ; les autres lignes de l'ancien fichier ont été supprimées, et les autres lignes du nouveau fichier ont été ajoutées.
Et pour trois mots ou plus ?
Le tableau gagne une dimension par mot : trois mots de longueur n demandent donc n³ cases. Pour un nombre quelconque de mots, le problème est NP-difficile.
Quel est le lien entre la LCS et la distance d'édition ?
Si seules les insertions et les suppressions sont permises, la distance d'édition de deux mots est leur longueur totale moins deux fois la longueur de leur plus longue sous-séquence commune. Si l'on permet aussi les remplacements, on obtient la distance de Levenshtein, calculée par un tableau très semblable.
Outils associés
Plus longue sous-séquence commune (LCS)
Regardez pas à pas comment on trouve la plus longue sous-séquence commune de deux mots. Voyez chaque case comparer deux lettres et se remplir à partir de ses voisines, puis les lettres communes être retrouvées depuis le coin.
Distance d'édition (distance de Levenshtein)
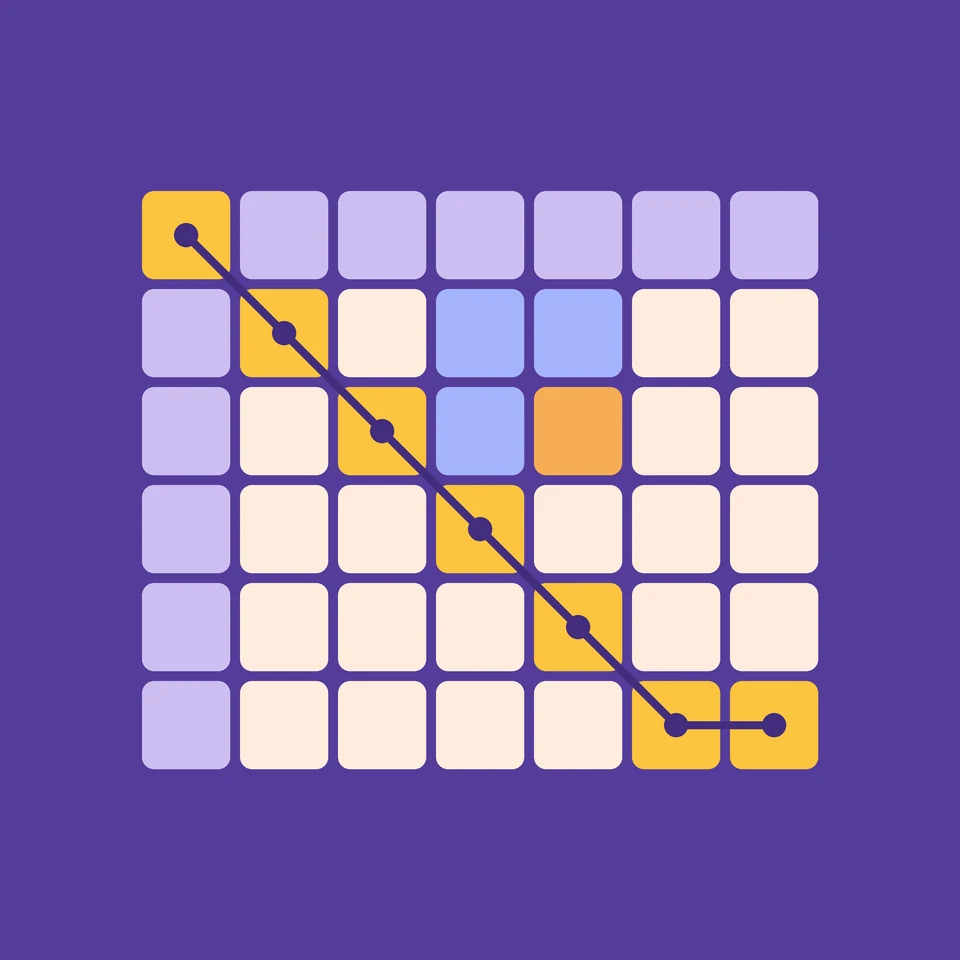
Trouvez la distance d'édition entre deux mots et regardez le tableau de Levenshtein se remplir pas à pas. Voyez chaque case choisir entre insertion, suppression et remplacement, et relisez les modifications depuis le coin.
Plus longue sous-suite croissante (LIS)
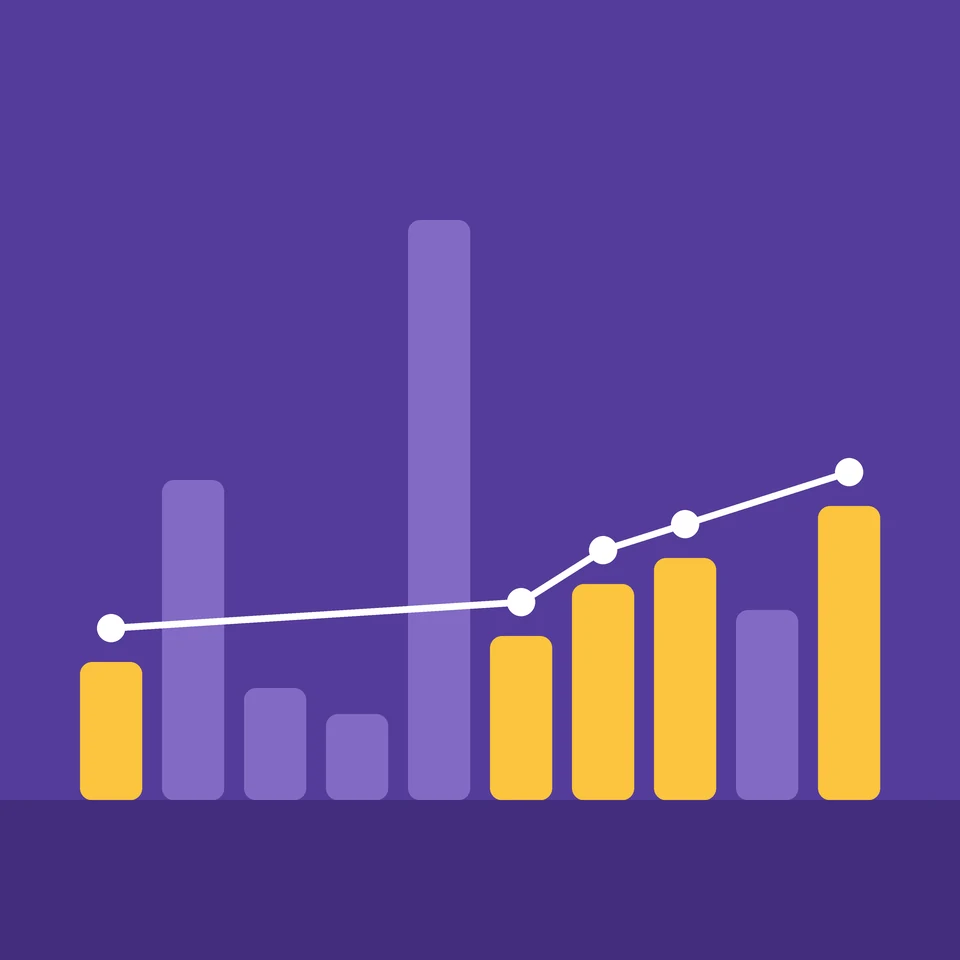
Regardez la plus longue sous-suite croissante d'une liste se construire pas à pas. Voyez chaque valeur comparée aux précédentes, la longueur de la meilleure chaîne qui se termine à chaque position, et la réponse relue.
Problème du sac à dos
Mettez des objets dans un sac à dos selon leurs kilos et leurs dollars, trouvez le sac le plus précieux et regardez la programmation dynamique résoudre le problème du sac à dos 0/1 pas à pas dans un tableau.
Fibonacci par programmation dynamique
Regardez les nombres de Fibonacci remplir un tableau, une addition à la fois. Comparez la tabulation ascendante et la mémoïsation descendante, observez la pile d'appels et comptez les appels que ferait la récursion simple.
Prêt à l'essayer ?
Ouvrez PictorX dans votre navigateur – aucune installation, aucune carte de crédit requise pour démarrer.
Essayer la plus longue sous-séquence commune