
Subsequência comum mais longa (LCS)
Quando compara duas versões de um ficheiro, as linhas que não mudaram são uma subsequência comum de ambas. Encontrar a mais longa diz-lhe exatamente o que foi acrescentado e o que foi removido. A mesma ideia alinha cadeias de ADN e sugere correções ortográficas, e resolve-se com uma das tabelas mais elegantes da informática.
O problema
Uma subsequência de uma palavra mantém algumas das suas letras pela ordem original: ACE é uma subsequência de ABCDE, mas EA não é. Uma subsequência comum de duas palavras é uma subsequência de ambas, e o problema é encontrar a mais longa. Uma palavra de comprimento n tem 2ⁿ subsequências, por isso experimentá-las todas é impossível quando há mais do que umas poucas letras.
A tabela
Seja len[i][j] o comprimento da subsequência comum mais longa das primeiras i letras de uma palavra e das primeiras j letras da outra. Uma palavra vazia não partilha nada, por isso a primeira linha e a primeira coluna valem 0. Se a letra i for igual à letra j, len[i][j] = len[i − 1][j − 1] + 1: a coincidência prolonga o que vinha antes. Caso contrário, len[i][j] é o maior entre len[i − 1][j] e len[i][j − 1]: descarta-se uma das duas letras e fica-se com o melhor resultado.
Um exemplo
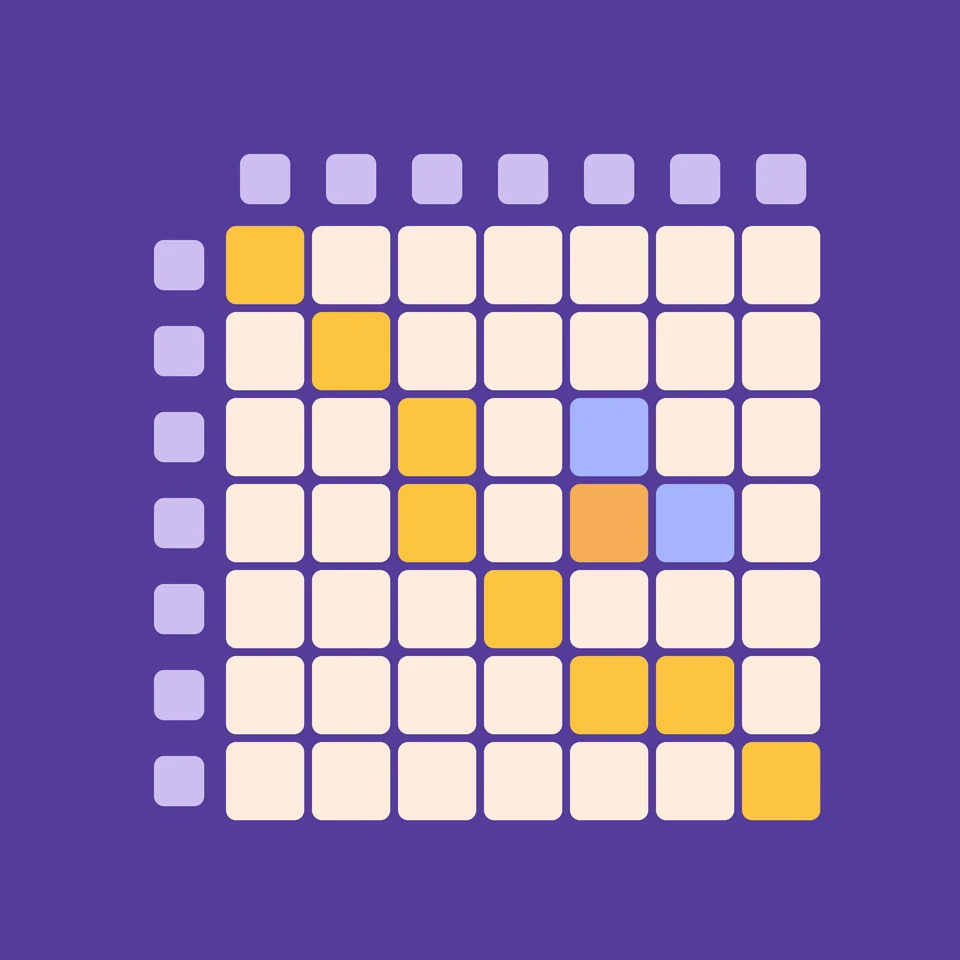
Compare ABCBDAB com BDCABA. A primeira letra da segunda palavra, B, coincide com o B da linha 2; o C da terceira coluna coincide com a linha 3, e assim por diante, e cada coincidência soma um à célula acima à esquerda. A célula do canto inferior direito acaba em 4. Ler de volta a partir daí dá BCBA, mas BCAB e BDAB são igualmente longas: uma subsequência comum mais longa não tem de ser única.
Ler a resposta de volta
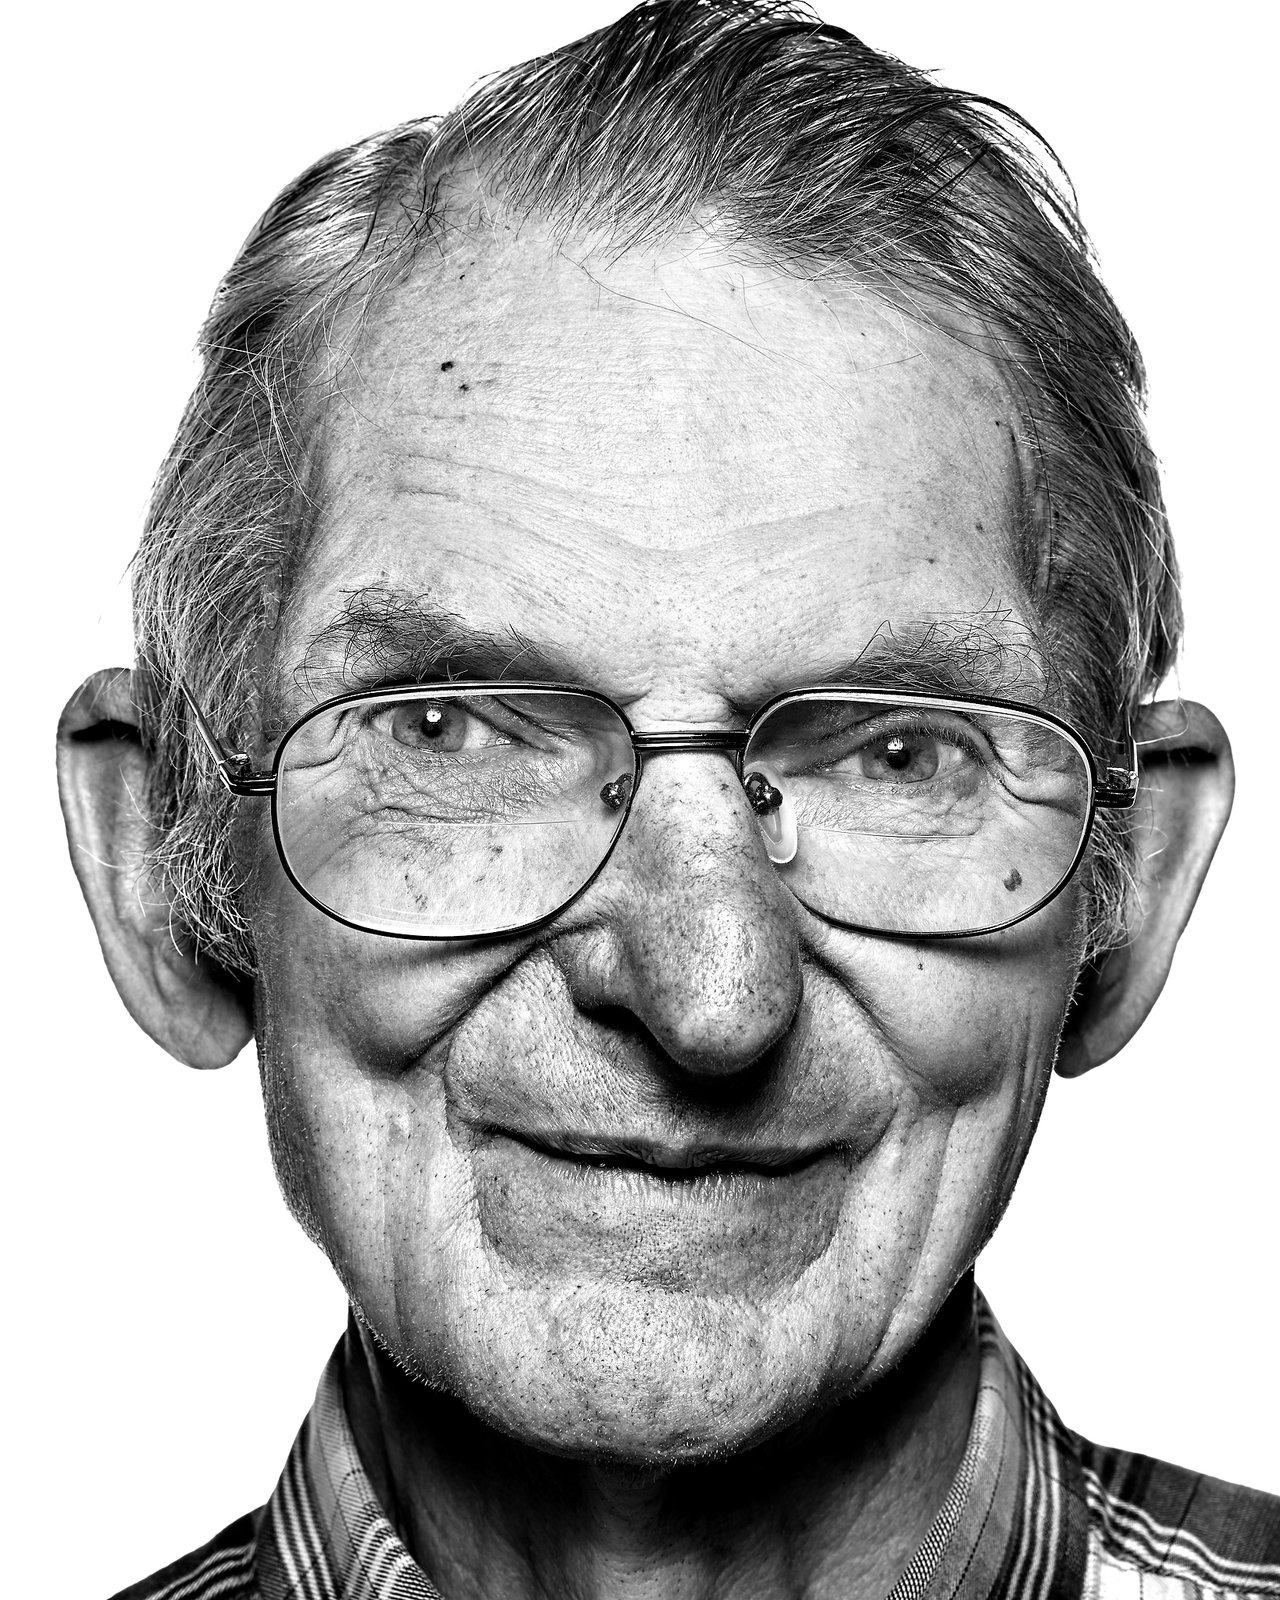
Comece na célula do canto inferior direito. Se as letras da sua linha e da sua coluna coincidirem, essa letra faz parte da resposta: anote-a e avance na diagonal para cima e para a esquerda. Caso contrário, passe para a vizinha, de cima ou da esquerda, com o maior valor, porque foi daí que a célula obteve o seu valor. Pare na primeira linha ou coluna. As letras anotadas, pela ordem inversa, são a subsequência.
História e aplicações
O método da tabela foi descoberto de forma independente por várias pessoas por volta de 1970, entre elas Robert Wagner e Michael Fischer, cujo artigo de 1974 resolveu o problema muito próximo da distância de edição. Em 1975, Dan Hirschberg mostrou como encontrar a subsequência com muito menos memória, e em 1976 James Hunt e Douglas McIlroy basearam o programa Unix diff nas subsequências comuns mais longas de linhas. Os biólogos usam a mesma ideia, com pontuações, para alinhar sequências de ADN e de proteínas.
Explore
Abra a aplicação e prima Avançar. As duas letras a comparar acendem-se nos cabeçalhos; uma coincidência lê a célula azul acima à esquerda, uma diferença lê as duas células azuis de cima e da esquerda. Quando a tabela está cheia, o caminho laranja sobe a partir do canto e as letras da resposta aparecem por baixo da tabela.
Perguntas frequentes
De quanto tempo e memória precisa o algoritmo LCS?
Tempo O(m·n) para palavras de comprimentos m e n. A tabela completa também precisa de memória O(m·n) para ler a resposta de volta; em 1975, Dan Hirschberg mostrou como encontrar a própria subsequência com apenas O(min(m, n)) de memória.
Como é que o diff usa a subsequência comum mais longa?
Trata cada linha de um ficheiro como um símbolo e encontra uma subsequência comum mais longa das linhas dos dois ficheiros. As linhas dessa subsequência ficaram iguais; as outras linhas do ficheiro antigo foram apagadas, e as outras linhas do ficheiro novo foram acrescentadas.
E com três ou mais palavras?
A tabela ganha uma dimensão por palavra, por isso três palavras de comprimento n precisam de n³ células. Para um número arbitrário de palavras, o problema é NP-difícil.
Qual é a relação entre a LCS e a distância de edição?
Se só forem permitidas inserções e eliminações, a distância de edição entre duas palavras é o seu comprimento total menos o dobro do comprimento da sua subsequência comum mais longa. Permitindo também substituições, obtém-se a distância de Levenshtein, calculada com uma tabela muito semelhante.
Ferramentas relacionadas
Subsequência comum mais longa (LCS)
Veja passo a passo como se encontra a subsequência comum mais longa de duas palavras. Veja cada célula comparar duas letras e preencher-se a partir das vizinhas, e as letras comuns serem reconstruídas a partir do canto.
Distância de edição (distância de Levenshtein)
Calcule a distância de edição entre duas palavras e veja a tabela de Levenshtein a encher-se passo a passo. Veja cada célula escolher entre inserir, eliminar e substituir, e leia as operações de trás para a frente a partir do canto.
Subsequência crescente mais longa (LIS)
Veja passo a passo como se encontra a subsequência crescente mais longa de uma lista. Cada valor é comparado com os anteriores, vê-se o comprimento da melhor cadeia que termina em cada posição e a resposta é lida de trás para a frente.
Problema da mochila
Coloque itens numa mochila por quilos e dólares, encontre a mochila mais valiosa e veja a programação dinâmica resolver o problema da mochila 0/1 passo a passo numa tabela.
Fibonacci com programação dinâmica
Veja os números de Fibonacci preencherem uma tabela, uma adição de cada vez. Compare a tabulação ascendente com a memoização descendente, observe a pilha de chamadas e conte as chamadas que a recursão simples faria.
Pronto para experimentar?
Abra o PictorX no seu navegador – sem instalação, sem necessidade de cartão de crédito para começar.
Experimentar a subsequência comum mais longa