
सबसे लंबा सामान्य उपअनुक्रम (LCS)
जब आप किसी फ़ाइल के दो संस्करणों की तुलना करते हैं, तो जो लाइनें नहीं बदलीं, वे दोनों का एक सामान्य उपअनुक्रम होती हैं। उनमें सबसे लंबा खोजने से ठीक-ठीक पता चलता है कि क्या जोड़ा गया और क्या हटाया गया। यही विचार DNA स्ट्रैंड का संरेखण करता है और वर्तनी सुधार सुझाता है, और इसे कंप्यूटर विज्ञान की सबसे सुंदर तालिकाओं में से एक हल करती है।
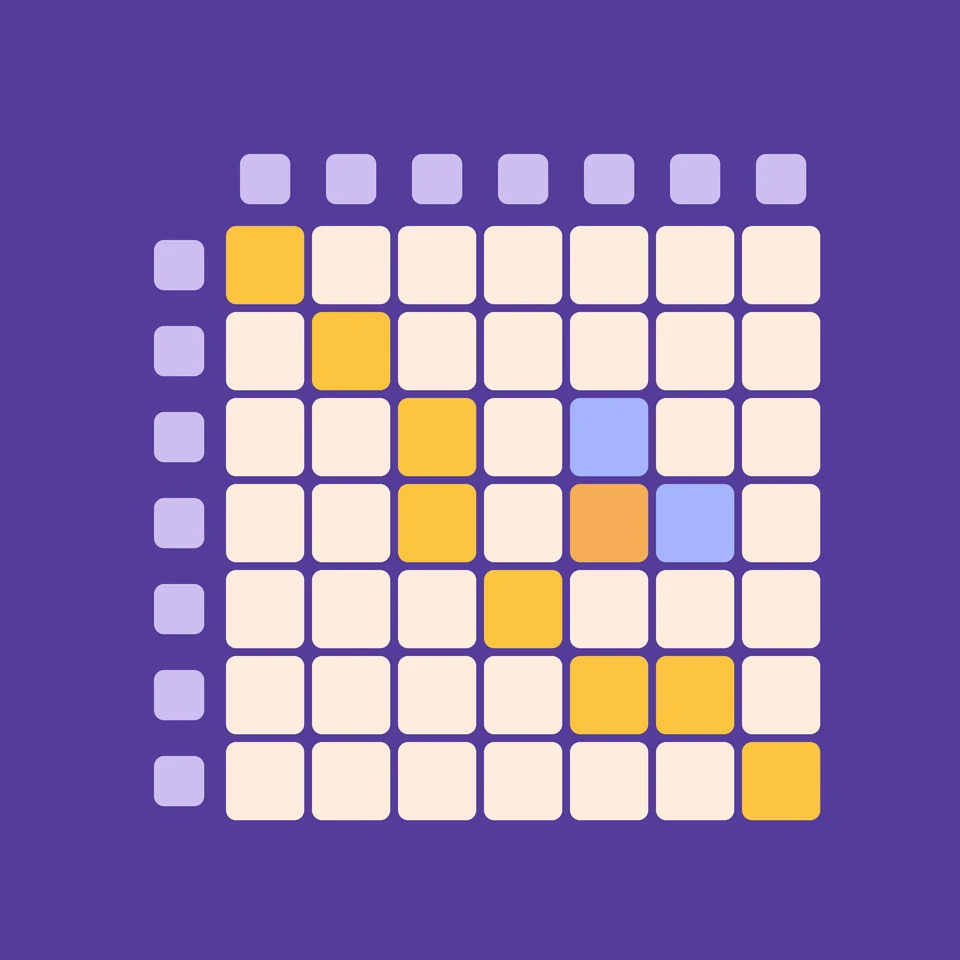
समस्या
किसी शब्द का उपअनुक्रम उसके कुछ अक्षरों को उनके मूल क्रम में रखता है: ACE, ABCDE का उपअनुक्रम है, पर EA नहीं है। दो शब्दों का सामान्य उपअनुक्रम वह है जो दोनों का उपअनुक्रम हो, और समस्या सबसे लंबे को खोजने की है। n लंबाई के शब्द के 2ⁿ उपअनुक्रम होते हैं, इसलिए कुछ अक्षरों से ज़्यादा होने पर सभी को आज़माना नामुमकिन है।
तालिका
मान लें len[i][j] एक शब्द के पहले i अक्षरों और दूसरे शब्द के पहले j अक्षरों के सबसे लंबे सामान्य उपअनुक्रम की लंबाई है। खाली शब्द में किसी से कुछ भी साझा नहीं होता, इसलिए पहली पंक्ति और पहला कॉलम 0 हैं। अगर अक्षर i, अक्षर j के बराबर है, तो len[i][j] = len[i − 1][j − 1] + 1: यह मेल पहले जो था उसे आगे बढ़ाता है। नहीं तो len[i][j], len[i − 1][j] और len[i][j − 1] में से बड़ा है: दोनों में से एक अक्षर छोड़ दें और बेहतर नतीजा रखें।
एक उदाहरण
ABCBDAB की तुलना BDCABA से करें। दूसरे शब्द का पहला अक्षर B, पंक्ति 2 के B से मेल खाता है; तीसरे कॉलम का C पंक्ति 3 से मेल खाता है, और इसी तरह आगे, हर मेल ऊपर-बाएँ वाले सेल में एक जोड़ता है। नीचे दाएँ वाला सेल अंत में 4 होता है। वहाँ से उल्टा पढ़ने पर BCBA मिलता है, लेकिन BCAB और BDAB भी उतने ही लंबे हैं: सबसे लंबा सामान्य उपअनुक्रम ज़रूरी नहीं कि अद्वितीय हो।
उत्तर को उल्टा पढ़ना
नीचे दाएँ वाले सेल से शुरू करें। अगर उसकी पंक्ति और कॉलम के अक्षर मेल खाते हैं, तो वह अक्षर उत्तर का हिस्सा है: उसे लिख लें और तिरछे ऊपर-बाएँ जाएँ। नहीं तो ऊपर या बाएँ वाले उस पड़ोसी पर जाएँ जिसका मान बड़ा है, क्योंकि सेल को उसका मान वहीं से मिला था। पहली पंक्ति या पहले कॉलम पर रुक जाएँ। लिखे गए अक्षर, उल्टे क्रम में, उपअनुक्रम हैं।
इतिहास और उपयोग
तालिका वाला तरीका 1970 के आसपास कई लोगों ने अलग-अलग खोजा, जिनमें रॉबर्ट वैगनर और माइकल फ़िशर भी थे, जिनके 1974 के शोधपत्र ने इससे गहराई से जुड़ी एडिट डिस्टेंस की समस्या हल की। 1975 में डैन हिर्शबर्ग ने दिखाया कि उपअनुक्रम को बहुत कम मेमोरी में कैसे खोजा जाए, और 1976 में जेम्स हंट और डगलस मैकइलरॉय ने लाइनों के सबसे लंबे सामान्य उपअनुक्रमों पर Unix diff प्रोग्राम बनाया। जीवविज्ञानी यही विचार, स्कोर के साथ, DNA और प्रोटीन अनुक्रमों के संरेखण के लिए इस्तेमाल करते हैं।
इसे खुद आज़माएँ
ऐप खोलें और “आगे” दबाएँ। जिन दो अक्षरों की तुलना हो रही है, वे शीर्षकों में चमकते हैं; मेल होने पर ऊपर-बाएँ वाला नीला सेल पढ़ा जाता है, मेल न होने पर ऊपर और बाएँ वाले दो नीले सेल। तालिका भर जाने पर नारंगी रास्ता कोने से वापस ऊपर चढ़ता है और उत्तर के अक्षर तालिका के नीचे दिखते हैं।
अक्सर पूछे जाने वाले प्रश्न
LCS एल्गोरिदम को कितना समय और मेमोरी चाहिए?
m और n लंबाई के शब्दों के लिए O(m·n) समय। उत्तर को उल्टा पढ़ने के लिए पूरी तालिका को भी O(m·n) मेमोरी चाहिए; डैन हिर्शबर्ग ने 1975 में दिखाया कि उपअनुक्रम को केवल O(min(m, n)) मेमोरी में कैसे खोजा जाए।
diff सबसे लंबे सामान्य उपअनुक्रम का उपयोग कैसे करता है?
यह फ़ाइल की हर लाइन को एक प्रतीक मानता है और दोनों फ़ाइलों की लाइनों का सबसे लंबा सामान्य उपअनुक्रम खोजता है। उस उपअनुक्रम की लाइनें नहीं बदलीं; पुरानी फ़ाइल की बाकी लाइनें हटाई गईं, और नई फ़ाइल की बाकी लाइनें जोड़ी गईं।
तीन या ज़्यादा शब्दों का क्या?
हर शब्द के लिए तालिका में एक आयाम बढ़ जाता है, इसलिए n लंबाई के तीन शब्दों के लिए n³ सेल चाहिए। शब्दों की किसी भी संख्या के लिए यह समस्या NP-हार्ड है।
LCS का एडिट डिस्टेंस से क्या संबंध है?
अगर केवल जोड़ने और हटाने की अनुमति हो, तो दो शब्दों की एडिट डिस्टेंस उनकी कुल लंबाई में से उनके सबसे लंबे सामान्य उपअनुक्रम की लंबाई का दोगुना घटाने पर मिलती है। अक्षर बदलने की भी अनुमति देने पर लेवेनश्टाइन दूरी मिलती है, जिसकी गणना बहुत मिलती-जुलती तालिका से होती है।
संबंधित टूल
सबसे लंबा सामान्य उपअनुक्रम (LCS)
दो शब्दों का सबसे लंबा सामान्य उपअनुक्रम चरण-दर-चरण खोजा जाता देखें। हर सेल को दो अक्षरों की तुलना करते और पड़ोसी सेलों से भरते देखें, फिर साझा अक्षरों को कोने से पीछे की ओर खोजें।
एडिट डिस्टेंस (लेवेनश्टाइन डिस्टेंस)
दो शब्दों के बीच एडिट डिस्टेंस निकालें और लेवेनश्टाइन टेबल को चरण-दर-चरण भरते देखें। देखें कि हर सेल जोड़ने, हटाने और बदलने में से कैसे चुनता है, और कोने से एडिट उल्टे क्रम में पढ़ें।
सबसे लंबा बढ़ता उपक्रम (LIS)
देखें कि किसी सूची का सबसे लंबा बढ़ता उपक्रम चरण दर चरण कैसे मिलता है। हर मान की उससे पहले के मानों से तुलना, हर स्थान पर खत्म होने वाले सबसे अच्छे क्रम की लंबाई, और पीछे से पढ़ा गया उत्तर देखें।
नैपसैक समस्या
किलोग्राम और डॉलर के हिसाब से वस्तुओं को बैग में भरें, सबसे क़ीमती बैग खोजें, और देखें कि डायनेमिक प्रोग्रामिंग 0/1 नैपसैक समस्या को तालिका में क़दम-दर-क़दम कैसे हल करती है।
गतिशील प्रोग्रामिंग से फ़िबोनाची
देखें कि फ़िबोनाची संख्याएँ एक-एक जोड़ करके टेबल कैसे भरती हैं। बॉटम-अप टेबुलेशन की तुलना टॉप-डाउन मेमोइज़ेशन से करें, कॉल स्टैक देखें, और गिनें कि सामान्य रिकर्शन कितनी कॉल करता।
आज़माने के लिए तैयार?
अपने ब्राउज़र में PictorX खोलें — शुरू करने के लिए इंस्टॉल या क्रेडिट कार्ड की ज़रूरत नहीं।
सबसे लंबा सामान्य उपअनुक्रम आज़माएँ