
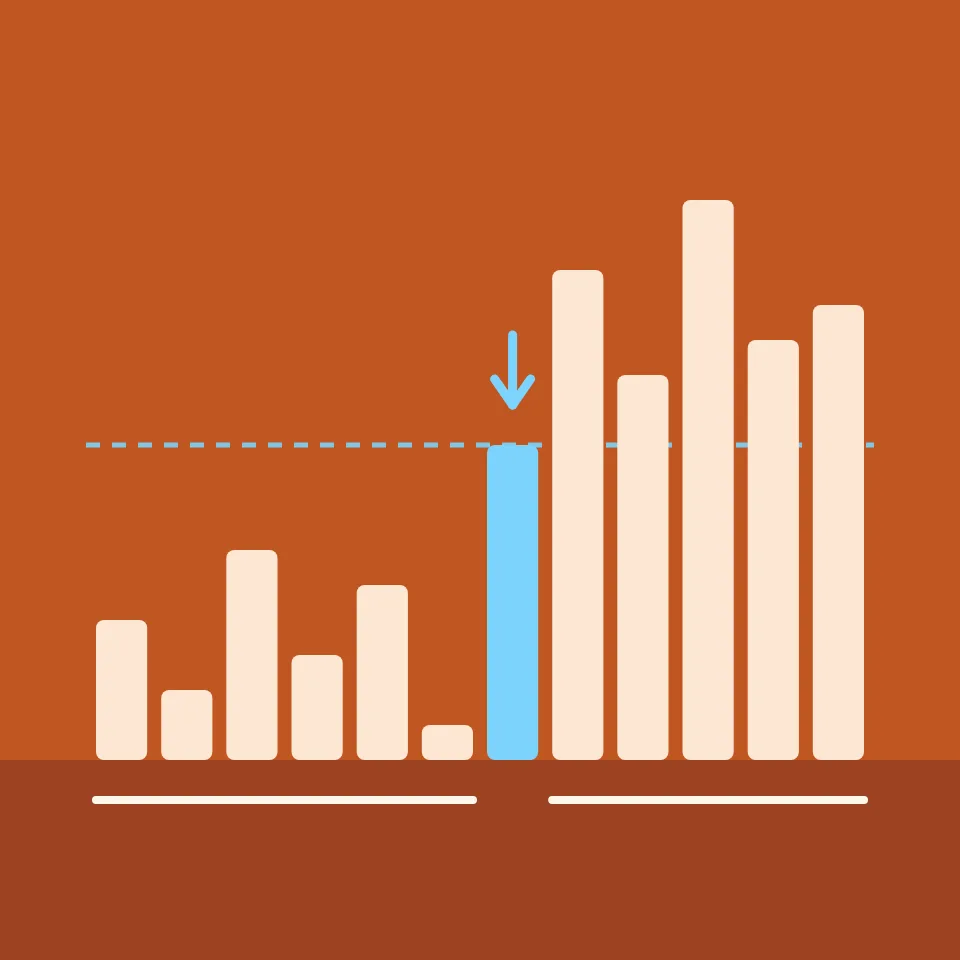
基本思路
选一个值作为基准。重新排列列表,使比基准小的值都在它前面,其余的值都在它后面。这种重新排列叫做分区,它会把基准放到排好序的列表中应在的位置。两侧现在是相互独立的问题:分别用快速排序排序。只有一个值或没有值的一侧已经有序。
分区的步骤
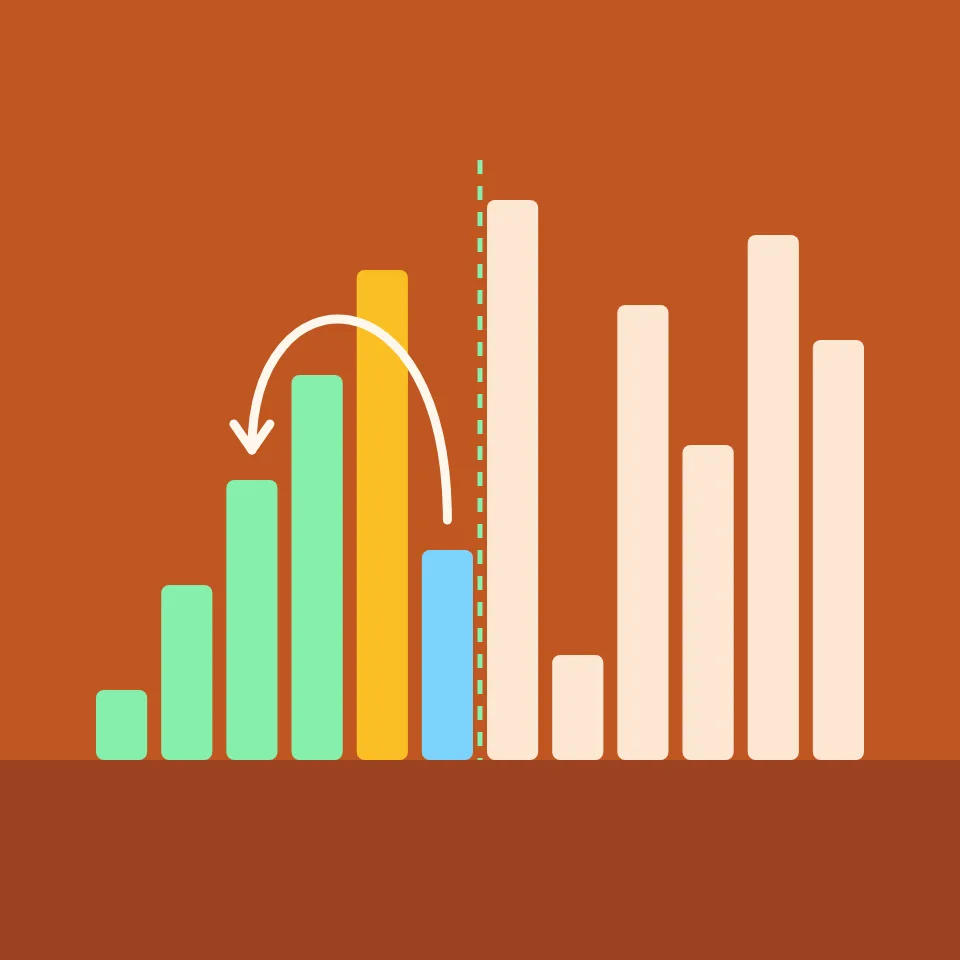
本应用使用 Lomuto 分区。基准先被移到该部分的末尾。一个标记从开头出发:它前面的值都比基准小。其他每个值都与基准比较;如果更小,就交换到标记处,标记向后移一位。最后,基准交换到标记处。以 5, 1, 4, 2, 8 为例,取最后一个值为基准:四个值都比 8 小,所以 8 留在末尾。部分 5, 1, 4, 2 围绕 2 分区,得到 1, 2, 4, 5,再将 4, 5 围绕 5 分区。共 8 次比较、2 次交换、3 次分区。
好基准与坏基准
如果每个基准都落在中间,每次分区都会把问题减半,排序约需 n log₂ n 次比较。在随机列表上,基准很少完美,但通常足够好:40 个随机值时,应用统计约 190 次比较。最坏情况出现在基准总是最小值或最大值时。以最后一个值为基准,已经排好序或倒序的列表正是如此:每次分区只去掉基准本身,排序需要 n(n − 1)/2 次比较,40 个值就是 780 次。
选择基准
随机基准让任何输入都极不可能出现最坏情况,因为没有哪种特定顺序能骗过它。三数取中,即首、中、尾三个元素的中间值,开销小,又能很好地处理已排序和倒序的列表。在应用中对已排序的列表试试这两种方式,比较次数会从 780 降到约 150。大量相等的值是另一个问题:它们都会落在基准的同一侧。三路分区把等于基准的值放在中间部分,可以解决这个问题。
历史与应用
Tony Hoare 在 1959 年发明了快速排序,并于 1961 年发表。他自己的分区方法从两端扫描,交换次数更少;这里展示的更简单的 Lomuto 版本则通过教科书流行起来。快速排序原地排序,内层循环很短,所以在实践中通常比归并排序快,但它不稳定。C++ 标准库背后的排序 introsort 先运行快速排序,分区太不均匀时就改用堆排序,因此最坏情况仍是 n log n。
动手试试
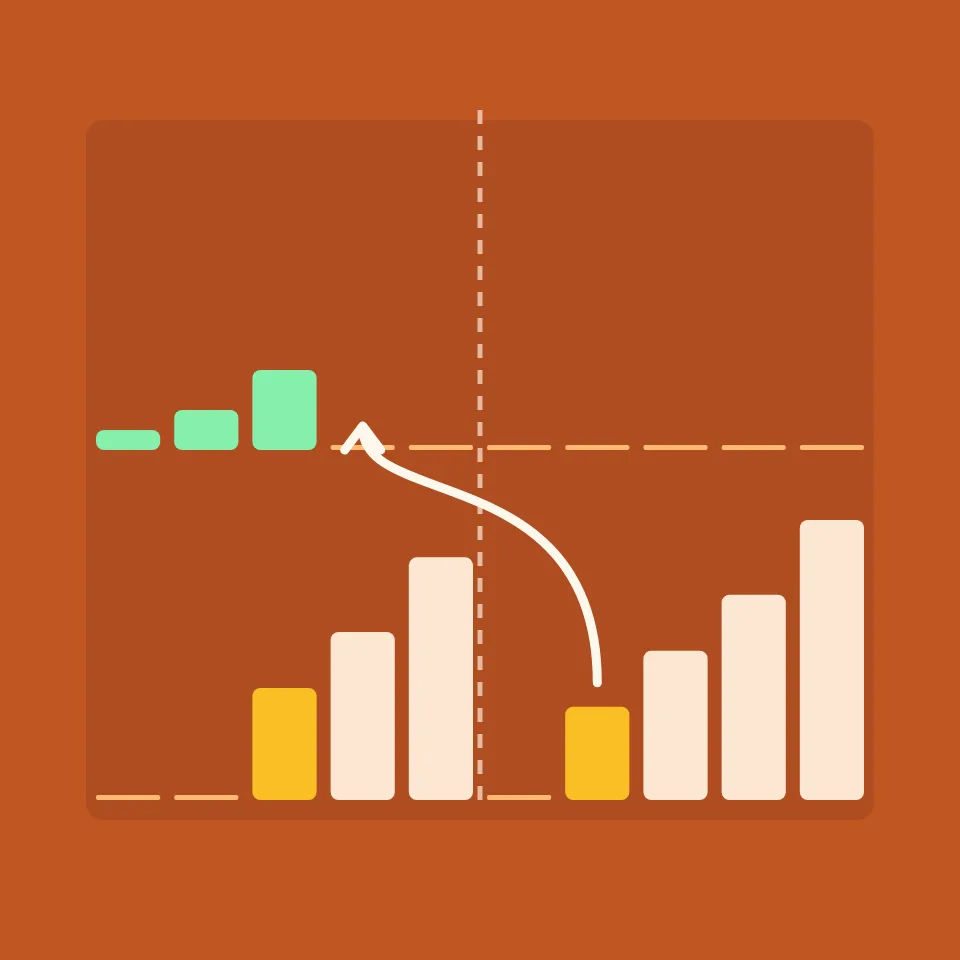
打开应用并按“单步”。正在分区的部分带有阴影,基准有自己的颜色,虚线标出左侧部分(即比基准小的值)的末尾。每个基准到达最终位置时会变成绿色。选择已排序的列表并以最后一个值为基准,然后切换到三数取中,比较计数。
常见问题
快速排序的时间复杂度是多少?
平均情况及基准良好时为 O(n log n),最坏情况为 O(n²)。它原地排序;如果先对较小的一侧排序,递归需要 O(log n) 的额外内存。
Lomuto 分区和 Hoare 分区有什么区别?
Lomuto 使用一个标记,从左到右扫描,容易理解,本应用展示的就是它。Hoare 从两端相向扫描,交换位于错误一侧的值对,平均交换次数约为前者的三分之一。
为什么相等的值很多时快速排序会变慢?
等于基准的值都会去到同一侧,所以不同值很少的列表会分得不均匀,全部相等的列表则和最坏情况一样糟。三路分区把等于基准的值集中在中间,可以避免这种情况。
快速排序稳定吗?
不稳定。分区时的交换会把值移动很远,相等的值可能改变顺序。
相关工具
快速排序
逐步观看快速排序。选择基准规则,看每次分区如何把较小的值移到基准前面,并统计比较、交换和分区次数。
归并排序
逐步观看归并排序。看列表被对半拆分、排好的两半再合并回去,可调节速度,并统计比较、写回和合并次数。
插入排序
逐步观看插入排序。看每个值如何向前移入已排序部分,调节速度,并统计比较次数、交换次数和趟数。
选择排序
逐步观看选择排序:每一趟找出最小值并交换到位。可调节速度,统计比较次数、交换次数和趟数。
冒泡排序
逐步观看冒泡排序。播放、暂停或单步查看每次比较和交换,调节速度,并统计比较次数、交换次数和趟数。

堆排序
逐步观看堆排序。看列表变成最大堆并画成一棵树,再从堆顶逐个取出最大值,同时统计比较和交换次数。
准备好尝试了吗?
在浏览器中打开 PictorX — 无需安装,无需信用卡即可启动。
试试快速排序