
Sortowanie szybkie
Sortowanie szybkie to jeden z najczęściej używanych algorytmów sortowania. Wybiera pivot (element osiowy), dzieli listę na wartości mniejsze od pivota i resztę, a potem tak samo sortuje obie strony. W praktyce jest szybkie i nie potrzebuje dodatkowej listy, ale to, jak szybkie, zależy od pivota.
Idea
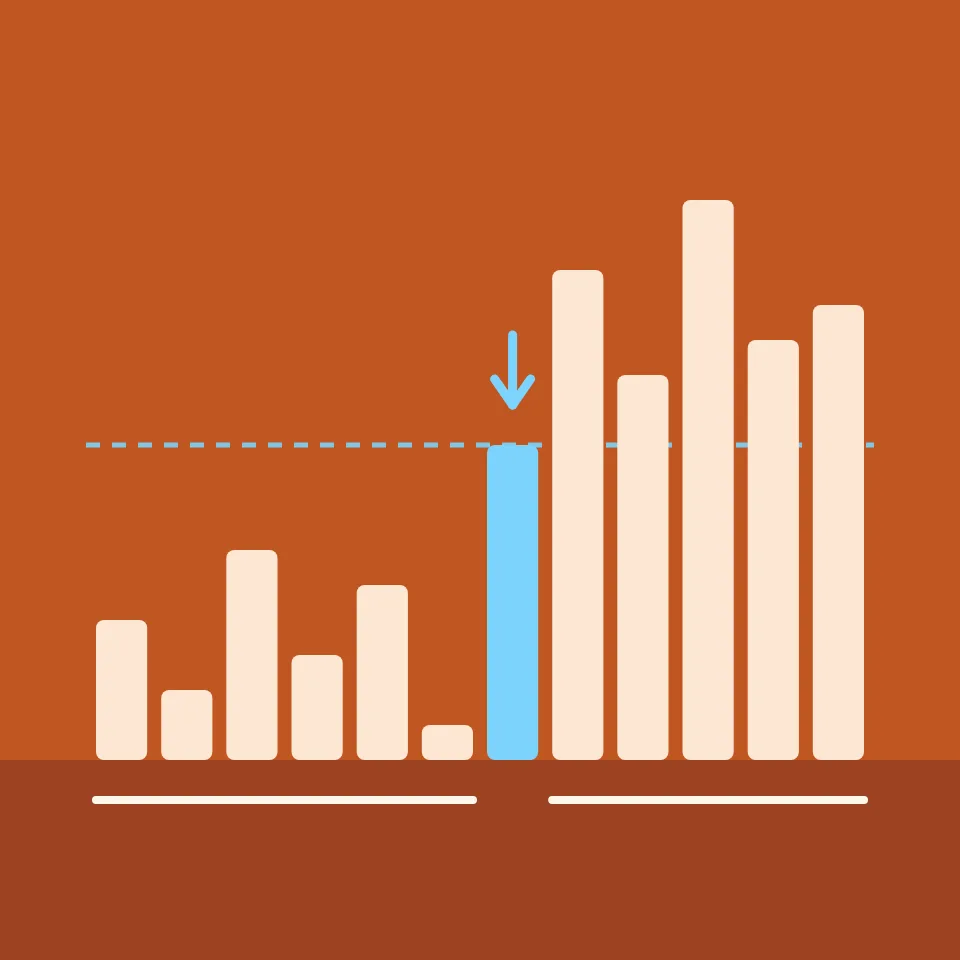
Wybierz jedną wartość jako pivot. Przestaw listę tak, by każda wartość mniejsza od pivota była przed nim, a każda inna za nim. To przestawianie nazywa się podziałem i zostawia pivot dokładnie tam, gdzie powinien być na posortowanej liście. Obie strony są teraz niezależnymi problemami: posortuj każdą z nich sortowaniem szybkim. Strona z jedną wartością lub pusta jest już posortowana.
Podział krok po kroku
Aplikacja używa podziału Lomuto. Pivot trafia na koniec części. Znacznik zaczyna na początku: wszystko przed nim jest mniejsze od pivota. Każda inna wartość jest porównywana z pivotem; jeśli jest mniejsza, zostaje zamieniona na miejsce znacznika, a znacznik przesuwa się o jedno miejsce. Na koniec pivot zostaje zamieniony na miejsce znacznika. Weźmy 5, 1, 4, 2, 8 z ostatnią wartością jako pivotem: wszystkie cztery wartości są mniejsze od 8, więc 8 zostaje na końcu. Część 5, 1, 4, 2 zostaje podzielona wokół 2, co daje 1, 2, 4, 5, a 4, 5 wokół 5. To 8 porównań, 2 zamiany i 3 podziały.
Dobre i złe pivoty
Gdyby każdy pivot wypadał w środku, każdy podział zmniejszałby problem o połowę, a sortowanie wymagałoby około n log₂ n porównań. Na losowej liście pivoty rzadko są idealne, ale zwykle wystarczająco dobre: dla 40 losowych wartości aplikacja liczy około 190 porównań. Najgorszy przypadek zachodzi, gdy pivot jest zawsze najmniejszą lub największą wartością. Gdy pivotem jest ostatnia wartość, dokładnie tak dzieje się na liście już posortowanej lub odwróconej: każdy podział usuwa tylko pivot, a sortowanie wymaga n(n − 1)/2 porównań, 780 dla 40 wartości.
Wybór pivota
Losowy pivot sprawia, że najgorszy przypadek jest skrajnie mało prawdopodobny dla dowolnych danych, bo żadna kolejność nie może go oszukać. Mediana z trzech, czyli środkowa z wartości pierwszego, środkowego i ostatniego elementu, jest tania i dobrze radzi sobie z listami posortowanymi i odwróconymi. Wypróbuj obie na posortowanej liście w aplikacji, a liczba porównań spadnie z 780 do około 150. Wiele równych wartości to inny problem: wszystkie trafiają na jedną stronę pivota. Podział trójdzielny, który trzyma wartości równe pivotowi w środkowej części, rozwiązuje ten problem.
Historia i zastosowania
Tony Hoare wymyślił sortowanie szybkie w 1959 roku i opublikował je w 1961. Jego własny podział przeszukuje listę z obu końców i wykonuje mniej zamian; prostsza wersja Lomuto, pokazana tutaj, stała się popularna dzięki podręcznikom. Sortowanie szybkie sortuje w miejscu, a jego pętla wewnętrzna jest bardzo krótka, więc w praktyce zwykle jest szybsze od sortowania przez scalanie, choć nie jest stabilne. Introsort, sortowanie w bibliotece standardowej C++, uruchamia sortowanie szybkie i przechodzi na sortowanie przez kopcowanie, gdy podziały stają się zbyt nierówne, więc jego najgorszy przypadek pozostaje n log n.
Wypróbuj
Otwórz aplikację i naciśnij Krok. Dzielona część jest zacieniona, pivot ma własny kolor, a przerywana linia oznacza koniec lewej części, czyli wartości mniejszych od pivota. Każdy pivot robi się zielony, gdy trafi na swoje ostateczne miejsce. Wybierz posortowaną listę i ostatnią wartość jako pivot, potem przełącz na medianę z trzech i porównaj liczniki.
Często zadawane pytania
Jaka jest złożoność czasowa sortowania szybkiego?
O(n log n) średnio i przy dobrych pivotach, O(n²) w najgorszym przypadku. Sortuje w miejscu; rekurencja potrzebuje O(log n) dodatkowej pamięci, gdy mniejsza strona jest sortowana najpierw.
Czym różni się podział Lomuto od podziału Hoare'a?
Lomuto używa jednego znacznika i przechodzi od lewej do prawej, co łatwo śledzić i co pokazuje ta aplikacja. Hoare przechodzi z obu końców ku sobie i zamienia pary, które są po złej stronie, co średnio daje około trzy razy mniej zamian.
Dlaczego sortowanie szybkie jest wolne, gdy wiele wartości jest równych?
Wartości równe pivotowi trafiają na tę samą stronę, więc lista z niewieloma różnymi wartościami dzieli się nierówno, a lista równych wartości jest tak zła jak najgorszy przypadek. Podział trójdzielny, który zbiera wartości równe pivotowi w środku, temu zapobiega.
Czy sortowanie szybkie jest stabilne?
Nie. Zamiany podczas podziału przenoszą wartości na duże odległości, więc równe wartości mogą zmienić kolejność.
Powiązane narzędzia
Sortowanie szybkie
Obejrzyj sortowanie szybkie (quicksort) krok po kroku. Wybierz regułę pivota, zobacz, jak każdy podział przenosi mniejsze wartości przed pivot, i licz porównania, zamiany i podziały.
Sortowanie przez scalanie
Obejrzyj sortowanie przez scalanie krok po kroku. Zobacz, jak lista dzieli się na pół, a posortowane połowy są z powrotem scalane, ustaw prędkość i licz porównania, zapisy i scalenia.
Sortowanie przez wstawianie
Zobacz sortowanie przez wstawianie krok po kroku. Obserwuj, jak każda wartość wsuwa się wstecz do posortowanej części, ustaw prędkość i licz porównania, zamiany i przebiegi.
Sortowanie przez wybieranie
Obejrzyj sortowanie przez wybieranie krok po kroku. Zobacz, jak każdy przebieg znajduje najmniejszą wartość i przenosi ją na właściwe miejsce, ustaw prędkość i licz porównania, zamiany i przebiegi.
Sortowanie bąbelkowe
Zobacz sortowanie bąbelkowe krok po kroku. Odtwarzaj, wstrzymuj lub przechodź przez każde porównanie i zamianę, ustaw prędkość i licz porównania, zamiany i przebiegi.

Sortowanie przez kopcowanie
Zobacz sortowanie przez kopcowanie krok po kroku. Lista staje się kopcem typu max, narysowanym jako drzewo, a potem największa wartość jest po kolei zdejmowana ze szczytu. Licz porównania i zamiany.
Chcesz wypróbować?
Otwórz PictorX w swojej przeglądarce — do uruchomienia nie jest wymagana żadna instalacja ani karta kredytowa.
Wypróbuj sortowanie szybkie