
Быстрая сортировка
Быстрая сортировка — один из самых используемых алгоритмов сортировки. Она выбирает опорный элемент, делит список на значения меньше опорного и все остальные и так же сортирует обе стороны. На практике она быстрая и не требует дополнительного списка, но насколько быстрая — зависит от опорного элемента.
Идея
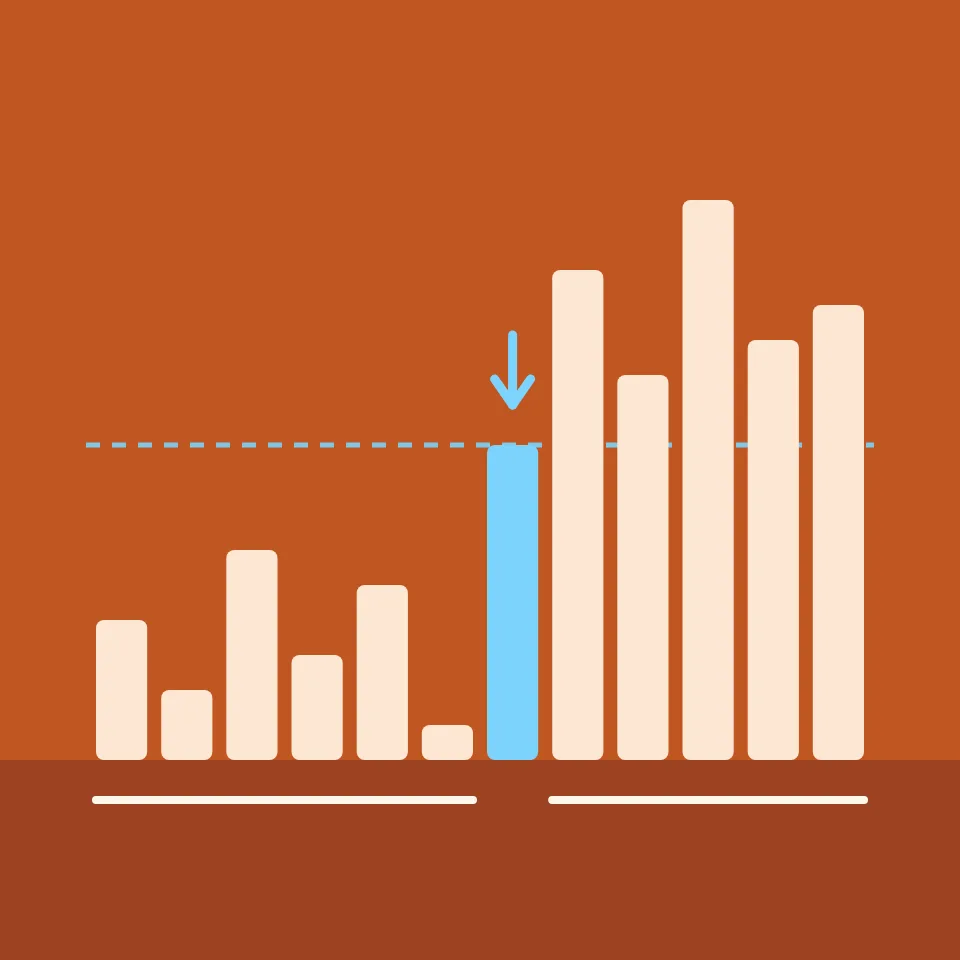
Выберите одно значение в качестве опорного. Переставьте список так, чтобы каждое значение меньше опорного стояло перед ним, а каждое другое — после него. Такая перестановка называется разбиением, и после неё опорный элемент стоит ровно там, где ему место в отсортированном списке. Две стороны теперь — независимые задачи: отсортируйте каждую быстрой сортировкой. Сторона с одним значением или пустая уже отсортирована.
Разбиение шаг за шагом
Приложение использует разбиение Lomuto. Опорный элемент переносится в конец части. Метка стоит в начале: всё перед ней меньше опорного. Каждое другое значение сравнивается с опорным; если оно меньше, его обменивают на место метки, и метка сдвигается на одно место. В конце опорный элемент обменивают на место метки. Возьмём 5, 1, 4, 2, 8 с последним значением в качестве опорного: все четыре значения меньше 8, поэтому 8 остаётся в конце. Часть 5, 1, 4, 2 разбивается вокруг 2, что даёт 1, 2, 4, 5, а 4, 5 — вокруг 5. Итого 8 сравнений, 2 обмена и 3 разбиения.
Хорошие и плохие опорные элементы
Если бы каждый опорный элемент попадал в середину, каждое разбиение делило бы задачу пополам, и сортировка требовала бы около n log₂ n сравнений. На случайном списке опорные элементы редко идеальны, но обычно достаточно хороши: для 40 случайных значений приложение насчитывает около 190 сравнений. Худший случай наступает, когда опорный элемент каждый раз — наименьшее или наибольшее значение. Если опорный элемент — последнее значение, именно так происходит на уже отсортированном или обратном списке: каждое разбиение убирает только опорный элемент, и сортировка требует n(n − 1)/2 сравнений, 780 для 40 значений.
Выбор опорного элемента
Случайный опорный элемент делает худший случай крайне маловероятным для любых входных данных, потому что никакой порядок не может его обмануть. Медиана трёх, то есть средний по величине из первого, среднего и последнего элементов, дёшева и хорошо справляется с отсортированными и обратными списками. Попробуйте оба способа на отсортированном списке в приложении, и число сравнений упадёт с 780 примерно до 150. Много равных значений — другая проблема: все они попадают на одну сторону от опорного. Трёхчастное разбиение, которое держит значения, равные опорному, в средней части, решает её.
История и применение
Tony Hoare придумал быструю сортировку в 1959 году и опубликовал её в 1961 году. Его собственное разбиение идёт с обоих концов и делает меньше обменов; более простой вариант Lomuto, показанный здесь, стал популярным благодаря учебникам. Быстрая сортировка сортирует на месте, а её внутренний цикл очень короткий, поэтому на практике она обычно быстрее сортировки слиянием, хотя и не устойчива. Introsort, сортировка в стандартной библиотеке C++, запускает быструю сортировку и переходит на пирамидальную, если разбиения становятся слишком неравными, так что её худший случай остаётся n log n.
Попробуйте сами
Откройте приложение и нажмите «Шаг». Разбиваемая часть затенена, у опорного элемента свой цвет, а пунктирная линия отмечает конец левой части, то есть значений меньше опорного. Каждый опорный элемент становится зелёным, когда встаёт на своё окончательное место. Выберите отсортированный список и последнее значение в качестве опорного, затем переключитесь на медиану трёх и сравните счётчики.
Часто задаваемые вопросы
Какова временная сложность быстрой сортировки?
O(n log n) в среднем и при хороших опорных элементах, O(n²) в худшем случае. Сортирует на месте; рекурсии нужно O(log n) дополнительной памяти, если сначала сортировать меньшую сторону.
Чем разбиение Lomuto отличается от разбиения Hoare?
Lomuto использует одну метку и проходит слева направо: это легко отследить, и именно это показывает приложение. Hoare идёт с обоих концов навстречу друг другу и меняет местами пары, стоящие не на своей стороне, что в среднем даёт примерно втрое меньше обменов.
Почему быстрая сортировка медленна, когда много равных значений?
Значения, равные опорному, все уходят в одну сторону, поэтому список с малым числом разных значений делится неравномерно, а список из равных значений так же плох, как худший случай. Трёхчастное разбиение, которое собирает значения, равные опорному, в середине, этого избегает.
Устойчива ли быстрая сортировка?
Нет. Обмены при разбиении переносят значения на большие расстояния, поэтому равные значения могут поменять порядок.
Сопутствующие инструменты
Быстрая сортировка
Смотрите быструю сортировку шаг за шагом. Задайте правило выбора опорного элемента, посмотрите, как каждое разбиение ставит меньшие значения перед опорным, и считайте сравнения, обмены и разбиения.
Сортировка слиянием
Смотрите сортировку слиянием шаг за шагом: список делится пополам, а отсортированные половины сливаются обратно. Задайте скорость и считайте сравнения, записи и слияния.
Сортировка вставками
Смотрите сортировку вставками шаг за шагом: каждое значение сдвигается назад в отсортированную часть. Задайте скорость и считайте сравнения, обмены и проходы.
Сортировка выбором
Посмотрите сортировку выбором шаг за шагом: как каждый проход находит наименьшее значение и ставит его на место. Задайте скорость и считайте сравнения, обмены и проходы.
Сортировка пузырьком
Смотрите сортировку пузырьком шаг за шагом. Запускайте, ставьте на паузу или проходите каждое сравнение и обмен, меняйте скорость и считайте сравнения, обмены и проходы.

Пирамидальная сортировка
Смотрите пирамидальную сортировку шаг за шагом. Список становится max-кучей, нарисованной в виде дерева, а затем наибольшее значение по одному снимается с вершины. Считайте сравнения и обмены.
Готовы попробовать?
Откройте PictorX в своем браузере — установка не требуется, для запуска не требуется кредитная карта.
Попробовать быструю сортировку