
计数排序
计数排序完全不靠比较值来排序。如果你知道每个值都是介于 1 到 40 之间的整数,就可以直接数出每个值有几个,再根据计数算出每个值该放在哪里。范围小时,这几乎是最快的排序方式。
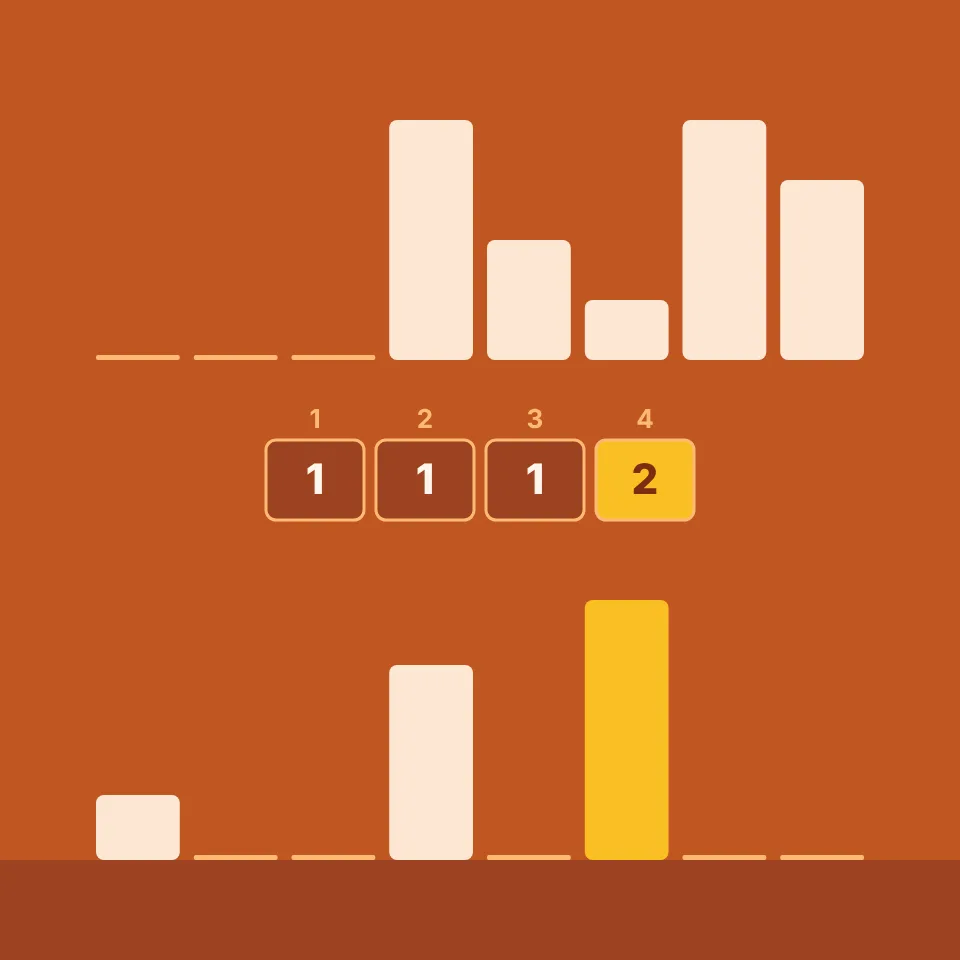
计数
找出最小值和最大值,为两者之间的每个值各设一个计数器,全部从零开始。从头到尾读一遍列表,每看到一个值,就把它的计数器加一。现在这些计数器构成一个直方图:有几个 1、几个 2,依此类推。有 n 个值和 k 个计数器时,这需要 n 步。
累加
等于最小值的那些值排在最前面,所以它们的区段从第 1 位开始。下一个值的区段紧接在它们之后,依此类推:每个区段都从它前面所有计数之和之后开始。这些累计和称为前缀和,它们把直方图变成排序后列表的地图。这需要 k 步。
放置
再读一遍列表,把每个值移到所在区段的下一个空位。因为值是按出现顺序移动的,相等的值保持原来的顺序:计数排序是稳定的。把缓冲区复制回去,列表就排好了。应用会显示每个计数器随着对应的值被放置而逐渐减少。
一个例子
以 4, 1, 3, 4, 2, 1, 4 为例。1 到 4 的计数器最终为 2、1、1 和 3。累加后得到各个区段:两个 1 在第 1 和第 2 位,2 在第 3 位,3 在第 4 位,三个 4 在第 5 到第 7 位。按列表顺序放置这些值,得到 1, 1, 2, 3, 4, 4, 4:计数 7 个值,移动 14 次,4 个计数器,没有比较。
何时使用
总工作量随 n + k 增长。当 k 比 n 小时,比如一千个 0 到 100 的考试分数,计数排序比任何比较排序都快,后者大约需要 n log₂ n 次比较。范围很大时就很浪费:几个分布到一百万的值需要一百万个计数器。基数排序解决了这个问题:每一位运行一次计数排序,所以每趟只需要十个计数器。Harold Seward 于 1954 年与基数排序一起描述了计数排序。
动手探索
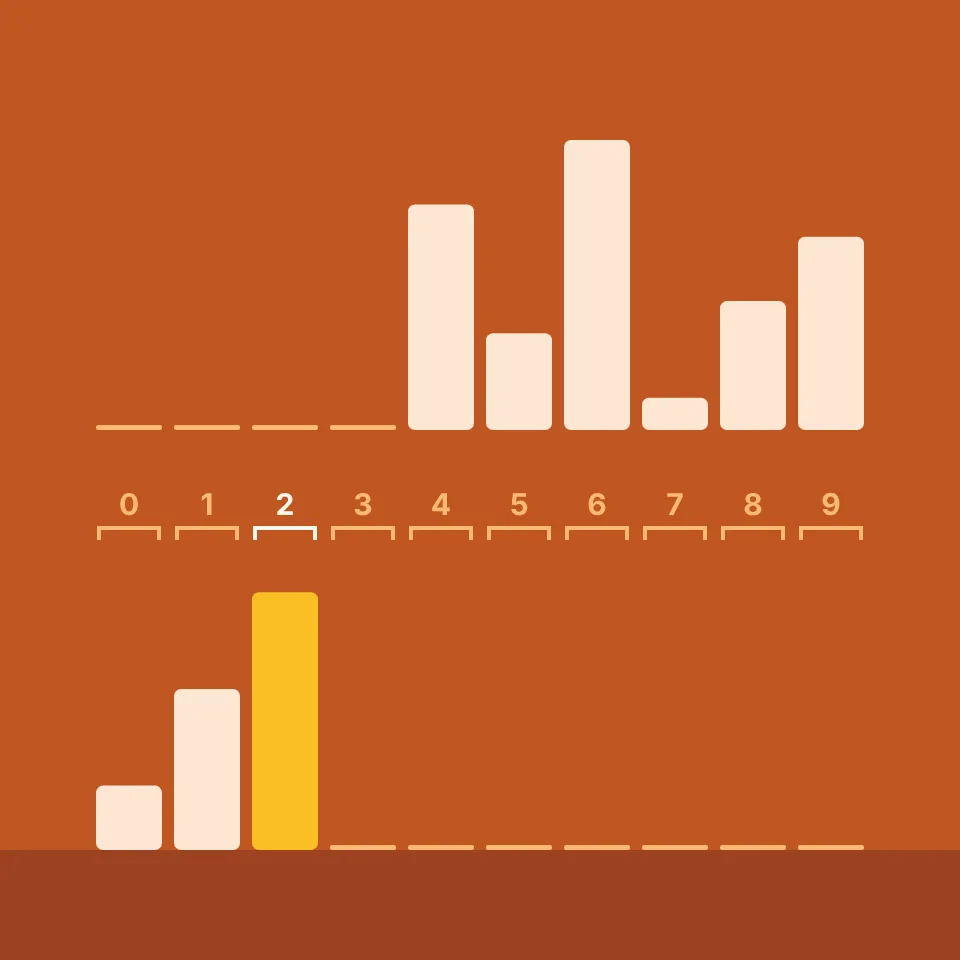
打开应用,按“单步”。列表和缓冲行之间的长条为每个值显示一个计数器。观察读取列表时计数器逐渐增加,累加计数时缓冲区中出现各个区段,放置值时计数器又逐渐减少。选择少量不同值可以看到大的区段,输入相差很远的数字可以看到范围大时需要多少计数器。
常见问题
计数排序的时间复杂度是多少?
n 个值、k 个可能的值时为 O(n + k),计数器和缓冲区还需要 O(n + k) 的额外内存。
为什么计数排序并不总是最快?
因为它的开销取决于值的范围,而不只是值的个数。如果范围远大于列表,大多数计数器都停留在零,时间和内存就白白浪费了。
计数排序能处理负数吗?
能。计数器从最小值排到最大值,所以减去最小值就得到计数器的下标。应用也是这样做的。
计数排序稳定吗?
稳定,只要按列表顺序把值移到所在区段的下一个空位。基数排序就依赖这一点。
相关工具
准备好尝试了吗?
在浏览器中打开 PictorX — 无需安装,无需信用卡即可启动。
试试计数排序