
Distância de edição (distância de Levenshtein)
Escreva recieve e o telemóvel sugere receive. Sabe que quase acertou porque as duas palavras estão a apenas algumas operações de distância. Medir essa proximidade, a distância de edição, é um problema clássico de programação dinâmica.
O problema
Uma operação altera uma palavra numa letra: inserir uma letra, eliminar uma letra ou substituir uma letra por outra. A distância de edição entre duas palavras é o menor número de operações que transformam uma na outra. Entre cat e cut a distância é 1, entre cat e cast também 1, e entre cat e act é 2. Também se chama distância de Levenshtein, em homenagem ao matemático soviético Vladimir Levenshtein, que a estudou em 1965.
A tabela
Seja d[i][j] a distância de edição entre as primeiras i letras de uma palavra e as primeiras j letras da outra. Transformar uma palavra em nada custa uma eliminação por letra, por isso d[i][0] = i, e construir uma palavra a partir do nada custa uma inserção por letra, por isso d[0][j] = j. Se a letra i for igual à letra j, d[i][j] = d[i − 1][j − 1]. Caso contrário, d[i][j] = 1 + o menor de d[i − 1][j − 1] (substituição), d[i − 1][j] (eliminação) e d[i][j − 1] (inserção).
Um exemplo
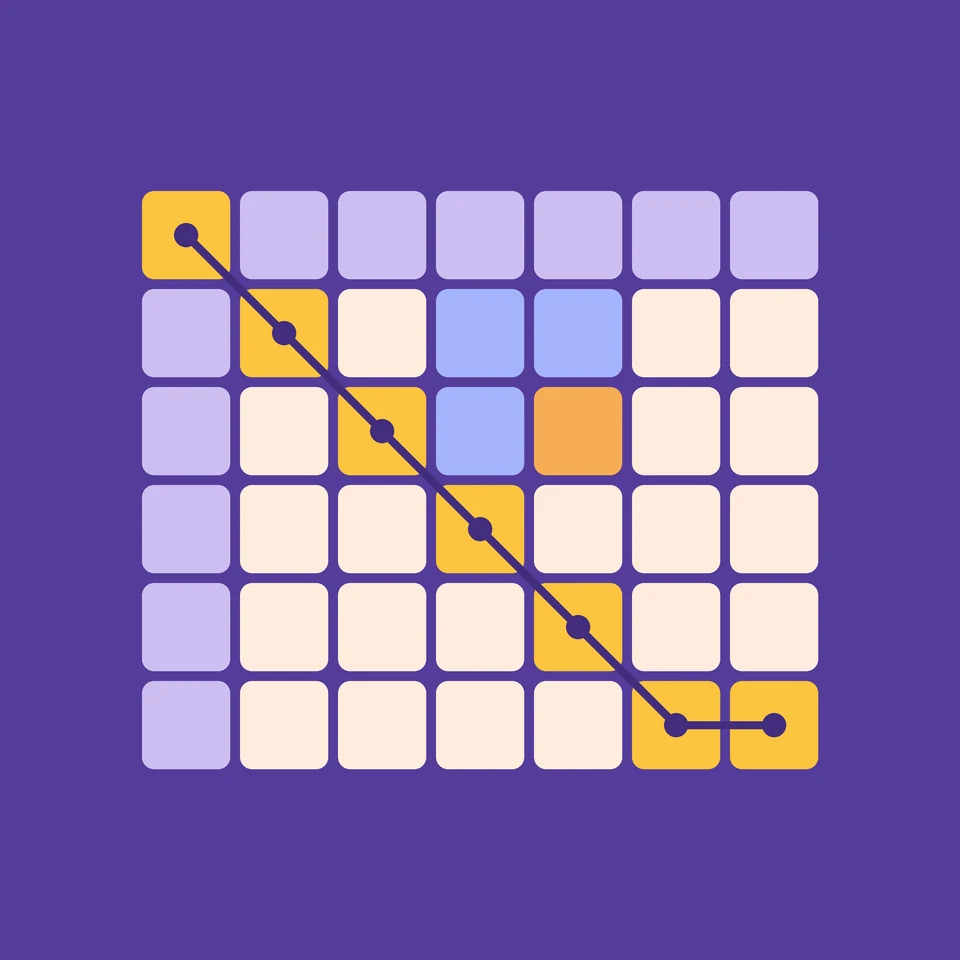
Para kitten e sitting, a tabela tem 7 linhas e 8 colunas. A célula do canto inferior direito vale 3, e a leitura de trás para a frente a partir dela dá: substituir k por s, manter i, t e t, substituir e por i, manter n e inserir g. De kitten para sitten, depois sittin e depois sitting: três operações, e a tabela prova que não existe nenhuma lista mais curta.
Ler as operações de trás para a frente
Comece na célula do canto inferior direito e pergunte de que vizinho veio o seu valor. Se as letras coincidirem e a célula for igual à vizinha acima e à esquerda, a letra foi mantida: avance na diagonal. Se valer mais um do que a vizinha acima e à esquerda, foi uma substituição; mais um do que a célula acima, uma eliminação; mais um do que a célula à esquerda, uma inserção. Vários caminhos podem empatar, e cada um dá uma lista de operações o mais curta possível.
História e aplicações
Levenshtein introduziu a distância em 1965, quando trabalhava em códigos corretores de erros. O método da tabela foi publicado por várias pessoas, sobretudo por Robert Wagner e Michael Fischer em 1974, e por isso chama-se muitas vezes algoritmo de Wagner–Fischer. Hoje, as distâncias de edição ordenam sugestões ortográficas, encontram nomes com gralhas em bases de dados, comparam sequências de ADN e de proteínas e avaliam o reconhecimento de fala.
Explore
Abra a aplicação e prima Avançar. As duas letras comparadas acendem-se nos cabeçalhos; se forem iguais, copia-se a célula azul acima e à esquerda, e se forem diferentes, leem-se os três vizinhos azuis e soma-se um ao menor. No fim, o caminho laranja volta para trás a partir do canto, e as operações aparecem por baixo da tabela.
Perguntas frequentes
A distância de edição é uma métrica?
Sim. Nunca é negativa, só vale 0 para palavras iguais, é a mesma nos dois sentidos, e passar por uma terceira palavra nunca a pode encurtar: d(a, c) ≤ d(a, b) + d(b, c). Isso torna-a útil para procurar correspondências próximas.
O que é a distância de Damerau–Levenshtein?
É a distância de edição com uma operação a mais: trocar duas letras vizinhas. Frederick Damerau verificou em 1964 que a inserção, a eliminação, a substituição e a troca, em conjunto, cobrem mais de 80% dos erros ortográficos. Com trocas, recieve e receive estão à distância 1 em vez de 2.
É possível calcular a distância de edição mais depressa do que O(m·n)?
Não muito. Em 2015, Arturs Backurs e Piotr Indyk mostraram que um método com tempo O(n^(2 − ε)) para algum ε > 0 refutaria a hipótese do tempo exponencial forte, na qual a maioria dos investigadores acredita. Para palavras próximas, porém, basta uma faixa estreita em torno da diagonal da tabela.
Como se usa a distância de edição na comparação de ADN?
Os biólogos usam a mesma tabela com pontuações em vez de contagens: as correspondências ganham pontos, e as substituições e as lacunas custam pontos que dependem das letras. É o algoritmo de Needleman–Wunsch, de 1970, para sequências inteiras, e o algoritmo de Smith–Waterman, de 1981, para os troços que melhor correspondem.
Ferramentas relacionadas
Distância de edição (distância de Levenshtein)
Calcule a distância de edição entre duas palavras e veja a tabela de Levenshtein a encher-se passo a passo. Veja cada célula escolher entre inserir, eliminar e substituir, e leia as operações de trás para a frente a partir do canto.
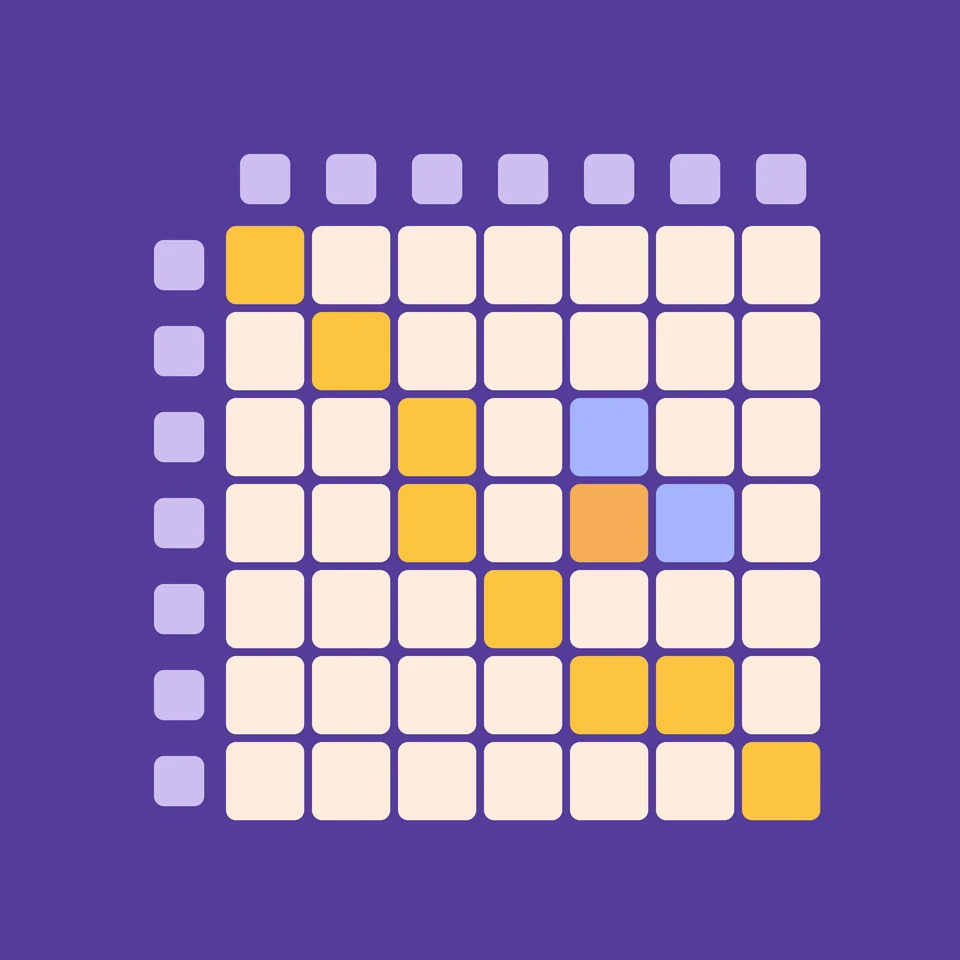
Subsequência comum mais longa (LCS)
Veja passo a passo como se encontra a subsequência comum mais longa de duas palavras. Veja cada célula comparar duas letras e preencher-se a partir das vizinhas, e as letras comuns serem reconstruídas a partir do canto.
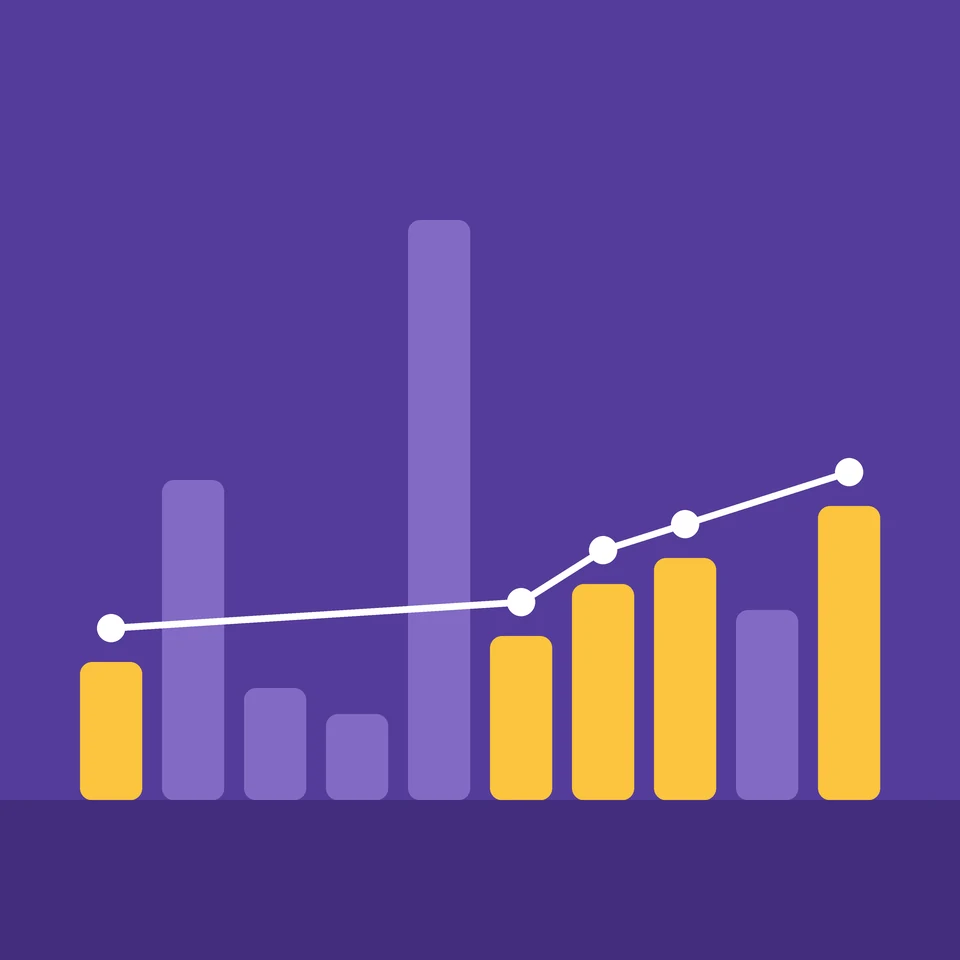
Subsequência crescente mais longa (LIS)
Veja passo a passo como se encontra a subsequência crescente mais longa de uma lista. Cada valor é comparado com os anteriores, vê-se o comprimento da melhor cadeia que termina em cada posição e a resposta é lida de trás para a frente.
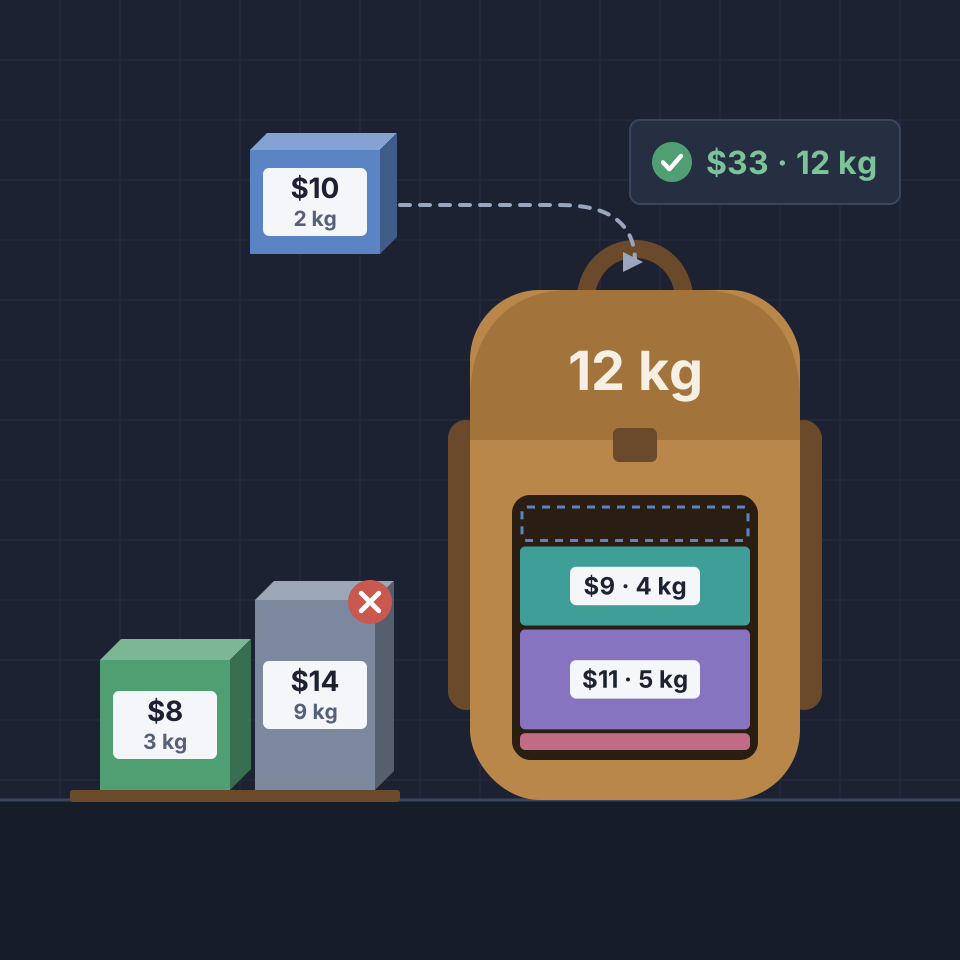
Problema da mochila
Coloque itens numa mochila por quilos e dólares, encontre a mochila mais valiosa e veja a programação dinâmica resolver o problema da mochila 0/1 passo a passo numa tabela.
Fibonacci com programação dinâmica
Veja os números de Fibonacci preencherem uma tabela, uma adição de cada vez. Compare a tabulação ascendente com a memoização descendente, observe a pilha de chamadas e conte as chamadas que a recursão simples faria.
Pronto para experimentar?
Abra o PictorX no seu navegador – sem instalação, sem necessidade de cartão de crédito para começar.
Experimentar a distância de edição