
Bewerkingsafstand (Levenshteinafstand)
Typ recieve en je telefoon stelt receive voor. Hij weet dat je dichtbij zat, omdat de twee woorden maar een paar bewerkingen van elkaar verschillen. Die nabijheid meten, de bewerkingsafstand, is een klassieke taak voor dynamisch programmeren.
Het probleem
Een bewerking verandert een woord met één letter: een letter invoegen, een letter verwijderen of een letter door een andere vervangen. De bewerkingsafstand tussen twee woorden is het kleinste aantal bewerkingen dat het ene in het andere verandert. Tussen cat en cut is de afstand 1, tussen cat en cast ook 1, en tussen cat en act 2. Hij heet ook de Levenshteinafstand, naar de Sovjet-wiskundige Vladimir Levenshtein, die hem in 1965 bestudeerde.
De tabel
Laat d[i][j] de bewerkingsafstand zijn tussen de eerste i letters van het ene woord en de eerste j letters van het andere. Een woord in niets veranderen kost één verwijdering per letter, dus d[i][0] = i, en een woord uit het niets opbouwen kost één invoeging per letter, dus d[0][j] = j. Als letter i gelijk is aan letter j, is d[i][j] = d[i − 1][j − 1]. Anders is d[i][j] = 1 + de kleinste van d[i − 1][j − 1] (vervangen), d[i − 1][j] (verwijderen) en d[i][j − 1] (invoegen).
Een voorbeeld
Voor kitten en sitting heeft de tabel 7 rijen en 8 kolommen. De cel rechtsonder is 3, en teruglezen vanaf daar geeft: vervang k door s, behoud i, t en t, vervang e door i, behoud n en voeg g in. Van kitten naar sitten, dan sittin, dan sitting: drie bewerkingen, en de tabel bewijst dat er geen kortere lijst bestaat.
De bewerkingen teruglezen
Begin bij de cel rechtsonder en vraag je af van welke buur de waarde kwam. Als de letters gelijk zijn en de cel gelijk is aan zijn buur linksboven, is de letter behouden: stap schuin. Is hij één meer dan de buur linksboven, dan was het een vervanging; één meer dan de cel erboven, een verwijdering; één meer dan de cel links, een invoeging. Meerdere paden kunnen gelijk eindigen, en elk geeft een kortste lijst van bewerkingen.
Geschiedenis en toepassingen
Levenshtein introduceerde de afstand in 1965, toen hij werkte aan foutcorrigerende codes. De tabelmethode werd door verschillende mensen gepubliceerd, het bekendst door Robert Wagner en Michael Fischer in 1974, en heet daarom vaak het Wagner–Fischer-algoritme. Tegenwoordig rangschikken bewerkingsafstanden spellingsuggesties, vinden ze namen met typefouten in databases, vergelijken ze DNA- en eiwitsequenties en beoordelen ze spraakherkenning.
Ontdek het zelf
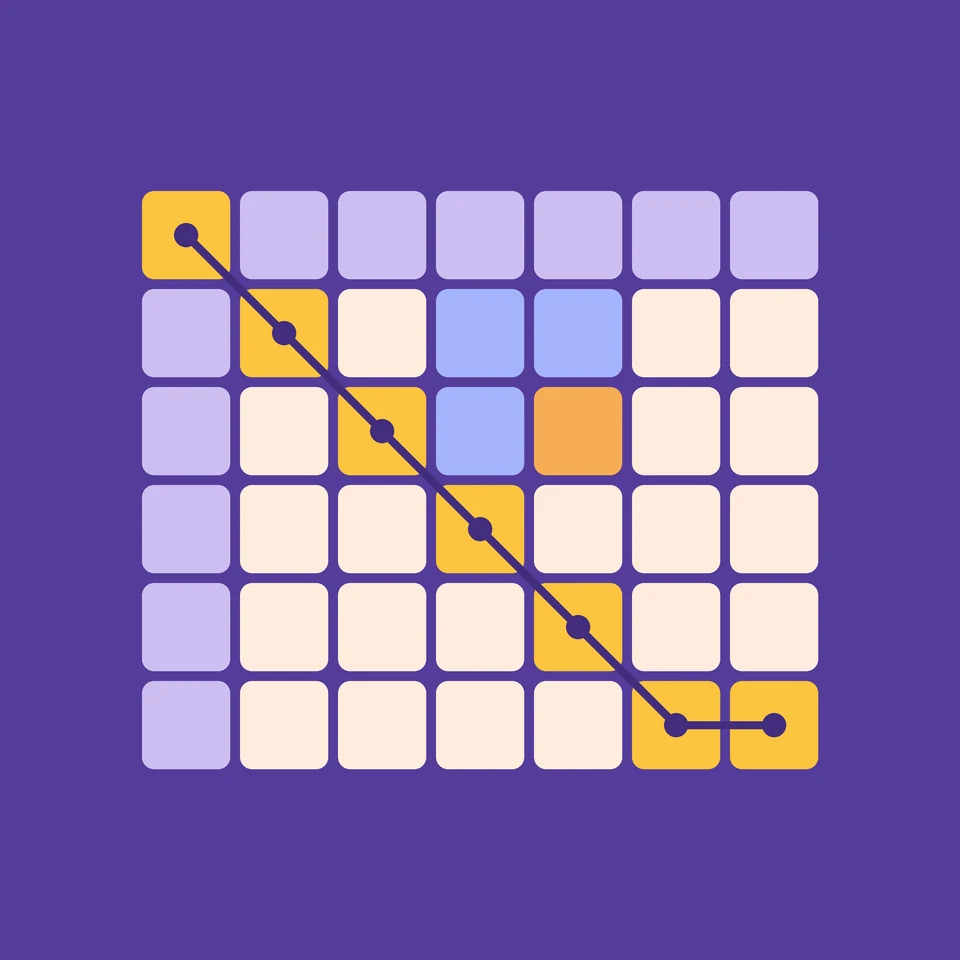
Open de app en druk op Stap. De twee letters die worden vergeleken lichten op in de koppen; bij gelijke letters wordt de blauwe cel linksboven overgenomen, en bij verschillende letters worden alle drie de blauwe buren gelezen en komt er één bij de kleinste. Aan het eind loopt het oranje pad terug vanuit de hoek, en verschijnen de bewerkingen onder de tabel.
Veelgestelde vragen
Is de bewerkingsafstand een metriek?
Ja. Hij is nooit negatief, hij is alleen 0 voor gelijke woorden, hij is in beide richtingen gelijk, en een omweg via een derde woord kan hem nooit korter maken: d(a, c) ≤ d(a, b) + d(b, c). Daardoor is hij handig om naar woorden te zoeken die er dicht bij liggen.
Wat is de Damerau–Levenshteinafstand?
De bewerkingsafstand met één extra bewerking: het verwisselen van twee naburige letters. Frederick Damerau ontdekte in 1964 dat invoegen, verwijderen, vervangen en verwisselen samen meer dan 80% van de spelfouten dekken. Met verwisselingen liggen recieve en receive 1 uit elkaar in plaats van 2.
Kan de bewerkingsafstand sneller dan in O(m·n) worden berekend?
Niet veel sneller. In 2015 lieten Arturs Backurs en Piotr Indyk zien dat een methode met O(n^(2 − ε)) tijd voor een of andere ε > 0 de sterke exponentiële-tijdhypothese zou weerleggen, die de meeste onderzoekers voor waar houden. Voor woorden die dicht bij elkaar liggen, is wel maar een smalle strook rond de diagonaal van de tabel nodig.
Hoe wordt de bewerkingsafstand gebruikt om DNA te vergelijken?
Biologen gebruiken dezelfde tabel met scores in plaats van aantallen: overeenkomsten leveren punten op, en vervangingen en gaten kosten punten die van de letters afhangen. Dat is het Needleman–Wunsch-algoritme uit 1970 voor hele sequenties, en het Smith–Waterman-algoritme uit 1981 voor de best overeenkomende stukken.
Gerelateerde gereedschappen
Bewerkingsafstand (Levenshteinafstand)
Bereken de bewerkingsafstand tussen twee woorden en zie de Levenshteintabel stap voor stap vollopen. Zie hoe elke cel kiest tussen invoegen, verwijderen en vervangen, en lees de bewerkingen terug vanuit de hoek.
Langste gemeenschappelijke deelrij (LCS)
Zie stap voor stap hoe de langste gemeenschappelijke deelrij van twee woorden gevonden wordt. Zie hoe elke cel twee letters vergelijkt en zich vult vanuit zijn buren, en hoe de gedeelde letters vanuit de hoek worden teruggevolgd.
Langste stijgende deelrij (LIS)
Bekijk stap voor stap hoe de langste stijgende deelrij van een rij gevonden wordt. Zie elke waarde vergeleken met de waarden ervoor, de lengte van de beste reeks die op elke positie eindigt, en het teruggelezen antwoord.
Knapzakprobleem
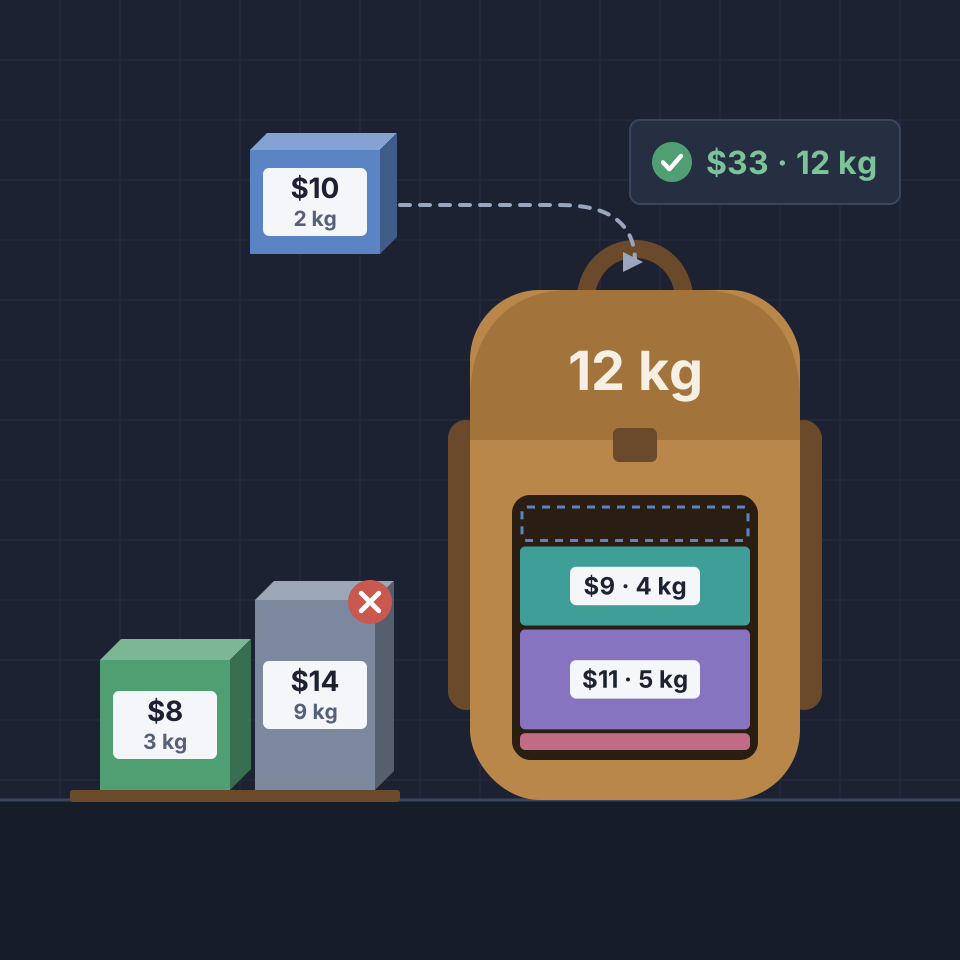
Stop voorwerpen in een rugzak op kilo's en dollars, vind de waardevolste rugzak en zie hoe dynamisch programmeren het 0/1-knapzakprobleem stap voor stap in een tabel oplost.
Fibonacci met dynamisch programmeren
Zie Fibonacci-getallen een tabel vullen, één optelling tegelijk. Vergelijk bottom-up tabulatie met top-down memoïsatie, bekijk de aanroepstapel en tel de aanroepen die gewone recursie zou doen.
Klaar om het te proberen?
Open PictorX in je browser - geen installatie, geen creditcard nodig om te starten.
Probeer de bewerkingsafstand