
Distancia de edición (distancia de Levenshtein)
Escribe recieve y tu teléfono te sugiere receive. Sabe que estabas cerca porque las dos palabras están a solo un par de operaciones. Medir esa cercanía, la distancia de edición, es un problema clásico de programación dinámica.
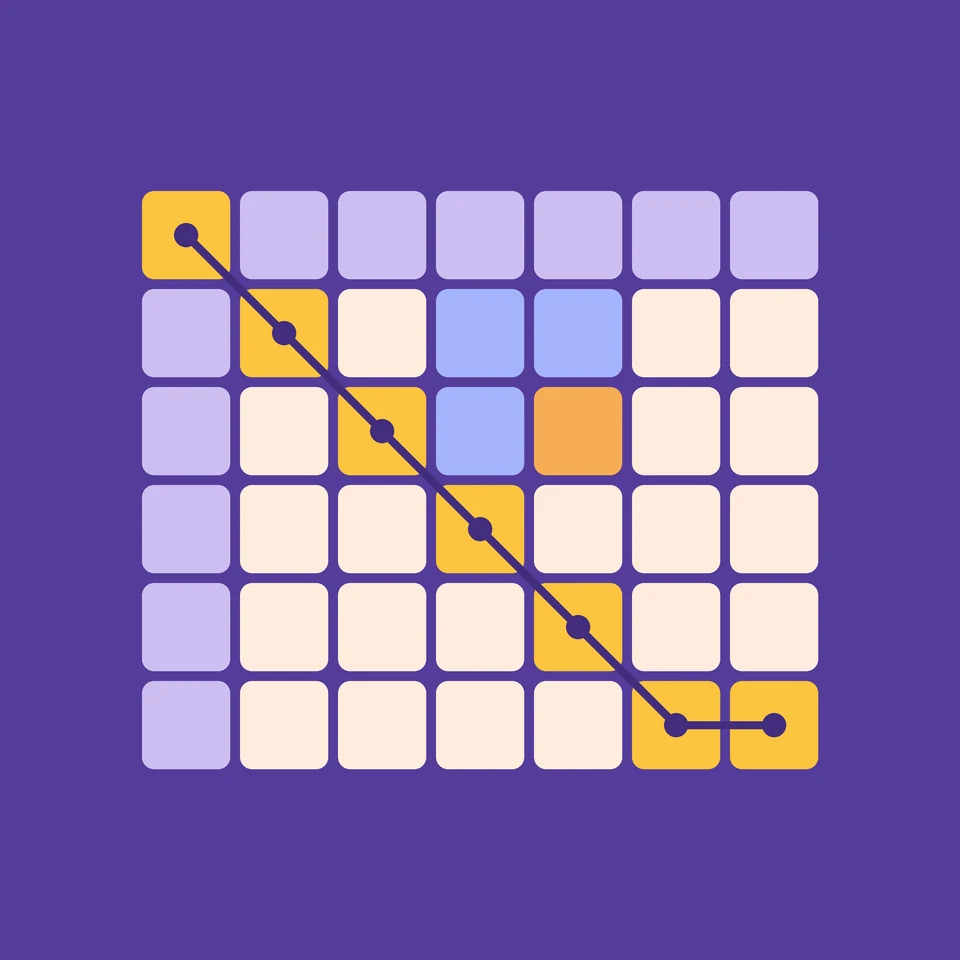
El problema
Una operación cambia una palabra en una letra: insertar una letra, borrar una letra o sustituir una letra por otra. La distancia de edición entre dos palabras es el menor número de operaciones que convierten una en la otra. Entre cat y cut hay distancia 1, entre cat y cast también 1, y entre cat y act 2. También se llama distancia de Levenshtein, por el matemático soviético Vladimir Levenshtein, que la estudió en 1965.
La tabla
Sea d[i][j] la distancia de edición entre las primeras i letras de una palabra y las primeras j letras de la otra. Convertir una palabra en nada cuesta un borrado por letra, así que d[i][0] = i, y construir una palabra desde cero cuesta una inserción por letra, así que d[0][j] = j. Si la letra i es igual a la letra j, d[i][j] = d[i − 1][j − 1]. Si no, d[i][j] = 1 + el menor de d[i − 1][j − 1] (sustitución), d[i − 1][j] (borrado) y d[i][j − 1] (inserción).
Un ejemplo
Para kitten y sitting, la tabla tiene 7 filas y 8 columnas. La celda inferior derecha vale 3, y leyendo hacia atrás desde ella se obtiene: sustituir k por s, conservar i, t y t, sustituir e por i, conservar n e insertar g. De kitten a sitten, luego sittin y luego sitting: tres operaciones, y la tabla demuestra que no existe una lista más corta.
Leer las operaciones hacia atrás
Empieza en la celda inferior derecha y pregúntate de qué vecino viene su valor. Si las letras coinciden y la celda es igual a su vecina de arriba a la izquierda, la letra se conservó: avanza en diagonal. Si vale uno más que la vecina de arriba a la izquierda, fue una sustitución; uno más que la celda de arriba, un borrado; uno más que la celda de la izquierda, una inserción. Varios caminos pueden empatar, y cada uno da una lista de operaciones lo más corta posible.
Historia y usos
Levenshtein presentó la distancia en 1965 mientras trabajaba en códigos correctores de errores. El método de la tabla lo publicaron varias personas, sobre todo Robert Wagner y Michael Fischer en 1974, por eso se suele llamar algoritmo de Wagner–Fischer. Hoy las distancias de edición ordenan sugerencias ortográficas, encuentran nombres con erratas en bases de datos, comparan secuencias de ADN y de proteínas y puntúan el reconocimiento de voz.
Explóralo
Abre la aplicación y pulsa Paso. Las dos letras que se comparan se iluminan en los encabezados; si son iguales, se copia la celda azul de arriba a la izquierda, y si son distintas, se leen los tres vecinos azules y se suma uno al menor. Al final, el camino naranja vuelve desde la esquina y las operaciones aparecen bajo la tabla.
Preguntas frecuentes
¿Es la distancia de edición una métrica?
Sí. Nunca es negativa, solo vale 0 para palabras iguales, es la misma en ambos sentidos, y pasar por una tercera palabra nunca puede acortarla: d(a, c) ≤ d(a, b) + d(b, c). Eso la hace útil para buscar coincidencias cercanas.
¿Qué es la distancia de Damerau–Levenshtein?
Es la distancia de edición con una operación más: intercambiar dos letras vecinas. Frederick Damerau observó en 1964 que la inserción, el borrado, la sustitución y el intercambio juntos cubren más del 80 % de los errores ortográficos. Con intercambios, recieve y receive están a distancia 1 en lugar de 2.
¿Se puede calcular la distancia de edición más rápido que en O(m·n)?
No mucho más. En 2015, Arturs Backurs y Piotr Indyk demostraron que un método que tardara O(n^(2 − ε)) para algún ε > 0 refutaría la hipótesis del tiempo exponencial fuerte, que la mayoría de los investigadores considera cierta. Sin embargo, para palabras parecidas basta con una franja estrecha alrededor de la diagonal de la tabla.
¿Cómo se usa la distancia de edición para comparar ADN?
Los biólogos usan la misma tabla con puntuaciones en lugar de recuentos: las coincidencias suman puntos, y las sustituciones y los huecos restan puntos que dependen de las letras. Es el algoritmo de Needleman–Wunsch de 1970 para secuencias completas y el algoritmo de Smith–Waterman de 1981 para los fragmentos que mejor coinciden.
Herramientas relacionadas
Distancia de edición (distancia de Levenshtein)
Calcula la distancia de edición entre dos palabras y mira cómo se llena la tabla de Levenshtein paso a paso. Observa cómo cada celda elige entre insertar, borrar y sustituir, y lee las operaciones hacia atrás desde la esquina.
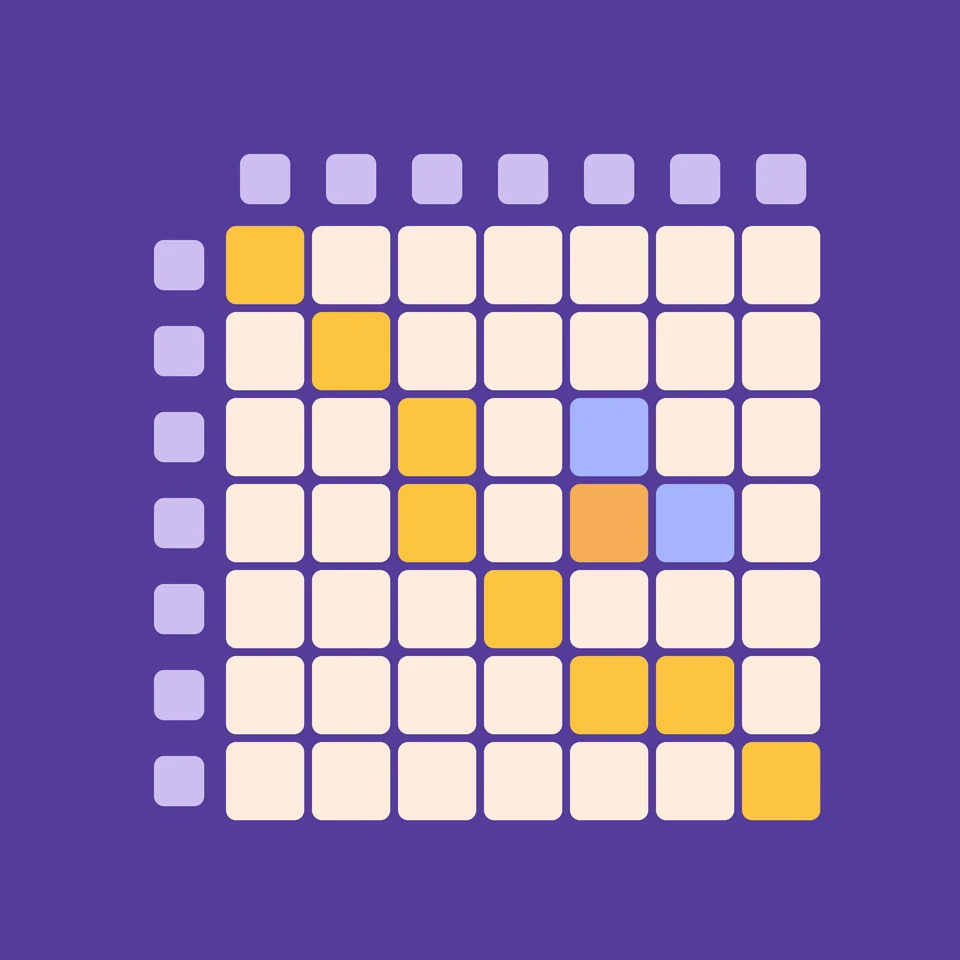
Subsecuencia común más larga (LCS)
Mira paso a paso cómo se encuentra la subsecuencia común más larga de dos palabras. Observa cómo cada celda compara dos letras y se rellena a partir de sus vecinas, y cómo se reconstruyen las letras comunes desde la esquina.
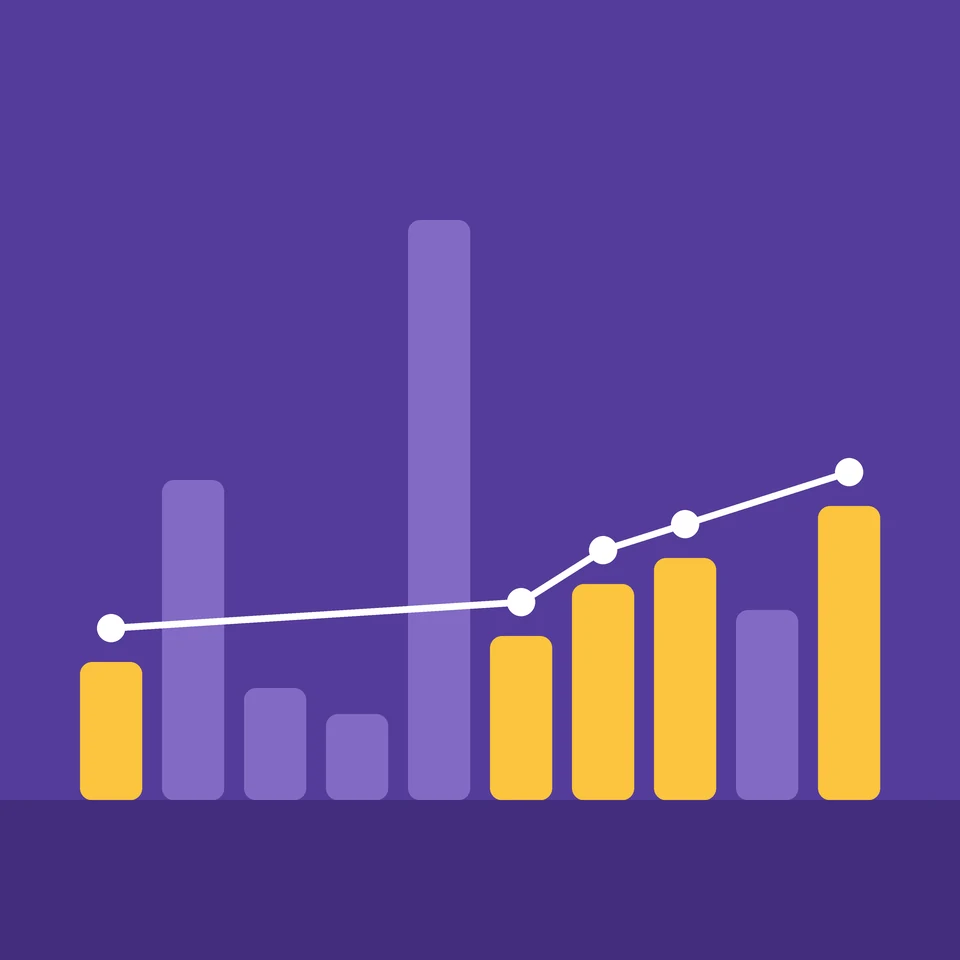
Subsecuencia creciente más larga (LIS)
Mira paso a paso cómo se encuentra la subsecuencia creciente más larga de una lista. Ve cada valor comparado con los anteriores, la longitud de la mejor cadena que termina en cada posición y la respuesta leída hacia atrás.
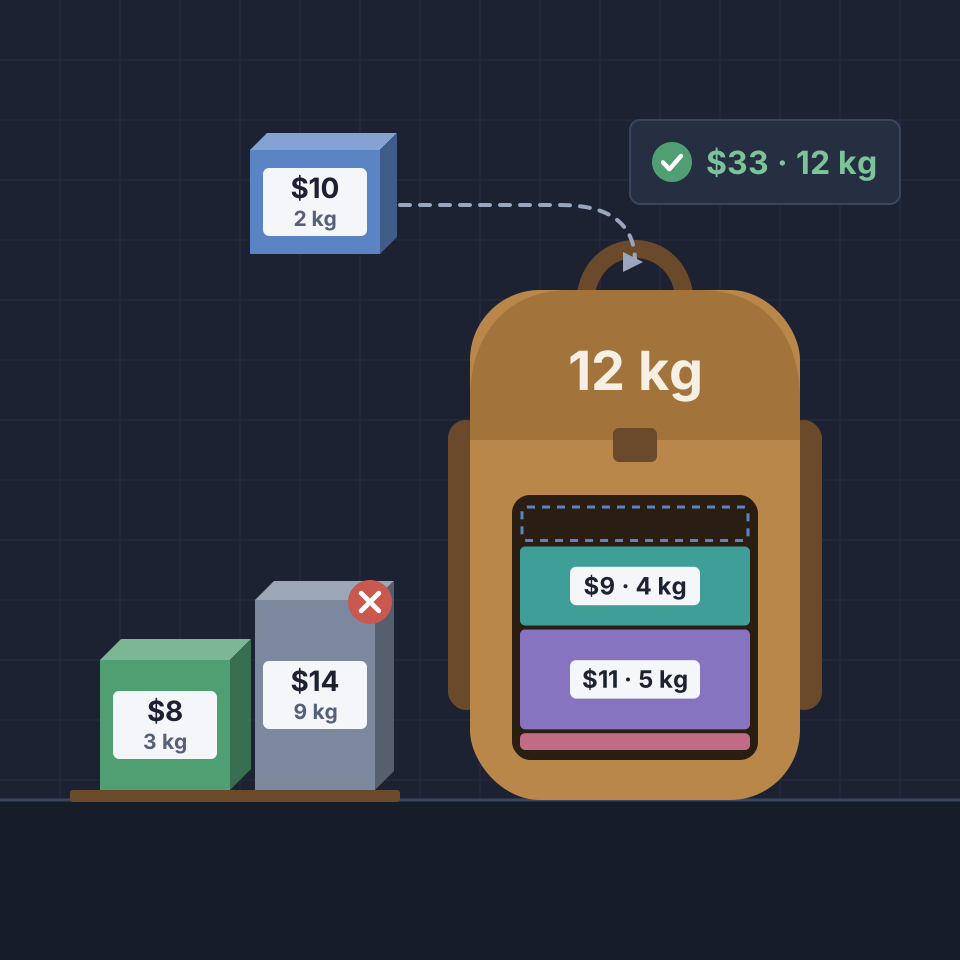
Problema de la mochila
Mete objetos en una mochila según sus kilos y sus dólares, encuentra la mochila más valiosa y mira cómo la programación dinámica resuelve el problema de la mochila 0/1 paso a paso en una tabla.
Fibonacci con programación dinámica
Mira cómo los números de Fibonacci llenan una tabla, una suma cada vez. Compara la tabulación ascendente con la memoización descendente, observa la pila de llamadas y cuenta las llamadas que haría la recursión simple.
¿Listo para probarlo?
Abre PictorX en tu navegador: sin instalación ni tarjeta de crédito para empezar.
Prueba la distancia de edición