
Sortowanie przez scalanie
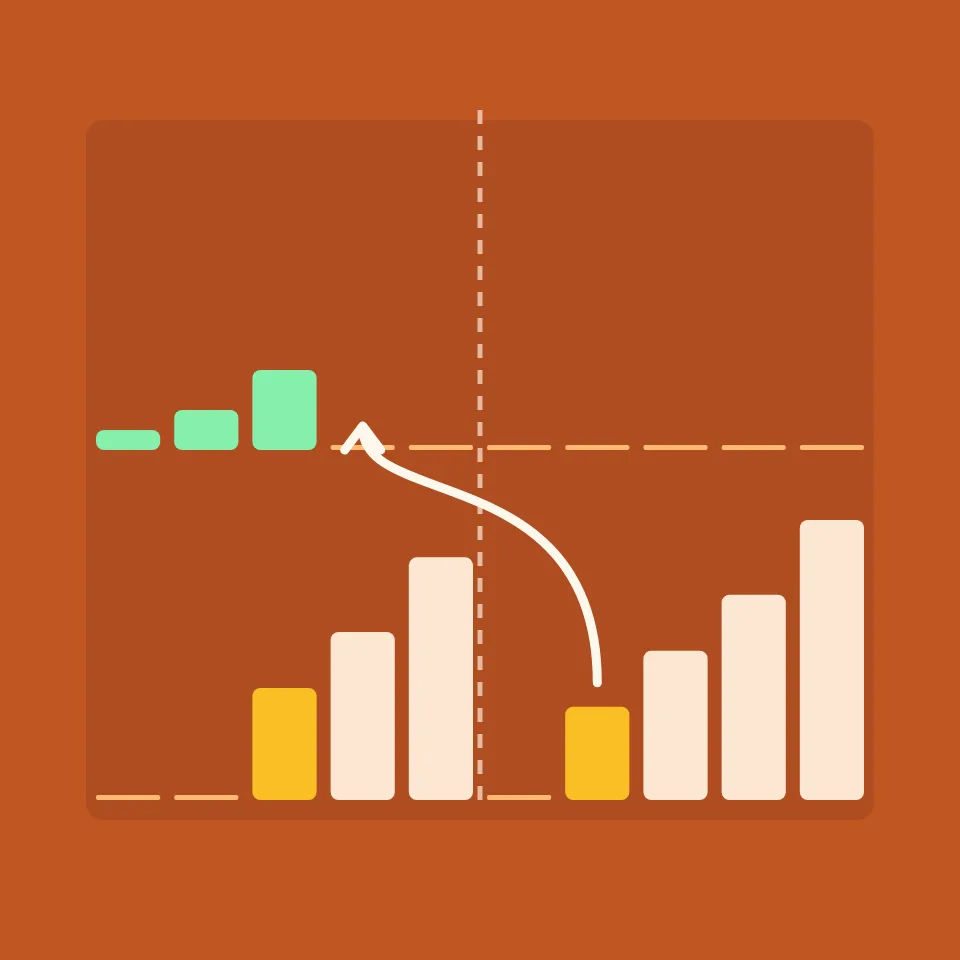
Sortowanie przez scalanie zamienia jeden trudny problem w wiele łatwych: dwie posortowane listy łatwo połączyć w jedną. Dziel listę na pół, aż każdy kawałek będzie pojedynczą wartością, a potem scal kawałki z powrotem. To klasyczny algorytm typu „dziel i zwyciężaj”, a jego czas to n log n niezależnie od danych.
Idea
Scalanie to łatwa część. Mając dwie listy, z których każda jest posortowana, porównaj ich pierwsze wartości i weź mniejszą. Porównaj nowe pierwsze wartości i znów weź mniejszą. Gdy jedna lista się skończy, dopisz resztę drugiej. Każdy krok zabiera jedną wartość, więc scalenie dwóch list o łącznej długości m wymaga najwyżej m − 1 porównań. Sortowanie przez scalanie wykorzystuje to do sortowania: podziel listę na pół, posortuj każdą połowę sortowaniem przez scalanie i scal obie połowy.
Przykład
Weźmy 5, 1, 4, 2, 8. Dzielimy na 5, 1 oraz 4, 2, 8. Pierwsza połowa dzieli się na 5 i 1, które scalają się w 1, 5. Druga połowa dzieli się na 4 oraz 2, 8; 2, 8 powstaje ze scalenia 2 i 8, a potem jest scalane z 4 w 2, 4, 8. Na koniec scalamy 1, 5 oraz 2, 4, 8: 1, potem 2, potem 4, potem 5, a 8 zostaje. To 8 porównań, 12 zapisów i 4 scalenia.
Dlaczego n log n
Każdy podział połowi kawałki, więc po około log₂ n poziomach każdy kawałek jest pojedynczą wartością. W drodze powrotnej każdy poziom scaleń obsługuje każdą wartość raz, czyli n zapisów i mniej niż n porównań na poziom. Łącznie daje to około n log₂ n. Dla 40 wartości sortowanie wykonuje 216 zapisów i najwyżej 177 porównań; sortowanie bąbelkowe może dla tej samej listy potrzebować 780 porównań. Kolejność danych ma znacznie mniejsze znaczenie niż w tamtych algorytmach: dla 40 wartości lista posortowana wymaga 100 porównań, odwrócona 116, a losowa około 160.
Bufor i stabilność
Aby scalić dwie połowy leżące obok siebie w liście, zwykła metoda kopiuje je do bufora i zapisuje z powrotem w kolejności. Aplikacja pokazuje ten bufor jako drugi rząd słupków. Wymaga on tyle dodatkowej pamięci, ile zajmuje lista, i to główny koszt sortowania przez scalanie. W zamian sortowanie jest stabilne: gdy dwie pierwsze wartości są równe, najpierw idzie ta z lewej połowy, więc równe wartości zachowują kolejność. Stabilność ma znaczenie, gdy sortuje się rekordy po kolejnych polach.
Historia i zastosowania
John von Neumann opisał sortowanie przez scalanie w 1945 roku, co czyni je jednym z pierwszych algorytmów napisanych dla komputera z programem w pamięci. Ponieważ czyta i zapisuje dane długimi seriami, było standardową metodą sortowania danych na taśmach i nadal służy do sortowania plików zbyt dużych, by zmieściły się w pamięci. Timsort, używany w języku Python oraz w języku Java dla obiektów, to sortowanie przez scalanie, które najpierw wyszukuje już posortowane serie, a krótkie kawałki sortuje przez wstawianie.
Wypróbuj
Otwórz aplikację i naciśnij Krok. Zacieniona część listy jest właśnie dzielona lub scalana, a przerywana linia oznacza środek. Gdy zaczyna się scalanie, obie połowy opadają do rzędu bufora; dwie pierwsze wartości są porównywane, a mniejsza wraca w górę. Obserwuj liczniki: zapisów jest tyle samo dla każdej listy tej samej długości, a porównań jest najmniej dla listy posortowanej lub odwróconej i najwięcej dla losowej, ale nigdy więcej niż około n log₂ n.
Często zadawane pytania
Jaka jest złożoność czasowa sortowania przez scalanie?
O(n log n) w przypadku optymistycznym, średnim i pesymistycznym. Zwykła wersja potrzebuje O(n) dodatkowej pamięci na bufor.
Czym różni się sortowanie przez scalanie od sortowania szybkiego (quicksort)?
Oba dzielą listę i sortują części. Sortowanie przez scalanie dzieli w środku, nie patrząc na wartości, a pracę wykonuje przy scalaniu; quicksort pracuje przy dzieleniu, przesuwając wartości wokół elementu osiowego, i nie potrzebuje scalania. Quicksort sortuje w miejscu i w praktyce często jest szybszy, ale przy złych danych może zwolnić do n² i nie jest stabilny. Sortowanie przez scalanie jest zawsze n log n i stabilne.
Czym jest wstępujące sortowanie przez scalanie (bottom-up)?
To wersja bez rekurencji: najpierw scal sąsiednie pojedyncze wartości w pary, potem pary w czwórki i tak dalej, w każdej rundzie podwajając długość. Wykonuje tę samą pracę co pokazana tu wersja zstępująca (top-down).
Czy sortowanie przez scalanie jest stabilne?
Tak, o ile przy remisie najpierw brana jest wartość z lewej połowy, tak jak w tej aplikacji.
Powiązane narzędzia
Sortowanie przez scalanie
Obejrzyj sortowanie przez scalanie krok po kroku. Zobacz, jak lista dzieli się na pół, a posortowane połowy są z powrotem scalane, ustaw prędkość i licz porównania, zapisy i scalenia.
Sortowanie przez wstawianie
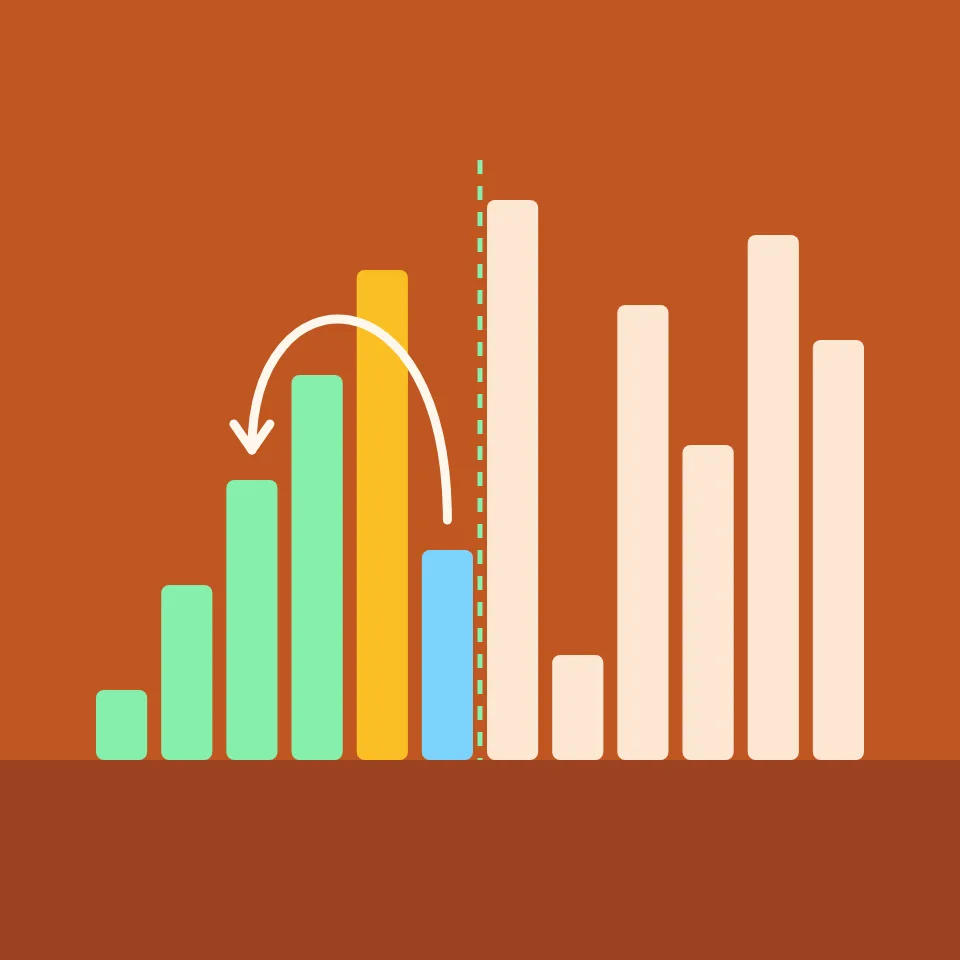
Zobacz sortowanie przez wstawianie krok po kroku. Obserwuj, jak każda wartość wsuwa się wstecz do posortowanej części, ustaw prędkość i licz porównania, zamiany i przebiegi.
Sortowanie przez wybieranie
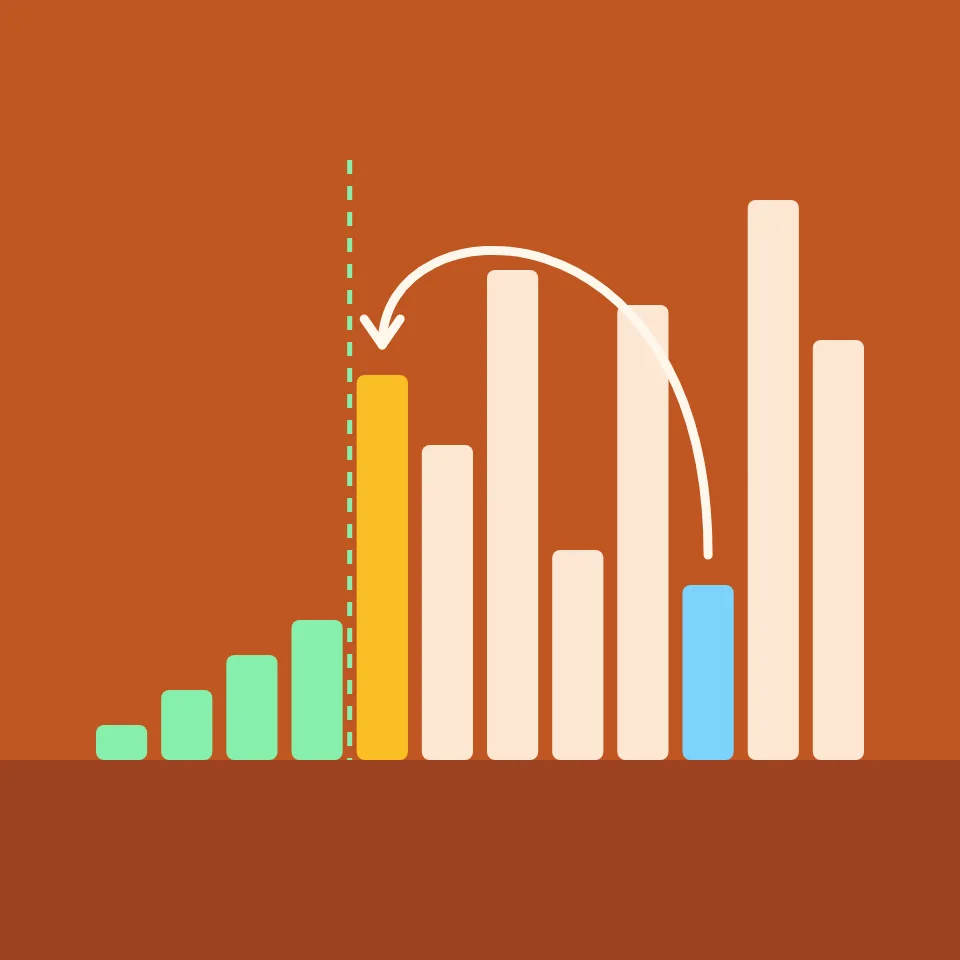
Obejrzyj sortowanie przez wybieranie krok po kroku. Zobacz, jak każdy przebieg znajduje najmniejszą wartość i przenosi ją na właściwe miejsce, ustaw prędkość i licz porównania, zamiany i przebiegi.
Sortowanie bąbelkowe
Zobacz sortowanie bąbelkowe krok po kroku. Odtwarzaj, wstrzymuj lub przechodź przez każde porównanie i zamianę, ustaw prędkość i licz porównania, zamiany i przebiegi.
Sortowanie szybkie
Obejrzyj sortowanie szybkie (quicksort) krok po kroku. Wybierz regułę pivota, zobacz, jak każdy podział przenosi mniejsze wartości przed pivot, i licz porównania, zamiany i podziały.

Sortowanie przez kopcowanie
Zobacz sortowanie przez kopcowanie krok po kroku. Lista staje się kopcem typu max, narysowanym jako drzewo, a potem największa wartość jest po kolei zdejmowana ze szczytu. Licz porównania i zamiany.
Chcesz wypróbować?
Otwórz PictorX w swojej przeglądarce — do uruchomienia nie jest wymagana żadna instalacja ani karta kredytowa.
Wypróbuj sortowanie przez scalanie