
Ordenamiento por mezcla
El ordenamiento por mezcla convierte un problema difícil en muchos fáciles: dos listas ordenadas se combinan fácilmente en una. Divide la lista por la mitad hasta que cada trozo sea un solo valor y luego vuelve a mezclar los trozos. Es el algoritmo clásico de divide y vencerás, y su tiempo es n log n sea cual sea la entrada.
La idea
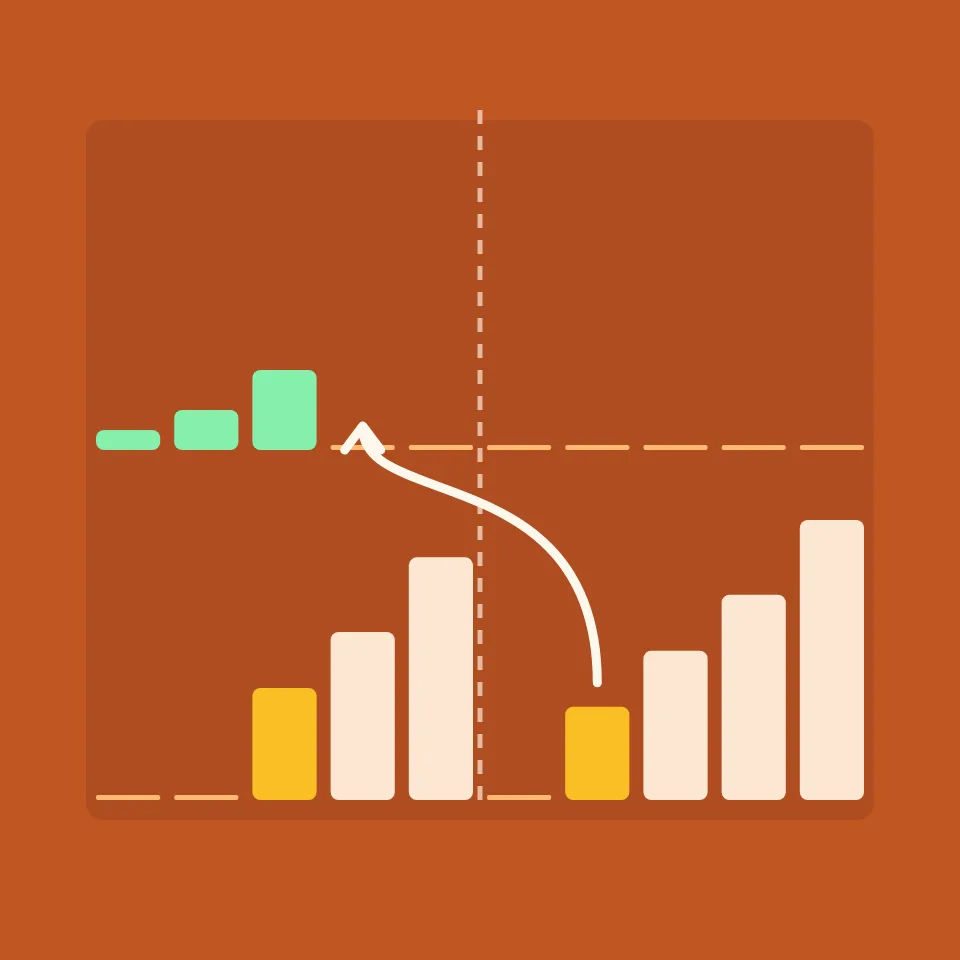
Mezclar es la parte fácil. Dadas dos listas ya ordenadas, compara sus primeros valores y toma el menor. Compara los nuevos primeros valores y vuelve a tomar el menor. Cuando una lista se acaba, añade el resto de la otra. Cada paso toma un valor, así que mezclar dos listas de longitud total m requiere como mucho m − 1 comparaciones. El ordenamiento por mezcla lo aprovecha para ordenar: divide la lista por la mitad, ordena cada mitad con el ordenamiento por mezcla y mezcla las dos mitades.
Un ejemplo
Toma 5, 1, 4, 2, 8. Divídela en 5, 1 y 4, 2, 8. La primera mitad se divide en 5 y 1, que se mezclan en 1, 5. La segunda mitad se divide en 4 y 2, 8; el 2, 8 se obtiene mezclando 2 y 8, y luego se mezcla con 4 en 2, 4, 8. Por último se mezclan 1, 5 y 2, 4, 8: 1, luego 2, luego 4, luego 5, y sobra el 8. Son 8 comparaciones, 12 escrituras y 4 mezclas.
Por qué n log n
Cada división parte los trozos por la mitad, así que tras unos log₂ n niveles cada trozo es un solo valor. En el camino de vuelta, cada nivel de mezclas trata cada valor una vez: n escrituras y menos de n comparaciones por nivel. En total son unas n log₂ n. Para 40 valores, la ordenación hace 216 escrituras y como mucho 177 comparaciones; el ordenamiento de burbuja puede necesitar 780 comparaciones para la misma lista. El orden de la entrada importa mucho menos que en esos algoritmos: para 40 valores, una lista ordenada necesita 100 comparaciones, una invertida 116 y una aleatoria unas 160.
El búfer y la estabilidad
Para mezclar dos mitades contiguas de la lista, el método habitual las copia en un búfer y las vuelve a escribir en orden. La aplicación muestra ese búfer como la segunda fila de barras. Necesita tanta memoria extra como la lista, y ese es el principal coste del ordenamiento por mezcla. A cambio, la ordenación es estable: cuando los dos primeros valores son iguales, va primero el de la mitad izquierda, así que los valores iguales conservan su orden. La estabilidad importa al ordenar registros por un campo y luego por otro.
Historia y uso
John von Neumann describió el ordenamiento por mezcla en 1945, lo que lo convierte en uno de los primeros algoritmos escritos para un ordenador de programa almacenado. Como lee y escribe los datos en tramos largos, fue el método estándar para ordenar datos en cinta y aún se usa para archivos demasiado grandes para la memoria. Timsort, que usan Python y Java para objetos, es un ordenamiento por mezcla que primero busca tramos ya ordenados y usa el ordenamiento por inserción para los trozos cortos.
Explóralo
Abre la aplicación y pulsa Paso. La parte sombreada de la lista es la que se divide o se mezcla, y la línea discontinua marca el centro. Cuando empieza una mezcla, las dos mitades bajan a la fila del búfer; se comparan los dos primeros valores y el menor vuelve a subir. Observa los contadores: las escrituras son las mismas para toda lista de la misma longitud, y las comparaciones son mínimas con una lista ordenada o invertida y máximas con una aleatoria, pero nunca más de unas n log₂ n.
Preguntas frecuentes
¿Cuál es la complejidad temporal del ordenamiento por mezcla?
O(n log n) en el mejor caso, el caso medio y el peor caso. La versión habitual necesita O(n) de memoria extra para el búfer.
¿Qué diferencia hay entre el ordenamiento por mezcla y quicksort?
Los dos dividen la lista y ordenan las partes. El ordenamiento por mezcla divide por el centro sin mirar los valores y hace su trabajo al mezclar; quicksort hace su trabajo al dividir, moviendo valores alrededor de un pivote, y no necesita mezcla. Quicksort ordena in situ y suele ser más rápido en la práctica, pero con entradas malas puede llegar a n² y no es estable. El ordenamiento por mezcla siempre es n log n y estable.
¿Qué es el ordenamiento por mezcla ascendente (bottom-up)?
Una versión sin recursión: primero mezcla los valores sueltos vecinos en parejas, luego las parejas en grupos de cuatro, y así sucesivamente, duplicando la longitud en cada ronda. Hace el mismo trabajo que la versión descendente (top-down) que se muestra aquí.
¿Es estable el ordenamiento por mezcla?
Sí, siempre que en un empate se tome primero el valor de la mitad izquierda, como hace esta aplicación.
Herramientas relacionadas
Ordenamiento por mezcla
Mira el ordenamiento por mezcla paso a paso. Ve cómo la lista se divide por la mitad y las mitades ordenadas se vuelven a mezclar, ajusta la velocidad y cuenta comparaciones, escrituras y mezclas.
Ordenamiento por inserción
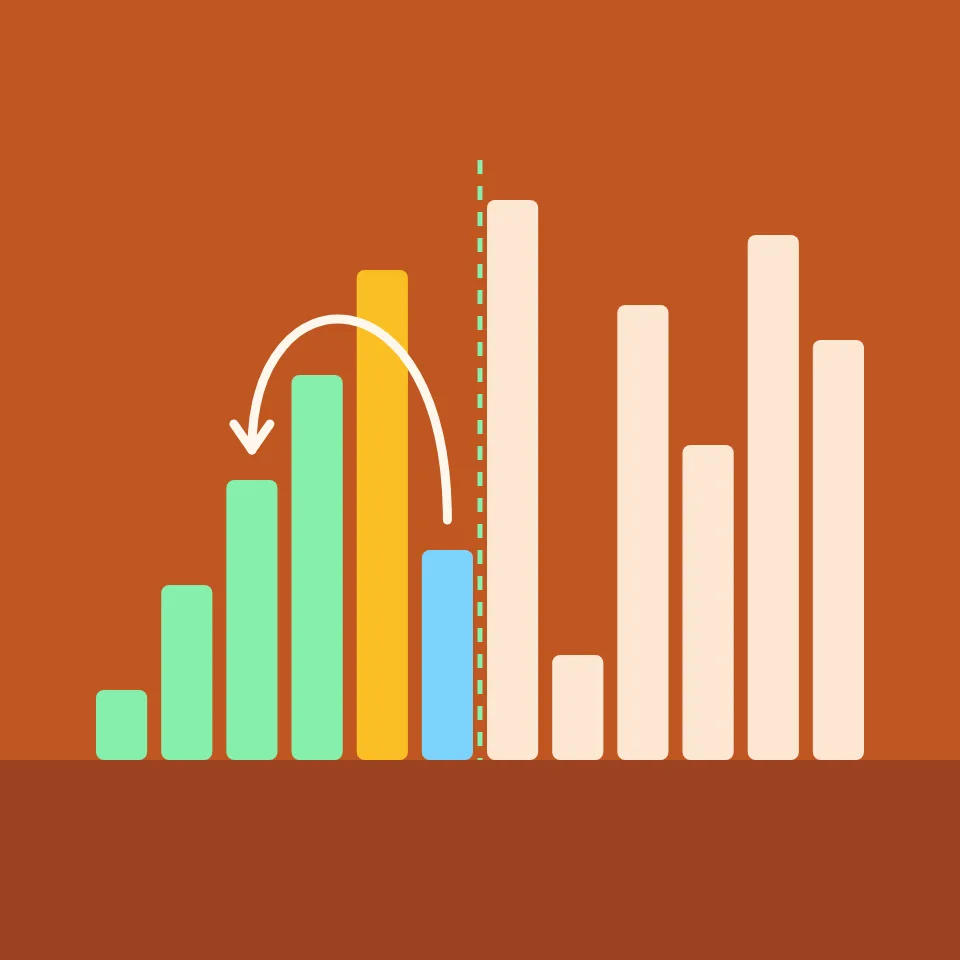
Mira el ordenamiento por inserción paso a paso. Ve cómo cada valor vuelve a la parte ordenada, ajusta la velocidad y cuenta comparaciones, intercambios y pasadas.
Ordenamiento por selección
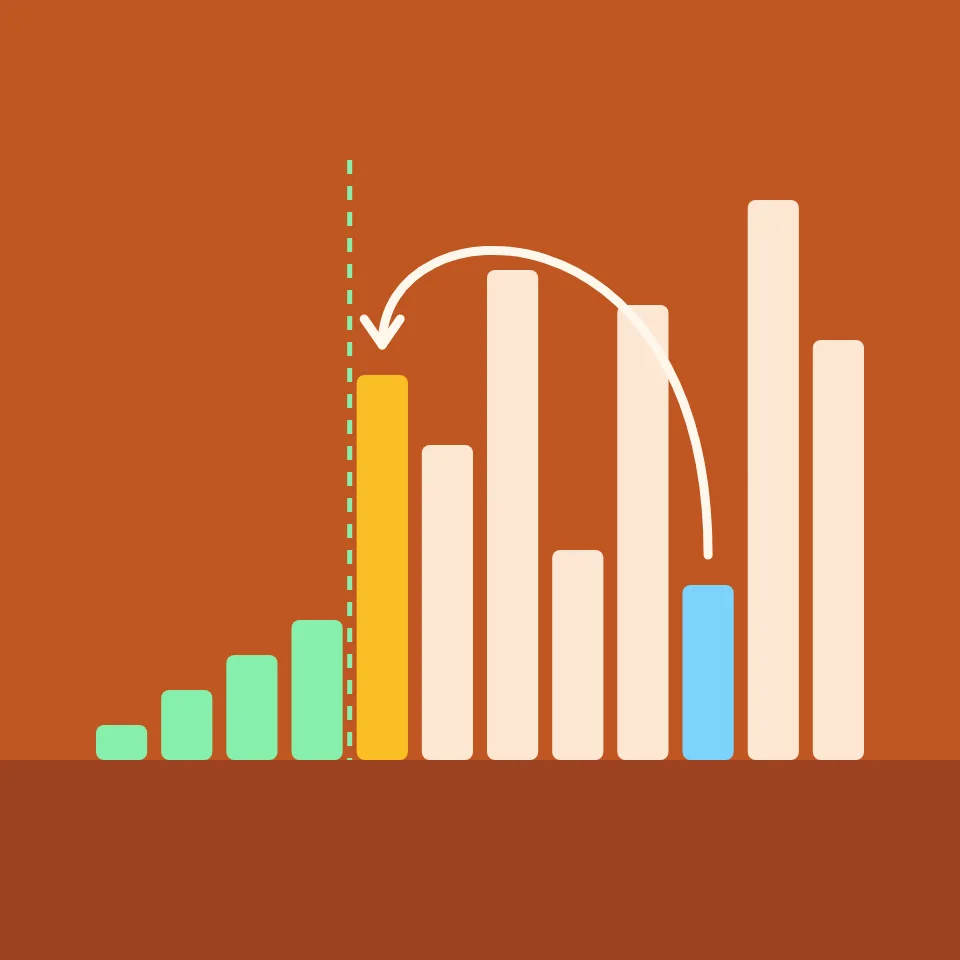
Mira el ordenamiento por selección paso a paso. Cada pasada encuentra el menor valor y lo intercambia a su sitio. Ajusta la velocidad y cuenta comparaciones, intercambios y pasadas.
Ordenamiento de burbuja
Mira el ordenamiento de burbuja paso a paso. Reproduce, pausa o recorre cada comparación e intercambio, ajusta la velocidad y cuenta comparaciones, intercambios y pasadas.
Quicksort
Mira el quicksort paso a paso. Elige la regla del pivote, observa cómo cada partición pone los valores menores antes del pivote y cuenta comparaciones, intercambios y particiones.

Ordenamiento por montículos
Mira el ordenamiento por montículos (heapsort) paso a paso. La lista se convierte en un montículo máximo, dibujado como árbol, y luego se saca el mayor valor de la cima, uno a uno, contando comparaciones e intercambios.
¿Listo para probarlo?
Abre PictorX en tu navegador: sin instalación ni tarjeta de crédito para empezar.
Prueba el ordenamiento por mezcla