
Algorithmes de tri comparés
Il n'y a pas un algorithme de tri plus rapide que tous les autres. Certains sont simples mais lents, d'autres sont rapides sur des données aléatoires mais trébuchent sur des données triées, et certains ne trient même pas par comparaison. Faire courir les huit sur la même liste montre les différences d'un coup d'œil.
Trois familles
Le tri à bulles, par sélection et par insertion sont les tris simples. Ils comparent et échangent des valeurs proches les unes des autres et demandent un temps proportionnel à n² sur une liste aléatoire. Le tri fusion, le quicksort et le tri par tas répartissent le travail astucieusement et demandent un temps proportionnel à n log n, le mieux qu'un tri puisse faire quand il ne peut demander que laquelle de deux valeurs est la plus grande. Le tri par base et le tri par comptage se passent complètement de cette question : ils utilisent les chiffres ou les valeurs eux-mêmes, ce qui ne marche que pour des clés comme de petits entiers.
Mesurer le travail
La Course des tris compte une opération pour chaque comparaison, chaque chiffre ou valeur lu, et chaque échange ou déplacement. Sur 40 valeurs aléatoires, cela donne environ 120 pour le tri par comptage, 240 pour le tri par base, 260 pour le quicksort, 380 pour le tri fusion, 490 pour le tri par tas, environ 820 chacun pour le tri par sélection et le tri par insertion, et plus de 1 100 pour le tri à bulles. Les vrais ordinateurs tiennent aussi compte de la mémoire : en pratique, le quicksort est souvent plus rapide que son compte ne le laisse penser, et le tri par tas plus lent, à cause de leur façon de parcourir la liste.
Les données comptent
Sur une liste presque triée, le tri par insertion ne demande qu'environ 50 opérations pour 40 valeurs et le tri à bulles environ 90, car chaque valeur est près de sa place. Sur une liste inversée, les deux en demandent 1 560, leur pire cas. Le tri par sélection, par tas, fusion, par base et par comptage sont presque insensibles à l'ordre. Le quicksort avec la médiane de trois gère bien les listes triées et inversées, mais avec un pivot naïf, une liste triée est son pire cas. Peu de valeurs distinctes ralentissent le quicksort, car les valeurs égales vont toutes du même côté.
Mémoire et stabilité
Le tri à bulles, par sélection, par insertion, le quicksort et le tri par tas travaillent en place, avec peu ou pas de mémoire en plus. Le tri fusion, par base et par comptage ont besoin d'un tampon aussi long que la liste. Un tri stable garde les valeurs égales dans leur ordre d'origine : le tri à bulles, par insertion, fusion, par base et par comptage sont stables, alors que le tri par sélection, le quicksort et le tri par tas ne le sont pas. La stabilité compte quand vous triez des enregistrements selon un champ, puis un autre.
Lequel utiliser
En pratique, vous utilisez le tri intégré à votre langage de programmation : souvent Timsort, un tri fusion qui utilise le tri par insertion pour les petits morceaux et qui est rapide sur des données en partie triées, ou introsort, un quicksort qui se rabat sur le tri par tas et utilise le tri par insertion pour les petites parties. Pour beaucoup de petites clés entières, le tri par comptage ou par base peut battre les deux. Le tri à bulles et le tri par sélection servent surtout à l'enseignement.
À vous de jouer
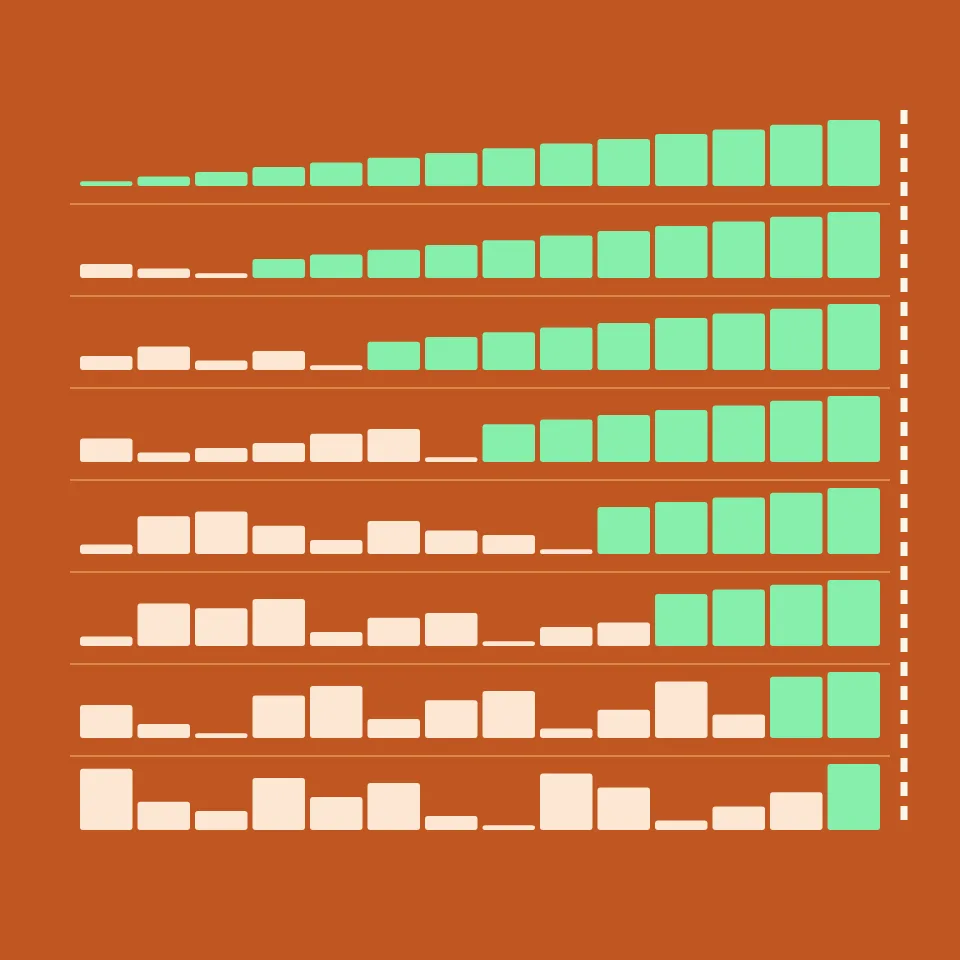
Ouvrez la Course des tris et appuyez sur Lecture. Chaque couloir est un tri sur la même liste ; le nombre à droite compte ses opérations, et un couloir devient vert quand il a fini. Essayez une liste presque triée, une liste inversée et peu de valeurs distinctes, et regardez l'ordre d'arrivée changer. Chaque tri a aussi sa propre application, où vous pouvez le suivre étape par étape.
Questions fréquemment posées
Quel est l'algorithme de tri le plus rapide ?
Pour des données quelconques, le quicksort et le tri fusion (et les hybrides qui en dérivent, comme introsort et Timsort) sont les plus rapides en moyenne, en n log n. Pour de petites clés entières, le tri par comptage et le tri par base sont encore plus rapides. Pour des listes courtes ou presque triées, le tri par insertion gagne.
Pourquoi aucun tri par comparaison ne peut-il battre n log n ?
Une liste de n valeurs peut être dans n! ordres, et chaque comparaison a deux issues : il faut donc au moins log₂(n!) comparaisons pour tous les distinguer dans le pire cas. Cela fait environ n log₂ n. Le tri par base et le tri par comptage échappent à cette limite, car ils ne comparent pas.
Quels algorithmes de tri sont stables ?
Le tri à bulles, par insertion, fusion, par base et par comptage sont stables dans leur forme habituelle. Le tri par sélection, le quicksort et le tri par tas ne le sont pas, car ils déplacent des valeurs sur de longues distances.
Quels tris demandent de la mémoire en plus ?
Le tri fusion, par base et par comptage ont besoin d'un tampon à peu près aussi long que la liste. Le tri à bulles, par sélection, par insertion et par tas n'en demandent presque pas, et le quicksort seulement un peu pour sa récursion.
Outils associés
Course des tris
Faites courir le tri à bulles, par sélection, par insertion, fusion, le quicksort, le tri par tas, par base et par comptage sur la même liste. Chaque comparaison, échange ou déplacement compte, et le tri qui travaille le moins gagne.
Tri à bulles
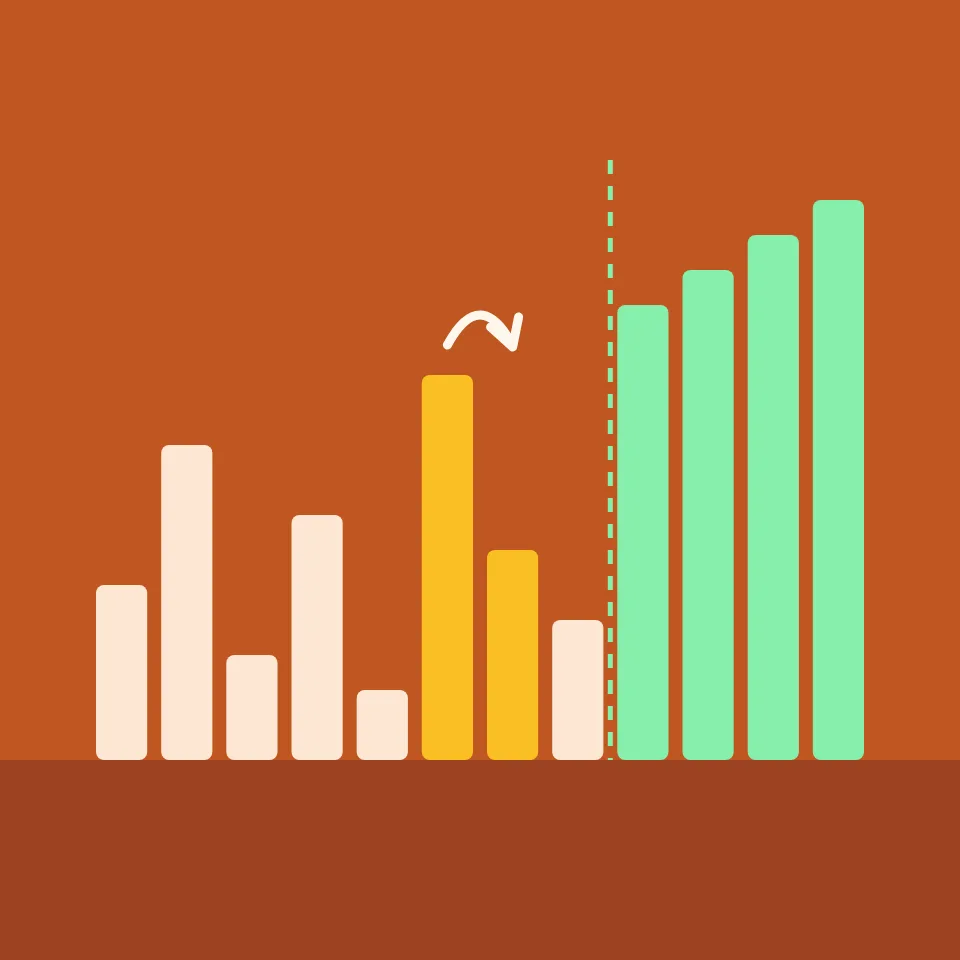
Regardez le tri à bulles pas à pas. Lancez, mettez en pause ou parcourez chaque comparaison et chaque échange, réglez la vitesse et comptez les comparaisons, les échanges et les passages.
Tri par insertion
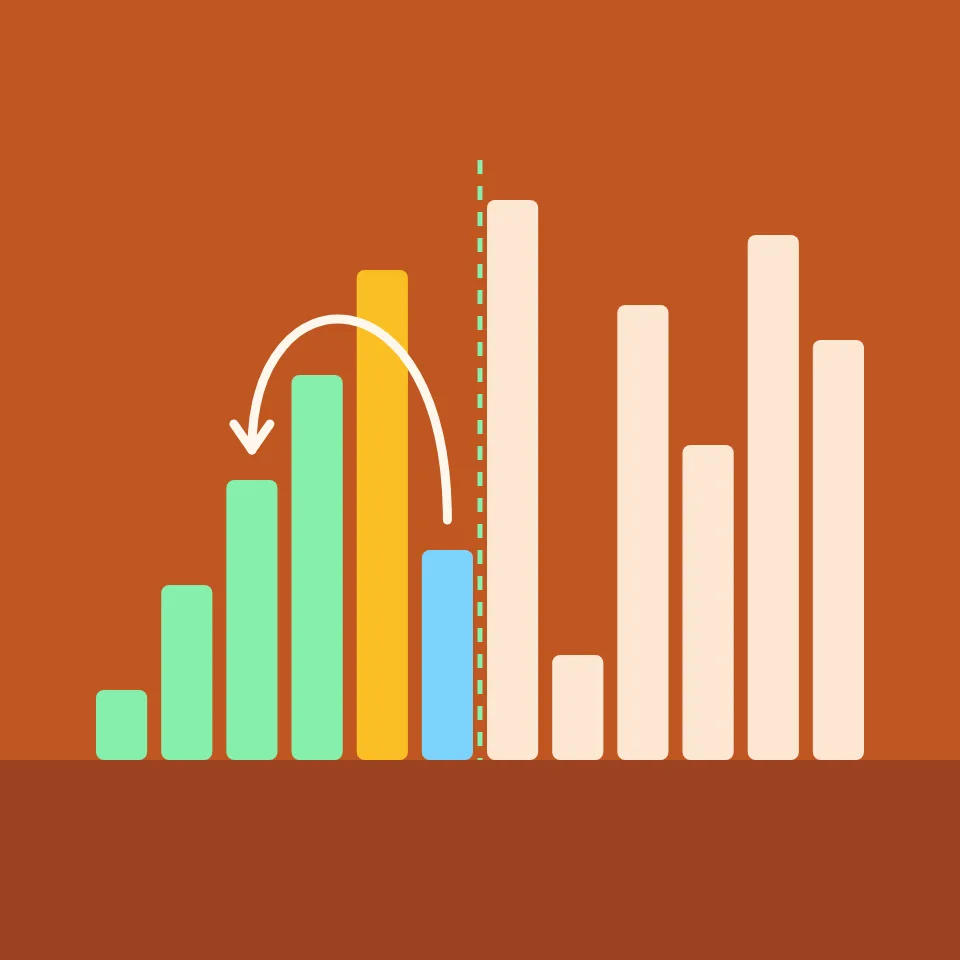
Suivez le tri par insertion étape par étape. Voyez chaque valeur reculer dans la partie triée, réglez la vitesse et comptez comparaisons, échanges et passages.
Tri fusion
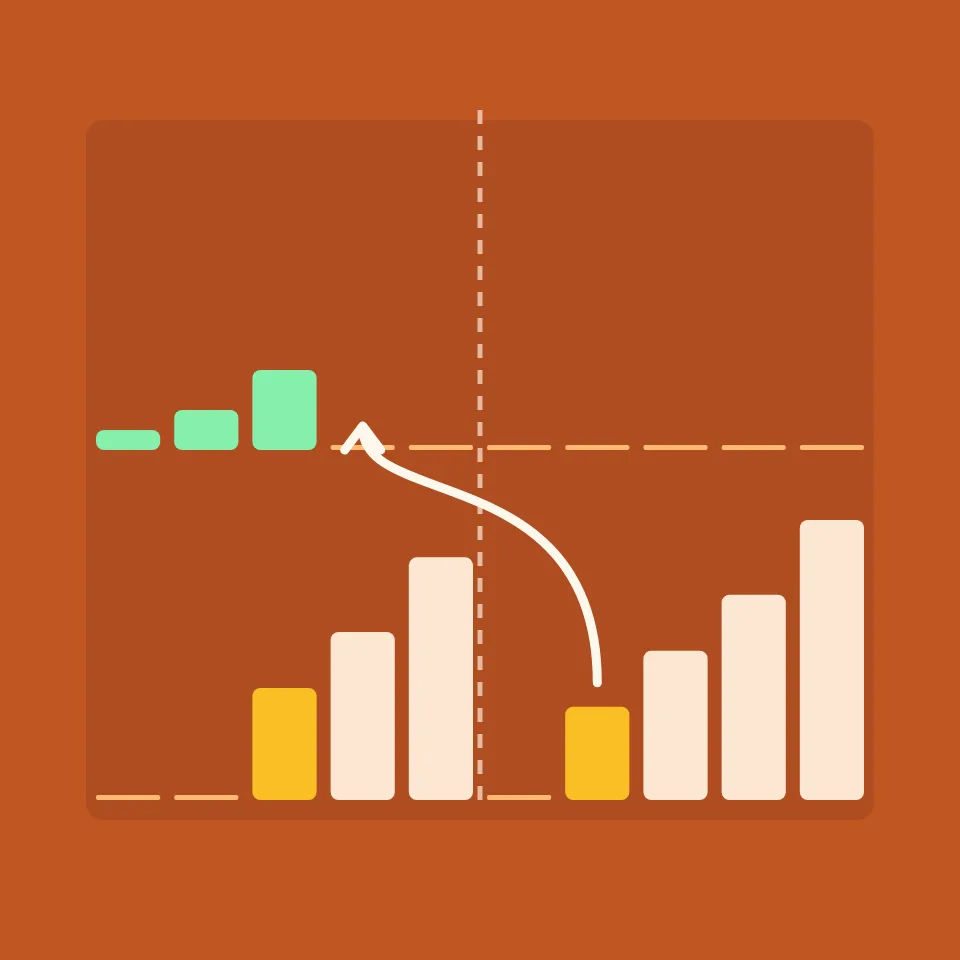
Suivez le tri fusion étape par étape. Voyez la liste coupée en deux puis les moitiés triées fusionnées, réglez la vitesse et comptez les comparaisons, les écritures et les fusions.
Quicksort
Suivez le quicksort étape par étape. Choisissez la règle du pivot, voyez chaque partition placer les valeurs plus petites avant le pivot, et comptez comparaisons, échanges et partitions.

Tri par tas
Suivez le tri par tas étape par étape. La liste devient un tas max, dessiné en arbre, puis la plus grande valeur est retirée du sommet, encore et encore, avec le décompte des comparaisons et des échanges.
Prêt à l'essayer ?
Ouvrez PictorX dans votre navigateur – aucune installation, aucune carte de crédit requise pour démarrer.
Lancer la Course des tris